Руководство по кластеризации Thunderbolt 5 в macOS Tahoe 26.2: Создайте свой собственный ИИ-суперкомпьютер
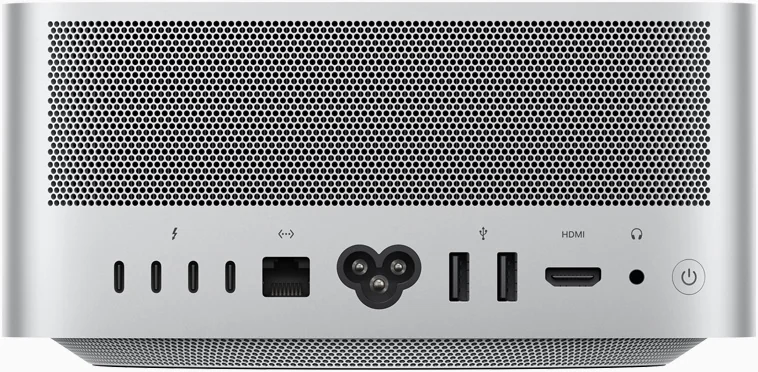
Полное руководство по созданию кластеров Mac с Thunderbolt 5 в macOS Tahoe 26.2. Изучите настройку фреймворка MLX, конфигурацию EXO, требования к оборудованию и запускайте ИИ-модели с триллионами параметров локально.
macOS Tahoe 26.2 представляет революционную функцию, которая превращает несколько компьютеров Mac в единый ИИ-суперкомпьютер с использованием кластеризации Thunderbolt 5. Это всеобъемлющее руководство охватывает все: от требований к оборудованию до запуска моделей с триллионами параметров, таких как Kimi K2 Thinking, на вашем собственном кластере Mac.
Ключевые выводы
- Кластеризация Thunderbolt 5 в macOS Tahoe 26.2 позволяет подключать несколько компьютеров Mac со скоростью до 80 Гбит/с в обоих направлениях
- Четыре Mac Studio с 512 ГБ каждый могут запускать модель Kimi K2 Thinking с 1 триллионом параметров, потребляя менее 500 Вт общей мощности
- Совместимые устройства включают M4 Pro Mac mini, M4 Pro/Max MacBook Pro и M3 Ultra Mac Studio
- Фреймворк MLX и программное обеспечение EXO 1.0 обеспечивают инфраструктуру распределенных вычислений
- Специальное оборудование не требуется - только стандартные кабели Thunderbolt 5 длиной менее 2 метров
Краткий обзор: Понимание технологии кластеризации Mac
Почему важна кластеризация Thunderbolt 5
Выпуск macOS Tahoe 26.2 знаменует собой поворотный момент в стратегии профессиональных вычислений Apple. Впервые Apple предоставляет встроенную, оптимизированную поддержку для объединения нескольких компьютеров Mac в единый вычислительный кластер с использованием беспрецедентной пропускной способности Thunderbolt 5. Это не просто постепенное улучшение — это фундаментально меняет возможности оборудования Mac.
Проблема, которую это решает:
Запуск больших моделей ИИ традиционно требовал дорогостоящих кластеров GPU с огромным энергопотреблением. Типичная установка для моделей с триллионами параметров может включать:
- Кластер NVIDIA H100: оборудование стоимостью более $400,000, энергопотребление более 10 кВт
- Облачные инстансы GPU: $2-5 в час за мощные инстансы
- Инфраструктура пользовательского дата-центра: охлаждение, распределение питания, сеть
Решение Mac Cluster:
С кластеризацией Thunderbolt 5 вы можете достичь сопоставимых возможностей с:
- 4x Mac Studio: оборудование за $47,000 (снижение затрат на 88% по сравнению с H100)
- Энергопотребление: менее 500 Вт (снижение на 95%)
- Отсутствие инфраструктуры: стандартная офисная среда
- Локальная обработка: полная конфиденциальность данных
Кто выигрывает от кластеризации Mac?
Исследователи ИИ и инженеры ML:
- Запускайте передовые модели локально без зависимости от облака
- Быстрее итерируйте с выделенным оборудованием
- Сохраняйте полный контроль над данными обучения
Творческие профессионалы:
- Распределенный рендеринг видео на нескольких компьютерах Mac
- Редактирование с помощью ИИ с локальными моделями
- Обработка больших файлов без задержек сети
Корпоративные ИТ-команды:
- Частные развертывания ИИ
- Инфраструктура с предсказуемыми затратами
- Упрощенное обслуживание по сравнению с кластерами GPU
Независимые разработчики:
- Создавайте приложения ИИ с локальным выводом
- Тестируйте на больших моделях во время разработки
- Выпускайте продукты без постоянных затрат на API
Что такое кластеризация Thunderbolt 5 Mac?
Эволюция распределенных вычислений на Mac
Кластеризация Thunderbolt 5 Mac представляет собой современное возрождение распределенных вычислений Apple на Mac. Давние пользователи Apple могут помнить Xgrid, который превращал коллекции компьютеров Mac в суперкомпьютеры. Новая кластеризация Thunderbolt 5 в macOS Tahoe 26.2 следует аналогичной концепции, но работает на значительно более высоких скоростях.
Исторический контекст:
- Эра Xgrid: Ограничена скоростями Ethernet (1-10 Гбит/с)
- Кластеры Thunderbolt 4: 40 Гбит/с, использование концентраторов снижало скорость до 10 Гбит/с
- Кластеры Thunderbolt 5: полные 80 Гбит/с в обоих направлениях, режим burst 120 Гбит/с
Как работает кластеризация Thunderbolt 5
Технология кластеризации использует удаленный прямой доступ к памяти (RDMA), позволяя одному Mac получать прямой доступ к памяти другого без нагрузки на процессор. Когда вы подключаете несколько компьютеров Mac через Thunderbolt 5:
- Объединение памяти: Объединенная память каждого Mac становится доступной для всего кластера
- Разделение модели: Большие модели ИИ пропорционально разделяются между машинами
- Параллельная обработка: Рабочие нагрузки распределяются на основе доступных ресурсов
- Связь с низкой задержкой: Прямой доступ к памяти устраняет узкие места сети
Пример конфигурации пула памяти:
| Конфигурация | Общая память | Вариант использования |
|---|---|---|
| 2x Mac Studio (512 ГБ) | 1 ТБ общей | Kimi K2 Thinking (594 ГБ) |
| 4x Mac Studio (512 ГБ) | 2 ТБ общей | Несколько моделей с триллионами параметров |
| 4x Mac mini M4 Pro (64 ГБ) | 256 ГБ общей | Модели с 70B-200B параметров |
Преимущество объединенной памяти Apple Silicon
Одной из ключевых причин эффективности кластеризации Mac является архитектура объединенной памяти Apple Silicon. В отличие от традиционных компьютеров, где GPU и CPU имеют отдельные пулы памяти, Apple Silicon разделяет память между всеми вычислительными блоками.
Преимущества объединенной памяти для кластеризации:
| Аспект | Традиционная архитектура | Apple Silicon |
|---|---|---|
| Доступ к памяти | GPU копирует данные из RAM | Прямой общий доступ |
| Пропускная способность | Ограничена PCIe (64 ГБ/с) | До 800 ГБ/с (M3 Ultra) |
| Эффективность | Требуется дублирование данных | Операции без копирования |
| Масштабируемость | VRAM ограничивает размер модели | Объединенный пул масштабируется линейно |
Когда вы объединяете несколько компьютеров Mac, вы фактически создаете больший пул объединенной памяти. Модель, которая слишком велика для памяти одного Mac, может быть разделена между узлами, при этом каждый Mac хранит часть и предоставляет доступ через Thunderbolt 5.
Практический пример:
- Один Mac Studio (512 ГБ): Может запускать модели до ~450 ГБ (оставляя запас)
- 2x Mac Studio (1 ТБ в пуле): Может запускать модели до ~900 ГБ
- 4x Mac Studio (2 ТБ в пуле): Может запускать модели до ~1.8 ТБ
Это линейное масштабирование делает возможным запуск моделей с триллионами параметров, таких как Kimi K2 Thinking, на оборудовании Mac.
Требования к оборудованию и совместимость
Совместимые модели Mac
Нативная поддержка Thunderbolt 5 (полные 80 Гбит/с):
| Устройство | Порты Thunderbolt 5 | Макс. память | Примечания |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 ГБ | Лучше всего для больших кластеров |
| Mac mini (M4 Pro) | 3 спереди | 64 ГБ | Экономичные узлы |
| MacBook Pro 14" (M4 Pro) | 3 | 48 ГБ | Портативная кластеризация |
| MacBook Pro 16" (M4 Max) | 3 | 128 ГБ | Портативный с большой памятью |
Важные характеристики:
- Скорость Thunderbolt 5: 80 Гбит/с в обоих направлениях (120 Гбит/с в режиме burst для видео)
- Пропускная способность памяти: M4 Pro обеспечивает 273 ГБ/с, M4 Max обеспечивает 546 ГБ/с
- Длина кабеля: Держите менее 2 метров для оптимальной производительности
- Тип кабеля: Стандартные кабели Thunderbolt 5 (совместимые с USB4 v2)
Рекомендуемые конфигурации кластера
Бюджетный кластер (Эксперименты с машинным обучением):
4x Mac mini M4 Pro (24 ГБ каждый)
Общая память: 96 ГБ
Стоимость: ~$7,200
Лучше всего для: Моделей до 70B параметров
Энергопотребление: ~60 Вт в простое, ~200 Вт пик
Уровень шума: Почти бесшумный
Эта конфигурация идеально подходит для разработчиков, изучающих распределенное ML, небольших команд, экспериментирующих с моделями с открытым исходным кодом, или запуска небольших моделей, таких как Llama 3.1 8B и Mistral 7B, с отличной производительностью.
Профессиональный кластер (Рабочие нагрузки ИИ в продакшене):
4x Mac mini M4 Pro (64 ГБ каждый)
Общая память: 256 ГБ
Стоимость: ~$13,200
Лучше всего для: Моделей до 200B параметров
Энергопотребление: ~80 Вт в простое, ~300 Вт пик
Уровень шума: Почти бесшумный
Профессиональный уровень открывает доступ к средне-крупным моделям, таким как Llama 3.1 70B, и может выполнять вывод на моделях корпоративного уровня. Это золотая середина для большинства компаний, развертывающих локальный ИИ.
Корпоративный кластер (Модели с триллионами параметров):
4x Mac Studio M3 Ultra (512 ГБ каждый)
Общая память: 2 ТБ
Стоимость: ~$47,000 (€47,000)
Лучше всего для: Kimi K2 Thinking, DeepSeek V3, передовых моделей
Энергопотребление: ~100 Вт в простое, ~500 Вт пик
Уровень шума: Умеренный под нагрузкой
Эта топовая конфигурация соответствует или превосходит кластеры GPU центров обработки данных для рабочих нагрузок вывода, потребляя при этом лишь часть энергии и не требуя специализированной инфраструктуры.
Руководство по выбору кабеля Thunderbolt 5
Выбор правильных кабелей имеет решающее значение для производительности кластера. Не все кабели поддерживают полные скорости Thunderbolt 5.
Рекомендуемые кабели:
| Кабель | Длина | Макс. скорость | Ценовой диапазон |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1 м | 120 Гбит/с | $69-79 |
| OWC Thunderbolt 5 | 0.8 м | 80 Гбит/с | $50-60 |
| CalDigit TB5 Cable | 1 м | 80 Гбит/с | $45-55 |
| Belkin Connect Pro | 1 м | 80 Гбит/с | $40-50 |
Советы по выбору кабеля:
- Придерживайтесь длины менее 1 метра: Полные 80 Гбит/с требуют коротких, высококачественных кабелей
- Ищите сертификацию USB4 v2: Гарантирует совместимость с Thunderbolt 5
- Избегайте адаптеров: Только прямые соединения TB5-TB5
- Покупайте у проверенных брендов: Поддельные кабели могут не достигать номинальных скоростей
- Тестируйте кабели перед развертыванием: Используйте
system_profiler SPThunderboltDataTypeдля проверки скорости соединения
Предупреждение: Многие кабели, продаваемые онлайн как "совместимые с Thunderbolt 5", достигают только скоростей Thunderbolt 4. Всегда проверяйте спецификации перед покупкой.
Программный стек: Фреймворки MLX и EXO
Понимание распределенных вычислений MLX
MLX — это открытый фреймворк массивов от Apple, разработанный специально для машинного обучения на Apple Silicon. Он обеспечивает нативную поддержку распределенных вычислений на нескольких компьютерах Mac.
Ключевые особенности MLX:
- Доступ к объединенной памяти: Использует архитектуру объединенной памяти Apple Silicon
- Ленивые вычисления: Вычисления выполняются только тогда, когда нужны результаты
- Динамическая компиляция: Компиляция «на лету» для оптимальной производительности
- Распределенные примитивы: Встроенная поддержка операций на нескольких машинах
Коммуникационные бэкенды MLX
MLX поддерживает три коммуникационных бэкенда для различных вариантов использования:
| Бэкенд | Скорость | Лучше всего для | Сложность настройки |
|---|---|---|---|
| Ring | Самый быстрый | Соединения Thunderbolt | Средняя |
| MPI | Быстрый | Сети Ethernet | Выше |
| NCCL | Н/Д | Среды CUDA | Н/Д на Mac |
Бэкенд Ring рекомендуется для кластеров Thunderbolt 5, так как он оптимизирован для прямых одноранговых соединений.
Понимание распределенного обучения и вывода
Прежде чем углубляться в настройку, важно понять два основных варианта использования кластеризации Mac:
Распределенный вывод (Запуск моделей): Это основной вариант использования для большинства пользователей. Когда вы запускаете вывод:
- Модель разделяется на несколько компьютеров Mac в зависимости от доступной памяти
- Каждый Mac хранит часть весов модели
- Во время генерации данные передаются между узлами по мере необходимости
- Обучение не происходит — вы используете предварительно обученную модель
Распределенное обучение (Создание моделей): Для исследователей и опытных пользователей:
- Обучающие данные разделяются между узлами (параллелизм данных)
- Градиенты усредняются по всем узлам после каждого батча
- Веса модели периодически синхронизируются
- Требуется значительно больше межвузловой коммуникации
| Вариант использования | Требование к пропускной способности | Сложность | Типичные пользователи |
|---|---|---|---|
| Вывод | Среднее (загрузка модели) | Низкая | Большинство пользователей |
| Дообучение (Fine-tuning) | Высокое (синхронизация градиентов) | Средняя | Инженеры ML |
| Полное обучение | Очень высокое (постоянная синхронизация) | Высокая | Исследователи |
Для большинства пользователей кластеров Mac вывод является основной целью — запуск больших моделей, которые не поместились бы на одной машине.
EXO: Упрощенное управление кластером
EXO (от Exo Labs) предоставляет абстракцию более высокого уровня для создания кластеров ИИ. Apple интегрировала протокол EXO в macOS Tahoe 26.2.
Ключевые особенности EXO:
- Автообнаружение: Автоматически обнаруживает другие устройства в сети
- Одноранговая архитектура: Нет иерархии мастер-воркер
- Интеллектуальное разделение: Оптимально разделяет модели на основе возможностей устройства
- ChatGPT-совместимый API: Совместимая с OpenAI конечная точка на
localhost:52415
Пошаговое руководство по настройке кластера
Предварительные условия
Перед началом убедитесь, что у вас есть:
- macOS Tahoe 26.2 или новее установлена на всех компьютерах Mac
- Кабели Thunderbolt 5 (менее 2 метров)
- Установлен Python 3.12+
- Настроен SSH без пароля между машинами
- Одна сеть для всех машин (для первоначального обнаружения)
Метод 1: Нативная настройка MLX (Рекомендуется)
Шаг 1: Установка MLX
# Установка MLX через pip
pip install mlx

# Проверка установки
python -c "import mlx.core as mx; print(mx.__version__)"
Шаг 2: Настройка сети Thunderbolt
Подключите ваши Mac в кольцевую топологию, используя кабели Thunderbolt 5:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1Используйте инструмент распределенной конфигурации MLX:
# Обнаружение кольца Thunderbolt и генерация конфигурации
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# Автонастройка всех узлов (требуется sudo без пароля)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
Шаг 3: Создание конфигурации файла хостов
Создайте файл ring-4.json:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
Шаг 4: Тестирование распределенной связи
Создайте тестовый скрипт test_distributed.py:
import mlx.core as mx

# Инициализация распределенной группы
world = mx.distributed.init()

# Каждый процесс создает массив со своим рангом
x = mx.ones(10) * world.rank()

# Суммирование массивов по всем процессам
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
Запустите тест:
mlx.launch --hostfile ring-4.json test_distributed.pyОжидаемый вывод (4 узла):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Метод 2: Настройка EXO (Удобно для пользователя)
Шаг 1: Клонирование и установка EXO
# Клонирование репозитория
git clone https://github.com/exo-explore/exo.git
cd exo

# Установка зависимостей
pip install -e .

# Или используйте скрипт установки
source install.sh
Шаг 2: Настройка MLX для Apple Silicon
# Запуск скрипта конфигурации MLX
./configure_mlx.sh
Это оптимизирует распределение памяти GPU на компьютерах Mac с Apple Silicon.
Шаг 3: Запуск кластера
На каждом узле выполните одну и ту же команду:
exoEXO выполнит следующее:
- Автоматически обнаружит другие узлы через одноранговую связь
- Применит взвешенное разделение памяти по кольцу
- Запустит веб-интерфейс на
http://localhost:52415 - Запустит конечную точку API на
http://localhost:52415/v1/chat/completions
Шаг 4: Доступ к интерфейсу
Откройте браузер по адресу http://localhost:52415, чтобы получить интерфейс, похожий на ChatGPT, для взаимодействия с вашим кластером.
Запуск больших языковых моделей
Загрузка моделей
EXO поддерживает различные источники моделей:
# Загрузка с Hugging Face
exo download moonshotai/Kimi-K2-Instruct

# Загрузка моделей Llama
exo download meta-llama/Llama-3.1-70B-Instruct
Требования к памяти по моделям
| Модель | Параметры | Требуемая память | Рекомендуемый кластер |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 ГБ | Один Mac |
| Llama 3.1 70B | 70B | 140 ГБ | 3x Mac mini (64 ГБ) |
| Llama 3.1 405B | 405B | 810 ГБ | 4x Mac Studio (512 ГБ) |
| Kimi K2 | 1T (32B активных) | 594 ГБ | 2x Mac Studio (512 ГБ) |
| Kimi K2 Thinking | 1T (32B активных) | 594 ГБ | 2x Mac Studio (512 ГБ) |
Запуск Kimi K2 Thinking
Модель Kimi K2 Thinking демонстрирует мощь кластеризации Thunderbolt 5. Это модель Mixture-of-Experts (MoE) с 1 триллионом параметров, из которых 32 миллиарда являются активными. Разработанная Moonshot AI, она представляет собой передовой край моделей рассуждения с открытым исходным кодом.
Что делает Kimi K2 особенной:
- Архитектура: Mixture-of-Experts (MoE) с 1T общих параметров
- Активные параметры: Только 32B параметров активны при каждом выводе
- Контекстное окно: 256K токенов
- Квантование: Нативное INT4 для эффективности
- Размер на диске: ~594 ГБ (против 1 ТБ+ для полной точности)
import mlx.core as mx
from mlx_lm import load, generate

# Инициализация распределенной среды
world = mx.distributed.init()

# Загрузка модели (автоматически распределяется по узлам)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# Генерация текста
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
Результаты производительности (4x Mac Studio M3 Ultra):
- Общая память: 2 ТБ объединенной
- Энергопотребление: Менее 500 Вт (против 5,000 Вт+ для кластера GPU)
- Генерация токенов: Конкурентоспособна с облачным выводом
- Экономическая эффективность: В 10 раз меньше энергии, чем у кластера NVIDIA RTX 5090
Оптимизация производительности
Лучшие практики топологии сети
Кольцевая топология (Рекомендуется для 4+ узлов):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
Топология звезда (Простые 2-3 узла):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3Рекомендации по кабелям и подключению
| Фактор | Рекомендация | Влияние |
|---|---|---|
| Длина кабеля | Менее 2 метров | Поддерживает полные 80 Гбит/с |
| Качество кабеля | Сертифицированный TB5/USB4 v2 | Предотвращает ошибки данных |
| Избегайте хабов | Прямые соединения | Хабы снижают скорость до 10 Гбит/с |
| Выбор порта | Используйте все доступные | Максимизирует пропускную способность |
Балансировка памяти и вычислений
При создании гетерогенного кластера (смешанное оборудование):
# MLX автоматически балансирует на основе возможностей устройства
# Но вы можете настроить разделение:

import mlx.core as mx

# Получение информации о распределенном мире
world = mx.distributed.init()

# Пользовательское назначение весов
weights = {
    0: 2.0,  # Mac Studio получает 2x долю
    1: 1.0,  # Mac mini получает 1x долю
    2: 1.0,
    3: 1.0
}
Устранение распространенных проблем
Проблемы с подключением
Проблема: Узлы не обнаруживают друг друга
# Проверка статуса соединения Thunderbolt
system_profiler SPThunderboltDataType

# Проверка сетевых интерфейсов
networksetup -listallhardwareports

# Тест прямого подключения
ping mac2.local
Проблема: Медленная скорость передачи
# Тест пропускной способности Thunderbolt
iperf3 -c mac2.local -p 5201

# Ожидается: ~9-10 ГБ/с для TB5
# Если ниже: проверьте длину/качество кабеля
Ошибки MLX
Проблема: "No distributed backend available"
# Убедитесь, что MLX установлен правильно
pip install --upgrade mlx

# Проверьте версию Python (требуется 3.12+)
python --version
Проблема: "Out of memory" при распределенном выводе
# Включение режима экономии памяти
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # Использовать 95% доступной памяти

# Или уменьшить размер батча
generate(model, tokenizer, prompt=prompt, max_tokens=100)
Настройка SSH
Обеспечьте SSH без пароля между всеми узлами:
# Генерация SSH-ключа, если необходимо
ssh-keygen -t ed25519

# Копирование на все узлы
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# Тест
ssh mac2.local "hostname"
Энергоэффективность и анализ затрат
Сравнение энергопотребления
| Конфигурация | Энергопотребление | Производительность | $/Производительность |
|---|---|---|---|
| 4x Mac Studio (512 ГБ) | ~500 Вт | Способен на триллион параметров | Лучшая |
| Кластер NVIDIA H100 (4x) | ~2,800 Вт | Аналогичная способность | в 5.6x больше энергии |
| Кластер NVIDIA RTX 5090 | ~2,300 Вт | Ограниченная VRAM | в 4.6x больше энергии |
Общая стоимость владения (TCO)
Кластер Mac Studio (Конфигурация 2 ТБ):
- Оборудование: $47,000
- Электричество в год (24/7): ~$500
- Обслуживание: Минимальное
- TCO за 5 лет: ~$49,500
Эквивалентный кластер GPU:
- Оборудование: $100,000+
- Электричество в год (24/7): ~$3,000
- Инфраструктура охлаждения: $10,000+
- Обслуживание: Значительное
- TCO за 5 лет: ~$130,000+
Варианты использования и приложения
Исследования машинного обучения
Кластеризация Thunderbolt 5 превосходно подходит для академических и корпоративных исследований ML:
Приложения для исследований:
- Обучение моделей: Распределенное обучение на нескольких компьютерах Mac с синхронизацией градиентов
- Дообучение (Fine-Tuning): Локальное дообучение больших моделей на собственных наборах данных
- Вывод: Локальный запуск моделей с триллионами параметров для экспериментов
- Исследования абляции: Быстрое прототипирование без ожидания доступности облачных GPU
Пример рабочего процесса исследования:
import mlx.core as mx
from mlx_lm import load, generate

# Загрузка вашей дообученной модели
model, tokenizer = load("./my-finetuned-model")

# Запуск экспериментов на распределенном кластере
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
Университеты и исследовательские лаборатории выигрывают от:
- Фиксированных затрат на оборудование по сравнению с непредсказуемыми счетами за облако
- Полной конфиденциальности данных для чувствительных исследований
- Учебных ресурсов для курсов по распределенным вычислениям
- Воспроизводимых экспериментов, готовых к публикации
Профессиональные творческие рабочие процессы
Интеграция с творческой экосистемой Apple предоставляет уникальные преимущества:
Видеопроизводство:
- Распределенный рендеринг: Проекты Final Cut Pro, DaVinci Resolve, Motion
- Редактирование с помощью ИИ: Локальные модели ИИ для обнаружения сцен, транскрипции
- Цветокоррекция: Ускоренная GPU обработка цвета на узлах
- Обработка 8K RAW: Достаточная память для больших видеофайлов
Аудиопроизводство:
- Распределенная обработка Logic Pro: Рендеринг плагинов на узлах
- Генерация музыки ИИ: Запуск локальных музыкальных моделей ИИ
- Реставрация аудио: Снижение шума на основе ML локально
3D и моушн-графика:
- Распределенный рендеринг Blender: Рендеринг Cycles на кластере Mac
- Cinema 4D: Рендеринг CPU с поддержкой кластера
- Houdini: Распределение симуляции (с соответствующими плагинами)
Подробнее о творческих рабочих процессах читайте в нашем Руководстве по революции профессиональных рабочих процессов macOS Tahoe.
Разработка и тестирование
Современная разработка приложений ИИ значительно выигрывает от локальных кластеров:
Разработка приложений на базе ИИ:
# Пример: Создание ИИ-чатбота с локальным выводом
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
Преимущества для разработчиков:
- Локальная разработка LLM: Тестируйте и итерируйте без ограничений скорости API
- Ускорение CI/CD: Распределенные системы сборки и тестирования
- Разработка приложений ИИ: Создавайте приложения с локальными бэкендами ИИ
- Бесплатные эксперименты: Отсутствие платы за запрос во время разработки
Преимущества тестирования:
- Тестирование на моделях производственного масштаба локально
- Отсутствие задержек сети в тестовых средах
- Согласованные, воспроизводимые результаты тестов
- Полный контроль над версиями моделей
Ознакомьтесь с нашим Руководством по настройке разработчика macOS Tahoe для конфигурации среды разработки.
Сценарии корпоративного развертывания
Крупные организации развертывают кластеры Mac для:
Внутренние ИИ-ассистенты:
- Частные интерфейсы в стиле ChatGPT
- Анализ и резюмирование документов
- Обзор и генерация кода
- Транскрипция и анализ встреч
Отрасли, чувствительные к соблюдению требований:
- Здравоохранение: Обработка ИИ, соответствующая HIPAA
- Финансы: Локальный вывод моделей
- Юриспруденция: Анализ конфиденциальных документов
- Правительство: Изолированные (air-gapped) возможности ИИ
Анализ затрат и выгод для предприятий:
| Сценарий | Стоимость облака/год | Стоимость кластера Mac/год | Экономия |
|---|---|---|---|
| Легкий (1M токенов/день) | ~$11,000 | ~$3,000 (амортизировано) | 73% |
| Средний (10M токенов/день) | ~$110,000 | ~$15,000 (амортизировано) | 86% |
| Тяжелый (100M токенов/день) | ~$1.1M | ~$60,000 (амортизировано) | 95% |
Будущее кластеризации Mac
M5 и далее
Чип Apple M5 представляет нейронные ускорители в каждом ядре GPU, обеспечивая 4-кратное улучшение производительности ИИ. В сочетании с кластеризацией Thunderbolt 5:
- Улучшенная поддержка MLX: Полный доступ к нейронным ускорителям M5
- Улучшенная пропускная способность памяти: 153 ГБ/с на чип
- Лучшая энергоэффективность: Больше производительности на ватт
Последствия для Mac Pro
Согласно отчетам, Apple "в значительной степени списала Mac Pro" внутри компании. Кластеризация Thunderbolt 5 предоставляет альтернативный путь:
- Масштабируемая производительность: Добавляйте узлы по мере необходимости
- Более низкая стоимость входа: Начните с малого, расширяйтесь позже
- Гибкость: Смешивайте разные модели Mac
- Задел на будущее: Обновляйте отдельные узлы со временем
Соображения безопасности и конфиденциальности
Почему важна локальная обработка
Одним из самых значительных преимуществ кластеризации Mac перед облачным ИИ является полная конфиденциальность данных. Ваши промпты, обучающие данные и сгенерированные выходные данные никогда не покидают вашу локальную сеть.
Преимущества конфиденциальности:
- Нет передачи данных: Вся обработка происходит локально
- Удобство соблюдения требований: Более легкое соблюдение HIPAA, GDPR, SOC2
- Защита IP: Собственные данные остаются частными
- Нет проблем с логированием: Полный контроль над журналами использования
Лучшие практики безопасности для кластеров Mac:
- Изоляция сети: Держите ваш кластер в выделенном VLAN
- Конфигурация брандмауэра: Блокируйте внешний доступ к портам кластера
- Управление ключами SSH: Используйте ключи ed25519, регулярно меняйте их
- Безопасность macOS: Включите FileVault, обновляйте системы
- Физическая безопасность: Защитите доступ в серверную комнату
Для полной конфигурации безопасности macOS ознакомьтесь с нашим Руководством по безопасности и конфиденциальности macOS Tahoe.
Реальные тесты производительности
Сравнение скорости вывода
На основе тестирования сообщества и демонстраций Apple:
| Модель | Конфигурация | Токенов/Секунда | Сравнение |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 ГБ) | ~35 ток/с | Сопоставимо с RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 ГБ) | ~15 ток/с | Превосходит облачный A100 |
| Kimi K2 | 2x Mac Studio (512 ГБ) | ~20 ток/с | Первый локальный триллион параметров |
| DeepSeek V3 | 4x Mac Studio (512 ГБ) | ~12 ток/с | Ранее только в облаке |
Анализ задержки
| Метрика | Кластер Mac | Облачный API | Разница |
|---|---|---|---|
| Первый токен | 100-500мс | 500-2000мс | В 2-10 раз быстрее |
| Стабильная задержка | Да | Переменная | Более предсказуемая |
| Холодный старт | Нет | 5-30с | Нет ожидания |
| Доступность | 100% (локально) | 99.9% | Нет сбоев |
Сравнение стоимости за токен
При условии работы 24/7 в течение 1 года:
| Решение | Стоимость оборудования | Операционные расходы | Всего за 1 год | Стоимость/1M токенов |
|---|---|---|---|---|
| Кластер 4x Mac Studio | $47,000 | ~$500 | $47,500 | ~$0.02 |
| OpenAI GPT-4 | $0 | На основе использования | Переменная | ~$30.00 |
| Claude API | $0 | На основе использования | Переменная | ~$15.00 |
| AWS Bedrock | $0 | На основе использования | Переменная | ~$10.00 |
Для активных пользователей (>100M токенов/год) локальная кластеризация Mac становится значительно более экономичной.
Часто задаваемые вопросы (FAQ)
Сколько компьютеров Mac я могу подключить в кластер?
Практический предел зависит от вашей топологии. С прямыми соединениями Thunderbolt (избегая концентраторов) вы можете эффективно подключить 4-6 компьютеров Mac. Использование кольцевой топологии позволяет масштабироваться до большего количества узлов, сохраняя полную пропускную способность. За пределами 6 узлов вам потребуется тщательное планирование топологии, чтобы избежать узких мест пропускной способности.
Нужны ли мне идентичные Mac для кластеризации?
Нет, MLX и EXO поддерживают гетерогенные кластеры. Однако кластер будет ограничен самым медленным компонентом. Для достижения наилучших результатов используйте Mac аналогичного поколения с соответствующими версиями Thunderbolt. Распределение памяти будет взвешено по доступной оперативной памяти каждого узла.
Могу ли я использовать Mac с Thunderbolt 4 в кластере?
Да, но пропускная способность этих соединений будет ограничена 40 Гбит/с. Thunderbolt 5 и 4 обратно совместимы. Система будет работать на более низкой скорости при смешивании поколений. Для лучшей производительности держите узлы TB4 как листовые узлы, а не в середине кольца.
Каков минимальный объем памяти, необходимый для кластеризации?
Общая память кластера должна превышать требования к памяти вашей модели с некоторым запасом для операций. Для Llama 3.1 70B (модель 140 ГБ) вам нужно как минимум 3 Mac с 48 ГБ каждый (всего 144 ГБ). Мы рекомендуем 10-20% запаса сверх размера модели.
Подходит ли кластеризация Mac для обучения или только для вывода?
И для того, и для другого! MLX поддерживает распределенное обучение с усреднением градиентов по узлам. Однако вывод является основным вариантом использования из-за преимуществ объединения памяти для больших моделей. Обучение требует большего межвузлового взаимодействия и более чувствительно к задержкам сети.
Как это соотносится с облачными инстансами GPU?
Для длительного использования (более 6 месяцев регулярного использования) кластеризация Mac более экономична. Вы владеете оборудованием, не платите почасовую плату и получаете конкурентоспособную производительность. Для эпизодического использования или экспериментов облачные инстансы могут быть более экономичными на начальном этапе.
Могу ли я запускать кластер 24/7?
Абсолютно. Оборудование Mac разработано для непрерывной работы. Mac Studio, в частности, имеют отличное управление температурой для длительных рабочих нагрузок. Контролируйте температуру с помощью Activity Monitor или sudo powermetrics и обеспечьте достаточную вентиляцию.
Что произойдет, если один узел выйдет из строя?
В настоящее время кластеризация MLX не поддерживает горячую замену или автоматический переход на другой ресурс. Если узел отключается, задание завершится с ошибкой и его потребуется перезапустить. Для критических рабочих нагрузок реализуйте контрольные точки в вашем коде, чтобы возобновить работу с последнего сохраненного состояния.
Могу ли я использовать кластер во время выполнения рабочих нагрузок ИИ?
Да, но производительность может пострадать. Интерфейс EXO позволяет работать в фоновом режиме, пока вы используете Mac для других задач. Для наилучшей производительности вывода минимизируйте другие активности во время тяжелых рабочих нагрузок ИИ.
Заключение
Кластеризация Thunderbolt 5 в macOS Tahoe 26.2 представляет собой смену парадигмы в локальных вычислениях ИИ. Объединяя несколько компьютеров Mac в единый суперкомпьютер, пользователи могут запускать модели с триллионами параметров за долю стоимости традиционных кластеров GPU.
Ключевые преимущества:
- Энергопотребление в 10 раз ниже, чем у альтернатив на GPU
- Не требуется специализированное оборудование
- Простая настройка с MLX и EXO
- Масштабируемость от 2 до 6+ узлов
- Локальная, частная обработка ИИ
Для пользователей, инвестировавших в экосистему Apple, одна эта функция может оправдать обновление до macOS Tahoe 26.2. Ознакомьтесь с нашим Руководством по обновлению macOS Tahoe 26.2 для полных инструкций по обновлению.
Готовы оптимизировать свой Mac для рабочих нагрузок ИИ? Начните с нашего Руководства по управлению хранилищем macOS Tahoe, чтобы убедиться, что у вас достаточно места для больших моделей.
Источники
- ML в macOS Tahoe получает ускорение благодаря GPU и кластеризации Thunderbolt 5 - Apple Insider, ноябрь 2025
- Вы можете превратить кластер Mac в ИИ-суперкомпьютер в macOS Tahoe 26.2 - Engadget, ноябрь 2025
- Кластер из Mac Studio — это лишь одна из причин, почему нам больше не нужен Mac Pro - 9to5Mac, ноябрь 2025
- Кластер ИИ: Четыре Mac с 2 ТБ могут запускать гигантскую модель Kimi K2 Thinking - Heise Online, ноябрь 2025
- Документация по распределенной связи MLX - Официальная документация Apple MLX
- EXO: Запустите свой собственный кластер ИИ дома - EXO Labs GitHub
- Изучение больших языковых моделей на Apple silicon с MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Официальный сайт Moonshot AI