Guía de clústeres Thunderbolt 5 en macOS Tahoe 26.2: Construya su propia supercomputadora de IA
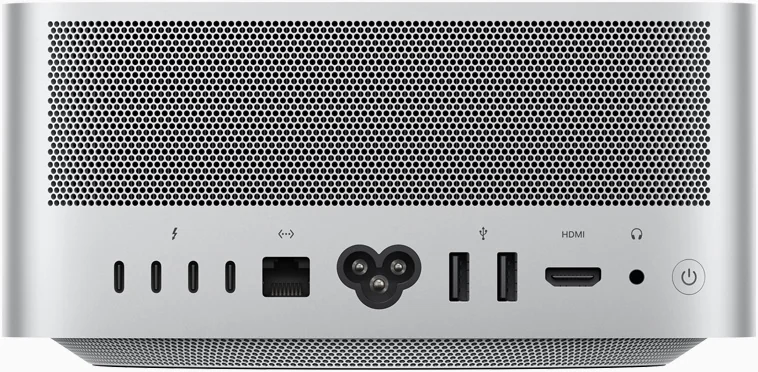
Guía completa para construir clústeres Mac con Thunderbolt 5 en macOS Tahoe 26.2. Aprenda la configuración del marco MLX, la configuración de EXO, los requisitos de hardware y ejecute modelos de IA de billones de parámetros localmente.
macOS Tahoe 26.2 introduce una característica revolucionaria que transforma múltiples Mac en una supercomputadora de IA unificada utilizando clústeres Thunderbolt 5. Esta guía completa cubre todo, desde los requisitos de hardware hasta la ejecución de modelos de billones de parámetros como Kimi K2 Thinking en su propio clúster de Mac.
Puntos clave
- El clúster Thunderbolt 5 en macOS Tahoe 26.2 permite conectar múltiples Mac a una velocidad bidireccional de hasta 80 Gbps
- Cuatro Mac Studio con 512 GB cada uno pueden ejecutar el modelo Kimi K2 Thinking de 1 billón de parámetros utilizando menos de 500 W de potencia total
- Los dispositivos compatibles incluyen el Mac mini M4 Pro, MacBook Pro M4 Pro/Max y Mac Studio M3 Ultra
- El marco MLX y el software EXO 1.0 proporcionan la infraestructura de computación distribuida
- No se requiere hardware especial - solo cables estándar Thunderbolt 5 de menos de 2 metros
Resumen ejecutivo: Entendiendo la tecnología de clústeres Mac
Por qué es importante el clúster Thunderbolt 5
El lanzamiento de macOS Tahoe 26.2 marca un momento crucial en la estrategia de computación profesional de Apple. Por primera vez, Apple proporciona soporte nativo y optimizado para conectar múltiples Mac en un clúster de computación unificado utilizando el ancho de banda sin precedentes de Thunderbolt 5. Esto no es solo una mejora incremental: cambia fundamentalmente lo que es posible con el hardware Mac.
El problema que resuelve:
La ejecución de grandes modelos de IA ha requerido tradicionalmente costosos clústeres de GPU con un consumo masivo de energía. Una configuración típica para modelos de billones de parámetros podría incluir:
- Clúster NVIDIA H100: Hardware de más de $400,000, consumo de energía de más de 10kW
- Instancias de GPU en la nube: $2-5 por hora para instancias capaces
- Infraestructura de centro de datos personalizada: Refrigeración, distribución de energía, redes
La solución del clúster Mac:
Con el clúster Thunderbolt 5, puede lograr capacidades comparables con:
- 4x Mac Studio: Hardware de $47,000 (88% de reducción de costos vs H100)
- Consumo de energía: Menos de 500 W (95% de reducción)
- Sin infraestructura: Entorno de oficina estándar
- Procesamiento local: Privacidad de datos completa
¿Quién se beneficia del clúster Mac?
Investigadores de IA e ingenieros de ML:
- Ejecute modelos de frontera localmente sin dependencias de la nube
- Itere más rápido con hardware dedicado
- Mantenga un control total sobre los datos de entrenamiento
Profesionales creativos:
- Renderizado de video distribuido a través de múltiples Mac
- Edición asistida por IA con modelos locales
- Procesamiento de archivos grandes sin latencia de red
Equipos de TI empresariales:
- Implementaciones de IA privadas
- Infraestructura de costo predecible
- Mantenimiento simplificado en comparación con los clústeres de GPU
Desarrolladores independientes:
- Construya aplicaciones de IA con inferencia local
- Pruebe contra modelos grandes durante el desarrollo
- Envíe productos sin costos continuos de API
¿Qué es el clúster Thunderbolt 5 Mac?
La evolución de la computación distribuida en Mac
El clúster Thunderbolt 5 Mac representa el renacimiento moderno de Apple de la computación distribuida en Mac. Los usuarios de Apple de larga data pueden recordar Xgrid, que convertía colecciones de Mac en supercomputadoras. El nuevo clúster Thunderbolt 5 en macOS Tahoe 26.2 sigue un concepto similar pero opera a velocidades dramáticamente más altas.
Contexto histórico:
- Era Xgrid: Limitada a velocidades de Ethernet (1-10 Gbps)
- Clústeres Thunderbolt 4: 40 Gbps, el uso de concentradores reducía las velocidades a 10 Gbps
- Clústeres Thunderbolt 5: 80 Gbps bidireccionales completos, modo ráfaga de 120 Gbps
Cómo funciona el clúster Thunderbolt 5
La tecnología de clúster utiliza Acceso directo a memoria remota (RDMA), permitiendo que un Mac acceda directamente a la memoria de otro sin sobrecarga de CPU. Cuando conecta múltiples Mac a través de Thunderbolt 5:
- Agrupación de memoria: La memoria unificada de cada Mac se vuelve accesible para todo el clúster
- Particionamiento del modelo: Los grandes modelos de IA se dividen proporcionalmente entre las máquinas
- Procesamiento paralelo: Las cargas de trabajo se distribuyen según los recursos disponibles
- Comunicación de baja latencia: El acceso directo a la memoria elimina los cuellos de botella de la red
Ejemplo de configuración de grupo de memoria:
| Configuración | Memoria total | Caso de uso |
|---|---|---|
| 2x Mac Studio (512 GB) | 1 TB compartido | Kimi K2 Thinking (594 GB) |
| 4x Mac Studio (512 GB) | 2 TB compartido | Múltiples modelos de billones de parámetros |
| 4x Mac mini M4 Pro (64 GB) | 256 GB compartido | Modelos de 70B-200B parámetros |
Ventaja de la memoria unificada de Apple Silicon
Una razón clave por la que el clúster Mac es tan efectivo radica en la arquitectura de memoria unificada de Apple Silicon. A diferencia de las computadoras tradicionales donde la GPU y la CPU tienen grupos de memoria separados, Apple Silicon comparte la memoria entre todas las unidades de procesamiento.
Beneficios de la memoria unificada para el clúster:
| Aspecto | Arquitectura tradicional | Apple Silicon |
|---|---|---|
| Acceso a memoria | La GPU copia datos de la RAM | Acceso compartido directo |
| Ancho de banda | Limitado por PCIe (64 GB/s) | Hasta 800 GB/s (M3 Ultra) |
| Eficiencia | Se requiere duplicación de datos | Operaciones de cero copia |
| Escalabilidad | VRAM limita el tamaño del modelo | El grupo unificado escala linealmente |
Cuando agrupa múltiples Mac, está creando efectivamente un grupo de memoria unificada más grande. Un modelo que es demasiado grande para la memoria de un Mac se puede dividir entre nodos, con cada Mac manteniendo una porción y compartiendo el acceso a través de Thunderbolt 5.
Ejemplo práctico:
- Mac Studio único (512 GB): Puede ejecutar modelos de hasta ~450 GB (dejando margen)
- 2x Mac Studio (1 TB agrupado): Puede ejecutar modelos de hasta ~900 GB
- 4x Mac Studio (2 TB agrupado): Puede ejecutar modelos de hasta ~1.8 TB
Esta escala lineal es lo que hace factibles los modelos de billones de parámetros como Kimi K2 Thinking en hardware Mac.
Requisitos de hardware y compatibilidad
Modelos de Mac compatibles
Soporte nativo Thunderbolt 5 (80 Gbps completos):
| Dispositivo | Puertos Thunderbolt 5 | Memoria máx. | Notas |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 GB | Mejor para clústeres grandes |
| Mac mini (M4 Pro) | 3 frontales | 64 GB | Nodos rentables |
| MacBook Pro 14" (M4 Pro) | 3 | 48 GB | Clúster portátil |
| MacBook Pro 16" (M4 Max) | 3 | 128 GB | Portátil de alta memoria |
Especificaciones importantes:
- Velocidad Thunderbolt 5: 80 Gbps bidireccional (120 Gbps modo ráfaga para video)
- Ancho de banda de memoria: M4 Pro ofrece 273 GB/s, M4 Max ofrece 546 GB/s
- Longitud del cable: Mantener por debajo de 2 metros para un rendimiento óptimo
- Tipo de cable: Cables estándar Thunderbolt 5 (compatibles con USB4 v2)
Configuraciones de clúster recomendadas
Clúster económico (Experimentación de aprendizaje automático):
4x Mac mini M4 Pro (24 GB cada uno)
Memoria total: 96 GB compartidos
Costo: ~$7,200
Mejor para: Modelos de hasta 70B parámetros
Consumo de energía: ~60W inactivo, ~200W pico
Nivel de ruido: Casi silencioso
Esta configuración es perfecta para desarrolladores que aprenden ML distribuido, pequeños equipos que experimentan con modelos de código abierto o ejecutan modelos más pequeños como Llama 3.1 8B y Mistral 7B con un rendimiento excelente.
Clúster profesional (Cargas de trabajo de IA de producción):
4x Mac mini M4 Pro (64 GB cada uno)
Memoria total: 256 GB compartidos
Costo: ~$13,200
Mejor para: Modelos de hasta 200B parámetros
Consumo de energía: ~80W inactivo, ~300W pico
Nivel de ruido: Casi silencioso
El nivel profesional desbloquea modelos medianos-grandes como Llama 3.1 70B y puede ejecutar inferencia en modelos de grado empresarial. Este es el punto ideal para la mayoría de las empresas que implementan IA local.
Clúster empresarial (Modelos de billones de parámetros):
4x Mac Studio M3 Ultra (512 GB cada uno)
Memoria total: 2 TB compartidos
Costo: ~$47,000 (€47,000)
Mejor para: Kimi K2 Thinking, DeepSeek V3, modelos de frontera
Consumo de energía: ~100W inactivo, ~500W pico
Nivel de ruido: Moderado bajo carga
Esta configuración de primer nivel iguala o supera a los clústeres de GPU de centros de datos para cargas de trabajo de inferencia mientras consume una fracción de la energía y no requiere infraestructura especializada.
Guía de selección de cables Thunderbolt 5
Elegir los cables correctos es crítico para el rendimiento del clúster. No todos los cables admiten velocidades completas de Thunderbolt 5.
Cables recomendados:
| Cable | Longitud | Velocidad máx. | Rango de precios |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbps | $69-79 |
| OWC Thunderbolt 5 | 0.8m | 80 Gbps | $50-60 |
| CalDigit TB5 Cable | 1m | 80 Gbps | $45-55 |
| Belkin Connect Pro | 1m | 80 Gbps | $40-50 |
Consejos para la selección de cables:
- Manténgase por debajo de 1 metro: Los 80 Gbps completos requieren cables cortos y de alta calidad
- Busque la certificación USB4 v2: Garantiza la compatibilidad con Thunderbolt 5
- Evite adaptadores: Solo conexiones directas TB5 a TB5
- Compre de marcas de renombre: Los cables de imitación pueden no alcanzar las velocidades nominales
- Pruebe los cables antes de la implementación: Use
system_profiler SPThunderboltDataTypepara verificar la velocidad del enlace
Advertencia: Muchos cables vendidos en línea como "compatibles con Thunderbolt 5" solo alcanzan velocidades de Thunderbolt 4. Verifique siempre las especificaciones antes de comprar.
Pila de software: Marcos MLX y EXO
Entendiendo la computación distribuida MLX
MLX es el marco de matriz de código abierto de Apple diseñado específicamente para el aprendizaje automático en Apple Silicon. Proporciona soporte nativo para la computación distribuida a través de múltiples Mac.
Características clave de MLX:
- Acceso a memoria unificada: Aprovecha la arquitectura de memoria unificada de Apple Silicon
- Evaluación perezosa: Los cálculos solo se ejecutan cuando se necesitan resultados
- Compilación dinámica: Compilación justo a tiempo para un rendimiento óptimo
- Primitivas distribuidas: Soporte integrado para operaciones multi-máquina
Backends de comunicación MLX
MLX admite tres backends de comunicación para diferentes casos de uso:
| Backend | Velocidad | Mejor para | Complejidad de configuración |
|---|---|---|---|
| Ring | Más rápido | Conexiones Thunderbolt | Media |
| MPI | Rápido | Redes Ethernet | Mayor |
| NCCL | N/A | Entornos CUDA | N/A en Mac |
Se recomienda el backend Ring para clústeres Thunderbolt 5, ya que está optimizado para conexiones directas de igual a igual.
Entendiendo el entrenamiento distribuido vs inferencia
Antes de sumergirse en la configuración, es importante entender los dos casos de uso principales para el clúster Mac:
Inferencia distribuida (Ejecución de modelos): Este es el caso de uso principal para la mayoría de los usuarios. Cuando ejecuta inferencia:
- El modelo se divide en múltiples Mac según la memoria disponible
- Cada Mac contiene una porción de los pesos del modelo
- Durante la generación, los datos fluyen entre los nodos según sea necesario
- No ocurre entrenamiento: está utilizando un modelo pre-entrenado
Entrenamiento distribuido (Creación de modelos): Para investigadores y usuarios avanzados:
- Los datos de entrenamiento se dividen entre nodos (paralelismo de datos)
- Los gradientes se promedian en todos los nodos después de cada lote
- Los pesos del modelo se sincronizan periódicamente
- Requiere significativamente más comunicación entre nodos
| Caso de uso | Requisito de ancho de banda | Complejidad | Usuarios típicos |
|---|---|---|---|
| Inferencia | Medio (carga del modelo) | Baja | La mayoría de los usuarios |
| Ajuste fino | Alto (sincronización de gradientes) | Media | Ingenieros de ML |
| Entrenamiento completo | Muy alto (sincronización constante) | Alta | Investigadores |
Para la mayoría de los usuarios de clústeres Mac, la inferencia es el objetivo principal: ejecutar modelos grandes que no cabrían en una sola máquina.
EXO: Gestión de clústeres simplificada
EXO (de Exo Labs) proporciona una abstracción de nivel superior para construir clústeres de IA. Apple ha integrado el protocolo de EXO en macOS Tahoe 26.2.
Características clave de EXO:
- Autodescubrimiento: Detecta automáticamente otros dispositivos en la red
- Arquitectura de igual a igual: Sin jerarquía maestro-trabajador
- Particionamiento inteligente: Divide óptimamente los modelos según las capacidades del dispositivo
- API compatible con ChatGPT: Punto final compatible con OpenAI en
localhost:52415
Guía paso a paso de configuración del clúster
Requisitos previos
Antes de comenzar, asegúrese de tener:
- macOS Tahoe 26.2 o posterior instalado en todos los Mac
- Cables Thunderbolt 5 (menos de 2 metros)
- Python 3.12+ instalado
- SSH sin contraseña configurado entre máquinas
- Misma red para todas las máquinas (para el descubrimiento inicial)
Método 1: Configuración nativa MLX (Recomendado)
Paso 1: Instalar MLX
# Instalar MLX a través de pip
pip install mlx

# Verificar instalación
python -c "import mlx.core as mx; print(mx.__version__)"
Paso 2: Configurar red Thunderbolt
Conecte sus Mac en una topología de anillo utilizando cables Thunderbolt 5:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1Utilice la herramienta de configuración distribuida MLX:
# Descubrir anillo Thunderbolt y generar configuración
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# Autoconfigurar todos los nodos (requiere sudo sin contraseña)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
Paso 3: Crear configuración de archivo host
Cree un archivo ring-4.json:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
Paso 4: Probar comunicación distribuida
Cree un script de prueba test_distributed.py:
import mlx.core as mx

# Inicializar grupo distribuido
world = mx.distributed.init()

# Cada proceso crea una matriz con su rango
x = mx.ones(10) * world.rank()

# Sumar matrices a través de todos los procesos
result = mx.distributed.all_sum(x)

print(f"Rango {world.rank()}: suma = {result}")
Inicie la prueba:
mlx.launch --hostfile ring-4.json test_distributed.pySalida esperada (4 nodos):
Rango 0: suma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rango 1: suma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rango 2: suma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rango 3: suma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Método 2: Configuración EXO (Fácil de usar)
Paso 1: Clonar e instalar EXO
# Clonar el repositorio
git clone https://github.com/exo-explore/exo.git
cd exo

# Instalar dependencias
pip install -e .

# O usar el script de instalación
source install.sh
Paso 2: Configurar MLX para Apple Silicon
# Ejecutar el script de configuración MLX
./configure_mlx.sh
Esto optimiza la asignación de memoria GPU en Mac con Apple Silicon.
Paso 3: Iniciar el clúster
En cada nodo, ejecute el mismo comando:
exoEXO:
- Descubrirá automáticamente otros nodos a través de comunicación peer-to-peer
- Aplicará particionamiento ponderado de memoria en anillo
- Iniciará la interfaz web en
http://localhost:52415 - Iniciará el punto final de API en
http://localhost:52415/v1/chat/completions
Paso 4: Acceder a la interfaz
Abra su navegador en http://localhost:52415 para una interfaz tipo ChatGPT para interactuar con su clúster.
Ejecución de modelos de lenguaje grandes
Descarga de modelos
EXO admite varias fuentes de modelos:
# Descargar desde Hugging Face
exo download moonshotai/Kimi-K2-Instruct

# Descargar modelos Llama
exo download meta-llama/Llama-3.1-70B-Instruct
Requisitos de memoria por modelo
| Modelo | Parámetros | Memoria requerida | Clúster recomendado |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 GB | Mac único |
| Llama 3.1 70B | 70B | 140 GB | 3x Mac mini (64 GB) |
| Llama 3.1 405B | 405B | 810 GB | 4x Mac Studio (512 GB) |
| Kimi K2 | 1T (32B activos) | 594 GB | 2x Mac Studio (512 GB) |
| Kimi K2 Thinking | 1T (32B activos) | 594 GB | 2x Mac Studio (512 GB) |
Ejecución de Kimi K2 Thinking
El modelo Kimi K2 Thinking demuestra el poder del clúster Thunderbolt 5. Es un modelo de mezcla de expertos (MoE) de 1 billón de parámetros con 32 mil millones de parámetros activos. Desarrollado por Moonshot AI, representa la vanguardia de los modelos de razonamiento de código abierto.
Qué hace especial a Kimi K2:
- Arquitectura: Mezcla de expertos (MoE) con 1T parámetros totales
- Parámetros activos: Solo 32B parámetros activos por inferencia
- Ventana de contexto: 256K tokens
- Cuantización: INT4 nativo para eficiencia
- Tamaño en disco: ~594 GB (vs 1 TB+ para precisión completa)
import mlx.core as mx
from mlx_lm import load, generate

# Inicializar entorno distribuido
world = mx.distributed.init()

# Cargar modelo (distribuido automáticamente entre nodos)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# Generar texto
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
Resultados de rendimiento (4x Mac Studio M3 Ultra):
- Memoria total: 2 TB unificada
- Consumo de energía: Menos de 500 W (vs 5,000 W+ para clúster de GPU)
- Generación de tokens: Competitivo con inferencia en la nube
- Eficiencia de costos: 10x menos energía que el clúster NVIDIA RTX 5090
Optimización del rendimiento
Mejores prácticas de topología de red
Topología de anillo (Recomendada para 4+ nodos):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
Topología de estrella (Simple 2-3 nodos):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3Pautas de cable y conexión
| Factor | Recomendación | Impacto |
|---|---|---|
| Longitud del cable | Menos de 2 metros | Mantiene 80 Gbps completos |
| Calidad del cable | Certificado TB5/USB4 v2 | Previene errores de datos |
| Evitar concentradores | Conexiones directas | Los concentradores reducen a 10 Gbps |
| Selección de puerto | Usar todos los disponibles | Maximiza el ancho de banda |
Equilibrio de memoria y computación
Al construir un clúster heterogéneo (hardware mixto):
# MLX equilibra automáticamente según las capacidades del dispositivo
# Pero puede personalizar el particionamiento:

import mlx.core as mx

# Obtener información del mundo distribuido
world = mx.distributed.init()

# Asignación de peso personalizada
weights = {
    0: 2.0,  # Mac Studio obtiene 2x participación
    1: 1.0,  # Mac mini obtiene 1x participación
    2: 1.0,
    3: 1.0
}
Solución de problemas comunes
Problemas de conexión
Problema: Los nodos no se descubren entre sí
# Verificar estado de conexión Thunderbolt
system_profiler SPThunderboltDataType

# Verificar interfaces de red
networksetup -listallhardwareports

# Probar conectividad directa
ping mac2.local
Problema: Velocidades de transferencia lentas
# Probar ancho de banda Thunderbolt
iperf3 -c mac2.local -p 5201

# Esperado: ~9-10 GB/s para TB5
# Si es menor: verificar longitud/calidad del cable
Errores MLX
Problema: "No hay backend distribuido disponible"
# Asegurar que MLX esté instalado correctamente
pip install --upgrade mlx

# Verificar versión de Python (requiere 3.12+)
python --version
Problema: "Memoria insuficiente" en inferencia distribuida
# Habilitar modo eficiente en memoria
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # Usar 95% de memoria disponible

# O reducir tamaño del lote
generate(model, tokenizer, prompt=prompt, max_tokens=100)
Configuración SSH
Asegure SSH sin contraseña entre todos los nodos:
# Generar clave SSH si es necesario
ssh-keygen -t ed25519

# Copiar a todos los nodos
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# Probar
ssh mac2.local "hostname"
Eficiencia energética y análisis de costos
Comparación de consumo de energía
| Configuración | Consumo de energía | Rendimiento | $/Rendimiento |
|---|---|---|---|
| 4x Mac Studio (512 GB) | ~500 W | Capaz de billones de parámetros | Mejor |
| Clúster NVIDIA H100 (4x) | ~2,800 W | Capacidad similar | 5.6x más energía |
| Clúster NVIDIA RTX 5090 | ~2,300 W | VRAM limitada | 4.6x más energía |
Costo total de propiedad (TCO)
Clúster Mac Studio (Configuración 2 TB):
- Hardware: $47,000
- Energía anual (24/7): ~$500
- Mantenimiento: Mínimo
- TCO a 5 años: ~$49,500
Clúster de GPU equivalente:
- Hardware: $100,000+
- Energía anual (24/7): ~$3,000
- Infraestructura de refrigeración: $10,000+
- Mantenimiento: Significativo
- TCO a 5 años: ~$130,000+
Casos de uso y aplicaciones
Investigación de aprendizaje automático
El clúster Thunderbolt 5 sobresale para la investigación académica y corporativa de ML:
Aplicaciones de investigación:
- Entrenamiento de modelos: Entrenamiento distribuido en múltiples Mac con sincronización de gradientes
- Ajuste fino: Ajuste fino local de modelos grandes en conjuntos de datos propietarios
- Inferencia: Ejecución de modelos de billones de parámetros localmente para experimentación
- Estudios de ablación: Creación rápida de prototipos sin esperar la disponibilidad de GPU en la nube
Ejemplo de flujo de trabajo de investigación:
import mlx.core as mx
from mlx_lm import load, generate

# Cargar su modelo ajustado
model, tokenizer = load("./my-finetuned-model")

# Ejecutar experimentos en clúster distribuido
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
Las universidades y laboratorios de investigación se benefician de:
- Costos de hardware fijos frente a facturación en la nube impredecible
- Privacidad de datos completa para investigaciones sensibles
- Recursos de enseñanza para cursos de computación distribuida
- Experimentos reproducibles listos para publicación
Flujos de trabajo creativos profesionales
La integración con el ecosistema creativo de Apple proporciona ventajas únicas:
Producción de video:
- Renderizado distribuido: Proyectos de Final Cut Pro, DaVinci Resolve, Motion
- Edición asistida por IA: Modelos de IA locales para detección de escenas, transcripción
- Corrección de color: Procesamiento de color acelerado por GPU en nodos
- Procesamiento RAW 8K: Memoria suficiente para archivos de video grandes
Producción de audio:
- Procesamiento distribuido de Logic Pro: Renderizado de complementos en nodos
- Generación de música con IA: Ejecutar modelos de IA de música locales
- Restauración de audio: Reducción de ruido basada en ML localmente
3D y gráficos en movimiento:
- Renderizado distribuido de Blender: Renderizado Cycles en clúster Mac
- Cinema 4D: Renderizado de CPU con soporte de clúster
- Houdini: Distribución de simulación (con complementos apropiados)
Para obtener más información sobre los flujos de trabajo creativos, consulte nuestra Guía de la revolución del flujo de trabajo profesional de macOS Tahoe.
Desarrollo y pruebas
El desarrollo moderno de aplicaciones de IA se beneficia significativamente de los clústeres locales:
Desarrollo de aplicaciones impulsadas por IA:
# Ejemplo: Construcción de un chatbot de IA con inferencia local
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
Beneficios para desarrolladores:
- Desarrollo local de LLM: Pruebe e itere sin límites de velocidad de API
- Aceleración de CI/CD: Sistemas de construcción y prueba distribuidos
- Desarrollo de aplicaciones de IA: Construya aplicaciones con backends de IA locales
- Experimentación sin costo: Sin cargos por solicitud durante el desarrollo
Ventajas de las pruebas:
- Pruebe contra modelos a escala de producción localmente
- Sin latencia de red en entornos de prueba
- Resultados de prueba consistentes y reproducibles
- Control total sobre las versiones del modelo
Consulte nuestra Guía de configuración para desarrolladores de macOS Tahoe para la configuración del entorno de desarrollo.
Escenarios de implementación empresarial
Las grandes organizaciones están implementando clústeres Mac para:
Asistentes de IA internos:
- Interfaces privadas estilo ChatGPT
- Análisis y resumen de documentos
- Revisión y generación de código
- Transcripción y análisis de reuniones
Industrias sensibles al cumplimiento:
- Atención médica: Procesamiento de IA compatible con HIPAA
- Finanzas: Inferencia de modelos locales
- Legal: Análisis de documentos confidenciales
- Gobierno: Capacidades de IA aisladas (air-gapped)
Análisis de costo-beneficio para empresas:
| Escenario | Costo de nube/Año | Costo de clúster Mac/Año | Ahorro |
|---|---|---|---|
| Ligero (1M tokens/día) | ~$11,000 | ~$3,000 (amortizado) | 73% |
| Medio (10M tokens/día) | ~$110,000 | ~$15,000 (amortizado) | 86% |
| Pesado (100M tokens/día) | ~$1.1M | ~$60,000 (amortizado) | 95% |
Futuro del clúster Mac
M5 y más allá
El chip Apple M5 introduce aceleradores neuronales en cada núcleo de GPU, ofreciendo una mejora de rendimiento de IA 4x. Cuando se combina con el clúster Thunderbolt 5:
- Soporte MLX mejorado: Acceso total a los aceleradores neuronales M5
- Ancho de banda de memoria mejorado: 153 GB/s por chip
- Mejor eficiencia energética: Más rendimiento por vatio
Implicaciones para Mac Pro
Según los informes, Apple ha "descartado en gran medida el Mac Pro" internamente. El clúster Thunderbolt 5 proporciona un camino alternativo:
- Rendimiento escalable: Agregue nodos según sea necesario
- Costo de entrada más bajo: Comience pequeño, expanda más tarde
- Flexibilidad: Mezcle diferentes modelos de Mac
- Preparado para el futuro: Actualice nodos individuales con el tiempo
Consideraciones de seguridad y privacidad
Por qué es importante el procesamiento local
Una de las ventajas más significativas del clúster Mac sobre la IA basada en la nube es la privacidad completa de los datos. Sus indicaciones, datos de entrenamiento y salidas generadas nunca abandonan su red local.
Beneficios de privacidad:
- Sin transmisión de datos: Todo el procesamiento ocurre localmente
- Favorable al cumplimiento: Cumplimiento más fácil de HIPAA, GDPR, SOC2
- Protección de PI: Los datos propietarios permanecen privados
- Sin preocupaciones de registro: Control total sobre los registros de uso
Mejores prácticas de seguridad para clústeres Mac:
- Aislamiento de red: Mantenga su clúster en una VLAN dedicada
- Configuración de firewall: Bloquee el acceso externo a los puertos del clúster
- Gestión de claves SSH: Use claves ed25519, rote regularmente
- Seguridad de macOS: Habilite FileVault, mantenga los sistemas actualizados
- Seguridad física: Asegure el acceso a la sala de servidores
Para una configuración de seguridad integral de macOS, consulte nuestra Guía de seguridad y privacidad de macOS Tahoe.
Puntos de referencia de rendimiento del mundo real
Comparación de velocidad de inferencia
Basado en pruebas comunitarias y demostraciones de Apple:
| Modelo | Configuración | Tokens/Segundo | Comparación |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 GB) | ~35 tok/s | Comparable a RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 GB) | ~15 tok/s | Supera a la nube A100 |
| Kimi K2 | 2x Mac Studio (512 GB) | ~20 tok/s | Primer billón de parámetros local |
| DeepSeek V3 | 4x Mac Studio (512 GB) | ~12 tok/s | Anteriormente solo en la nube |
Análisis de latencia
| Métrica | Clúster Mac | API en la nube | Diferencia |
|---|---|---|---|
| Primer token | 100-500ms | 500-2000ms | 2-10x más rápido |
| Latencia consistente | Sí | Variable | Más predecible |
| Arranque en frío | Ninguno | 5-30s | Sin espera |
| Disponibilidad | 100% (local) | 99.9% | Sin interrupciones |
Comparación de costo por token
Asumiendo operación 24/7 durante 1 año:
| Solución | Costo de hardware | Costo operativo | Total 1 año | Costo/1M Tokens |
|---|---|---|---|---|
| Clúster 4x Mac Studio | $47,000 | ~$500 | $47,500 | ~$0.02 |
| OpenAI GPT-4 | $0 | Basado en uso | Variable | ~$30.00 |
| Claude API | $0 | Basado en uso | Variable | ~$15.00 |
| AWS Bedrock | $0 | Basado en uso | Variable | ~$10.00 |
Para usuarios intensivos (>100M tokens/año), el clúster Mac local se vuelve significativamente más económico.
Preguntas frecuentes
¿Cuántos Mac puedo conectar en un clúster?
El límite práctico depende de su topología. Con conexiones Thunderbolt directas (evitando concentradores), puede conectar 4-6 Mac de manera eficiente. El uso de una topología de anillo permite escalar a más nodos manteniendo el ancho de banda completo. Más allá de 6 nodos, necesitará una planificación cuidadosa de la topología para evitar cuellos de botella de ancho de banda.
¿Necesito Mac idénticos para el clúster?
No, MLX y EXO admiten clústeres heterogéneos. Sin embargo, el clúster estará limitado por el componente más lento. Para obtener los mejores resultados, use Mac de generación similar con versiones de Thunderbolt coincidentes. La distribución de la memoria se ponderará por la RAM disponible de cada nodo.
¿Puedo usar Mac con Thunderbolt 4 en un clúster?
Sí, pero el ancho de banda se limitará a 40 Gbps en esas conexiones. Thunderbolt 5 y 4 son compatibles con versiones anteriores. El sistema funcionará a la velocidad más baja al mezclar generaciones. Para un mejor rendimiento, mantenga los nodos TB4 como nodos hoja en lugar de en medio de un anillo.
¿Cuál es la memoria mínima necesaria para el clúster?
La memoria total del clúster debe exceder el requisito de memoria de su modelo con algo de margen para operaciones. Para Llama 3.1 70B (modelo de 140 GB), necesita al menos 3 Mac con 48 GB cada uno (144 GB en total). Recomendamos un margen de 10-20% por encima del tamaño del modelo.
¿Es el clúster Mac adecuado para entrenamiento o solo inferencia?
¡Ambos! MLX admite entrenamiento distribuido con promedio de gradientes entre nodos. Sin embargo, la inferencia es el caso de uso principal debido a los beneficios de la agrupación de memoria para modelos grandes. El entrenamiento requiere más comunicación entre nodos y es más sensible a la latencia de la red.
¿Cómo se compara esto con las instancias de GPU en la nube?
Para uso a largo plazo (más de 6 meses de uso regular), el clúster Mac es más rentable. Usted es dueño del hardware, no tiene cargos por hora y logra un rendimiento competitivo. Para uso ocasional o experimentación, las instancias en la nube pueden ser más económicas inicialmente.
¿Puedo ejecutar el clúster 24/7?
Absolutamente. El hardware Mac está diseñado para un funcionamiento continuo. Los Mac Studio en particular tienen una excelente gestión térmica para cargas de trabajo sostenidas. Monitoree las temperaturas usando el Monitor de Actividad o sudo powermetrics y asegure una ventilación adecuada.
¿Qué sucede si falla un nodo?
Actualmente, el clúster MLX no admite intercambio en caliente ni conmutación por error automática. Si un nodo se desconecta, el trabajo fallará y deberá reiniciarse. Para cargas de trabajo críticas, implemente puntos de control en su código para reanudar desde el último estado guardado.
¿Puedo usar el clúster mientras ejecuto cargas de trabajo de IA?
Sí, pero el rendimiento puede verse afectado. La interfaz EXO permite la operación en segundo plano mientras usa los Mac para otras tareas. Para obtener el mejor rendimiento de inferencia, minimice otras actividades durante cargas de trabajo de IA pesadas.
Conclusión
El clúster Thunderbolt 5 de macOS Tahoe 26.2 representa un cambio de paradigma en la computación de IA local. Al combinar múltiples Mac en una supercomputadora unificada, los usuarios pueden ejecutar modelos de billones de parámetros a una fracción de los costos de los clústeres de GPU tradicionales.
Beneficios clave:
- Consumo de energía 10 veces menor que las alternativas de GPU
- No se requiere hardware especializado
- Configuración simple con MLX y EXO
- Escalable de 2 a 6+ nodos
- Procesamiento de IA local y privado
Para los usuarios invertidos en el ecosistema de Apple, esta característica por sí sola puede justificar la actualización a macOS Tahoe 26.2. Consulte nuestra Guía de actualización de macOS Tahoe 26.2 para obtener instrucciones completas de actualización.
¿Listo para optimizar su Mac para cargas de trabajo de IA? Comience con nuestra Guía de gestión de almacenamiento de macOS Tahoe para asegurarse de tener el espacio adecuado para modelos grandes.
Fuentes
- ML en macOS Tahoe obtiene impulso de GPU y clúster Thunderbolt 5 - Apple Insider, noviembre de 2025
- Puedes convertir un clúster de Macs en una supercomputadora de IA en macOS Tahoe 26.2 - Engadget, noviembre de 2025
- Un clúster de Mac Studios es solo una razón por la que ya no necesitamos un Mac Pro - 9to5Mac, noviembre de 2025
- Clúster de IA: Cuatro Macs con 2 TB pueden ejecutar el modelo gigante Kimi K2 Thinking - Heise Online, noviembre de 2025
- Documentación de comunicación distribuida de MLX - Documentos oficiales de Apple MLX
- EXO: Ejecute su propio clúster de IA en casa - EXO Labs GitHub
- Explore modelos de lenguaje grandes en Apple silicon con MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Oficial Moonshot AI