macOS Tahoe 26.2 Thunderbolt 5 集群指南:构建你自己的 AI 超级计算机
macOS Tahoe 26.2 中使用 Thunderbolt 5 构建 Mac 集群的完整指南。了解 MLX 框架设置、EXO 配置、硬件要求,并在本地运行万亿参数 AI 模型。
macOS Tahoe 26.2 引入了一项革命性的功能,它利用 Thunderbolt 5 集群技术将多台 Mac 转换为统一的 AI 超级计算机。本综合指南涵盖了从硬件要求到在您自己的 Mac 集群上运行 Kimi K2 Thinking 等万亿参数模型的方方面面。
核心要点
- macOS Tahoe 26.2 中的 Thunderbolt 5 集群技术 支持以高达 80 Gbps 双向速度连接多台 Mac
- 四台配备 512GB 内存的 Mac Studio 可以运行 1 万亿参数的 Kimi K2 Thinking 模型,总功耗低于 500W
- 兼容设备 包括 M4 Pro Mac mini、M4 Pro/Max MacBook Pro 和 M3 Ultra Mac Studio
- MLX 框架 和 EXO 1.0 软件提供分布式计算基础设施
- 无需特殊硬件 —— 仅需 2 米以下的标准 Thunderbolt 5 连接线
执行摘要:了解 Mac 集群技术
为什么 Thunderbolt 5 集群至关重要
macOS Tahoe 26.2 的发布标志着 Apple 专业计算策略的一个关键时刻。Apple 首次通过 Thunderbolt 5 前所未有的带宽,为将多台 Mac 连接成统一的计算集群提供了原生、优化的支持。这不仅仅是渐进式的改进,它从根本上改变了 Mac 硬件的潜力。
它解决了什么问题:
运行大型 AI 模型传统上需要昂贵的 GPU 集群,并伴随着巨大的功耗。万亿参数模型的典型设置可能包括:
- NVIDIA H100 集群:40 万美元以上的硬件,10kW 以上的功耗
- 云 GPU 实例:每小时 2-5 美元,适用于高性能实例
- 定制数据中心基础设施:散热、配电、网络
Mac 集群解决方案:
通过 Thunderbolt 5 集群,您可以以相似的功能实现以下目标:
- 4x Mac Studio:47,000 美元的硬件(相对于 H100 成本降低 88%)
- 功耗:低于 500W(降低 95%)
- 无需基础设施:标准办公环境
- 本地处理:完整的数据隐私
谁将从 Mac 集群中受益?
AI 研究人员和 ML 工程师:
- 在本地运行前沿模型,无需依赖云服务
- 通过专用硬件更快地迭代
- 完全控制训练数据
创意专业人士:
- 跨多台 Mac 进行分布式视频渲染
- 使用本地模型进行 AI 辅助编辑
- 无网络延迟的大文件处理
企业 IT 团队:
- 私有 AI 部署
- 成本可预测的基础设施
- 相较于 GPU 集群,维护更简单
独立开发者:
- 使用本地推理构建 AI 应用程序
- 在开发过程中针对大型模型进行测试
- 交付产品无需持续的 API 成本
什么是 Thunderbolt 5 Mac 集群?
Mac 分布式计算的演进
Thunderbolt 5 Mac 集群代表了 Apple 在 Mac 上分布式计算的现代复兴。资深的 Apple 用户可能还记得 Xgrid,它能将多台 Mac 组合成超级计算机。macOS Tahoe 26.2 中新的 Thunderbolt 5 集群沿袭了类似的概念,但运行速度 dramatically 更快。
历史背景:
- Xgrid 时代:受限于以太网速度 (1-10 Gbps)
- Thunderbolt 4 集群:40 Gbps,使用集线器时速度降至 10 Gbps
- Thunderbolt 5 集群:全速 80 Gbps 双向,120 Gbps 爆发模式
Thunderbolt 5 集群如何工作
该集群技术采用 远程直接内存访问 (RDMA),允许一台 Mac 直接访问另一台 Mac 的内存,而无需 CPU 开销。当您通过 Thunderbolt 5 连接多台 Mac 时:
- 内存池化:每台 Mac 的统一内存都可供整个集群访问
- 模型分区:大型 AI 模型按比例拆分到不同的机器上
- 并行处理:工作负载根据可用资源进行分配
- 低延迟通信:直接内存访问消除了网络瓶颈
内存池配置示例:
| 配置 | 总内存 | 用例 |
|---|---|---|
| 2x Mac Studio (512GB) | 1TB 共享 | Kimi K2 Thinking (594GB) |
| 4x Mac Studio (512GB) | 2TB 共享 | 多个万亿参数模型 |
| 4x Mac mini M4 Pro (64GB) | 256GB 共享 | 70B-200B 参数模型 |
Apple 芯片统一内存优势
Mac 集群如此高效的一个关键原因在于 Apple 芯片的统一内存架构。与 GPU 和 CPU 具有独立内存池的传统计算机不同,Apple 芯片在所有处理单元之间共享内存。
统一内存对集群的优势:
| 方面 | 传统架构 | Apple 芯片 |
|---|---|---|
| 内存访问 | GPU 从 RAM 复制数据 | 直接共享访问 |
| 带宽 | 受限于 PCIe (64 GB/s) | 高达 800 GB/s (M3 Ultra) |
| 效率 | 需要数据复制 | 零拷贝操作 |
| 可扩展性 | VRAM 限制模型大小 | 统一内存池线性扩展 |
当您集群多台 Mac 时,您实际上是在创建一个更大的统一内存池。对于一台 Mac 内存来说过大的模型可以拆分到不同节点上,每台 Mac 拥有一部分,并通过 Thunderbolt 5 共享访问。
实际案例:
- 单台 Mac Studio (512GB):可运行高达约 450GB 的模型(预留空间)
- 2x Mac Studio (1TB 池化):可运行高达约 900GB 的模型
- 4x Mac Studio (2TB 池化):可运行高达约 1.8TB 的模型
这种线性扩展使得像 Kimi K2 Thinking 这样的万亿参数模型在 Mac 硬件上变得可行。
硬件要求和兼容性
兼容的 Mac 型号
Thunderbolt 5 原生支持 (全速 80 Gbps):
| 设备 | Thunderbolt 5 端口 | 最大内存 | 备注 |
|---|---|---|---|
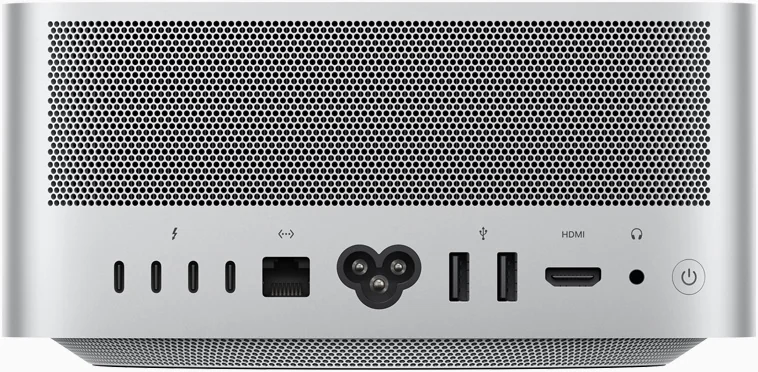
| Mac Studio (M3 Ultra) | 6 | 512GB | 最适合大型集群 |
| Mac mini (M4 Pro) | 3 前置 | 64GB | 经济高效的节点 |
| MacBook Pro 14" (M4 Pro) | 3 | 48GB | 便携式集群 |
| MacBook Pro 16" (M4 Max) | 3 | 128GB | 高内存便携式 |
重要规格:
- Thunderbolt 5 速度:80 Gbps 双向 (视频传输时可达 120 Gbps 突发模式)
- 内存带宽:M4 Pro 提供 273GB/s,M4 Max 提供 546GB/s
- 线缆长度:为获得最佳性能,请保持在 2 米以内
- 线缆类型:标准 Thunderbolt 5 线缆 (兼容 USB4 v2)
推荐的集群配置
预算集群 (机器学习实验):
4x Mac mini M4 Pro (每台 24GB)
总内存:96GB 共享
成本:约 7,200 美元
最适合:高达 70B 参数的模型
功耗:约 60W 空闲,200W 峰值
噪音水平:几乎无声
此配置非常适合学习分布式 ML 的开发者、尝试开源模型的小团队,或运行像 Llama 3.1 8B 和 Mistral 7B 这样的小型模型,性能卓越。
专业集群 (生产 AI 工作负载):
4x Mac mini M4 Pro (每台 64GB)
总内存:256GB 共享
成本:约 13,200 美元
最适合:高达 200B 参数的模型
功耗:约 80W 空闲,300W 峰值
噪音水平:几乎无声
专业级解锁了像 Llama 3.1 70B 这样的中大型模型,并可以在企业级模型上运行推理。这是大多数部署本地 AI 的企业最理想的选择。
企业集群 (万亿参数模型):
4x Mac Studio M3 Ultra (每台 512GB)
总内存:2TB 共享
成本:约 47,000 美元 (€47,000)
最适合:Kimi K2 Thinking, DeepSeek V3, 前沿模型
功耗:约 100W 空闲,500W 峰值
噪音水平:负载下中等
这种顶级配置在推理工作负载方面与数据中心 GPU 集群相当或超越,同时功耗仅为其一小部分,并且不需要专业基础设施。
Thunderbolt 5 线缆选择指南
选择正确的线缆对于集群性能至关重要。并非所有线缆都支持完整的 Thunderbolt 5 速度。
推荐线缆:
| 线缆 | 长度 | 最大速度 | 价格范围 |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbps | $69-79 |
| OWC Thunderbolt 5 | 0.8m | 80 Gbps | $50-60 |
| CalDigit TB5 Cable | 1m | 80 Gbps | $45-55 |
| Belkin Connect Pro | 1m | 80 Gbps | $40-50 |
线缆选择提示:
- 坚持在 1 米以下:全速 80 Gbps 需要短而高质量的线缆
- 寻找 USB4 v2 认证:确保 Thunderbolt 5 兼容性
- 避免适配器:仅支持 TB5 对 TB5 直接连接
- 从信誉良好的品牌购买:假冒线缆可能无法达到额定速度
- 部署前测试线缆:使用
system_profiler SPThunderboltDataType验证链路速度
警告:许多在线销售的“Thunderbolt 5 兼容”线缆只能达到 Thunderbolt 4 的速度。购买前务必核实规格。
软件栈:MLX 和 EXO 框架
了解 MLX 分布式计算
MLX 是 Apple 专为 Apple 芯片上的机器学习而设计的开源数组框架。它提供对多台 Mac 之间分布式计算的原生支持。
MLX 关键特性:
- 统一内存访问:利用 Apple 芯片的统一内存架构
- 惰性求值:仅在需要结果时才执行计算
- 动态编译:即时编译以获得最佳性能
- 分布式原语:内置对多机操作的支持
MLX 通信后端
MLX 支持三种不同用例的通信后端:
| 后端 | 速度 | 最适合 | 设置复杂性 |
|---|---|---|---|
| Ring | 最快 | Thunderbolt 连接 | 中等 |
| MPI | 快速 | 以太网网络 | 较高 |
| NCCL | 不适用 | CUDA 环境 | Mac 上不适用 |
Ring 后端推荐用于 Thunderbolt 5 集群,因为它针对直接点对点连接进行了优化。
了解分布式训练与推理
在深入设置之前,了解 Mac 集群的两个主要用例非常重要:
分布式推理(运行模型): 这是大多数用户的主要用例。当您运行推理时:
- 模型根据可用内存分割到多台 Mac 上
- 每台 Mac 持有部分模型权重
- 在生成过程中,数据根据需要流经节点
- 不进行训练——您正在使用预训练模型
分布式训练(创建模型): 对于研究人员和高级用户:
- 训练数据分割到节点上(数据并行)
- 每个批次后,梯度在所有节点上平均
- 模型权重定期同步
- 需要更多的节点间通信
| 用例 | 带宽要求 | 复杂性 | 典型用户 |
|---|---|---|---|
| 推理 | 中等(模型加载) | 低 | 大多数用户 |
| 微调 | 高(梯度同步) | 中等 | ML 工程师 |
| 全量训练 | 非常高(持续同步) | 高 | 研究人员 |
对于大多数 Mac 集群用户而言,推理是主要目标——运行单台机器无法容纳的大型模型。
EXO:简化的集群管理
EXO(来自 Exo Labs)为构建 AI 集群提供了更高级别的抽象。Apple 已将 EXO 的协议集成到 macOS Tahoe 26.2 中。
EXO 关键特性:
- 自动发现:自动检测网络上的其他设备
- 点对点架构:无主从层次结构
- 智能分区:根据设备能力优化分割模型
- 兼容 ChatGPT 的 API:位于
localhost:52415的 OpenAI 兼容端点
逐步集群设置指南
先决条件
开始之前,请确保您已具备:
- 所有 Mac 上均已安装 macOS Tahoe 26.2 或更高版本
- Thunderbolt 5 线缆 (2 米以内)
- 已安装 Python 3.12+
- 机器之间已配置无密码 SSH
- 所有机器处于同一网络 (用于初始发现)
方法 1: MLX 原生设置 (推荐)
步骤 1: 安装 MLX
# 通过 pip 安装 MLX
pip install mlx

# 验证安装
python -c "import mlx.core as mx; print(mx.__version__)"
步骤 2: 配置 Thunderbolt 网络
使用 Thunderbolt 5 线缆以环形拓扑连接您的 Mac:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1使用 MLX 分布式配置工具:
# 发现 Thunderbolt 环并生成配置
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# 自动配置所有节点 (需要无密码 sudo 权限)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
步骤 3: 创建主机文件配置
创建一个 ring-4.json 文件:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
步骤 4: 测试分布式通信
创建一个测试脚本 test_distributed.py:
import mlx.core as mx

# 初始化分布式组
world = mx.distributed.init()

# 每个进程创建一个带有其 rank 的数组
x = mx.ones(10) * world.rank()

# 汇总所有进程的数组
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
启动测试:
mlx.launch --hostfile ring-4.json test_distributed.py预期输出 (4 个节点):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
方法 2: EXO 设置 (用户友好型)
步骤 1: 克隆并安装 EXO
# 克隆仓库
git clone https://github.com/exo-explore/exo.git
cd exo

# 安装依赖
pip install -e .

# 或者使用安装脚本
source install.sh
步骤 2: 为 Apple 芯片配置 MLX
# 运行 MLX 配置脚本
./configure_mlx.sh
这会优化 Apple 芯片 Mac 上的 GPU 内存分配。
步骤 3: 启动集群
在每个节点上运行相同的命令:
exoEXO 将:
- 通过点对点通信自动发现其他节点
- 应用环形内存加权分区
- 在
http://localhost:52415启动 Web 界面 - 在
http://localhost:52415/v1/chat/completions启动 API 端点
步骤 4: 访问界面
在浏览器中打开 http://localhost:52415,即可使用类似于 ChatGPT 的界面与您的集群进行交互。
运行大型语言模型
下载模型
EXO 支持各种模型来源:
# 从 Hugging Face 下载
exo download moonshotai/Kimi-K2-Instruct

# 下载 Llama 模型
exo download meta-llama/Llama-3.1-70B-Instruct
按模型划分的内存要求
| 模型 | 参数 | 所需内存 | 推荐集群 |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16GB | 单台 Mac |
| Llama 3.1 70B | 70B | 140GB | 3x Mac mini (64GB) |
| Llama 3.1 405B | 405B | 810GB | 4x Mac Studio (512GB) |
| Kimi K2 | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
| Kimi K2 Thinking | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
运行 Kimi K2 Thinking
Kimi K2 Thinking 模型展示了 Thunderbolt 5 集群的强大功能。它是一个 1 万亿参数的专家混合 (MoE) 模型,具有 320 亿个活动参数。由 Moonshot AI 开发,它代表了开源推理模型的前沿技术。
Kimi K2 的独特之处:
- 架构:专家混合 (MoE),总参数量 1T
- 活动参数:每次推理仅 32B 参数处于活动状态
- 上下文窗口:256K token
- 量化:原生 INT4,提高效率
- 磁盘大小:约 594GB (相比全精度 1TB+)
import mlx.core as mx
from mlx_lm import load, generate

# 初始化分布式环境
world = mx.distributed.init()

# 加载模型 (自动在节点间分布式加载)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# 生成文本
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
性能结果 (4x Mac Studio M3 Ultra):
- 总内存:2TB 统一内存
- 功耗:低于 500W (相比 GPU 集群 5,000W+)
- Token 生成速度:与云端推理具有竞争力
- 成本效益:比 NVIDIA RTX 5090 集群低 10 倍功耗
性能优化
网络拓扑最佳实践
环形拓扑 (推荐用于 4 个或更多节点):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
星形拓扑 (简单的 2-3 个节点):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3线缆和连接指南
| 因素 | 建议 | 影响 |
|---|---|---|
| 线缆长度 | 2 米以内 | 保持完整的 80 Gbps |
| 线缆质量 | 认证的 TB5/USB4 v2 | 防止数据错误 |
| 避免集线器 | 直接连接 | 集线器会将速度降至 10 Gbps |
| 端口选择 | 使用所有可用端口 | 最大化带宽 |
内存和计算平衡
在构建异构集群 (混合硬件) 时:
# MLX 会根据设备能力自动平衡
# 但您可以自定义分区:

import mlx.core as mx

# 获取分布式世界信息
world = mx.distributed.init()

# 自定义权重分配
weights = {
    0: 2.0,  # Mac Studio 获得 2 倍份额
    1: 1.0,  # Mac mini 获得 1 倍份额
    2: 1.0,
    3: 1.0
}
常见问题故障排除
连接问题
问题:节点无法相互发现
# 检查 Thunderbolt 连接状态
system_profiler SPThunderboltDataType

# 验证网络接口
networksetup -listallhardwareports

# 测试直接连接
ping mac2.local
问题:传输速度慢
# 测试 Thunderbolt 带宽
iperf3 -c mac2.local -p 5201

# 预期:TB5 约为 ~9-10 GB/s
# 如果较低:检查线缆长度/质量
MLX 错误
问题:“无可用分布式后端”
# 确保 MLX 已正确安装
pip install --upgrade mlx

# 检查 Python 版本 (需要 3.12+)
python --version
问题:分布式推理时“内存不足”
# 启用内存高效模式
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # 使用 95% 的可用内存

# 或者减小批量大小
generate(model, tokenizer, prompt=prompt, max_tokens=100)
SSH 配置
确保所有节点之间都有无密码 SSH 连接:
# 如果需要,生成 SSH 密钥
ssh-keygen -t ed25519

# 复制到所有节点
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# 测试
ssh mac2.local "hostname"
功耗效率和成本分析
功耗对比
| 配置 | 功耗 | 性能 | 性能/美元 |
|---|---|---|---|
| 4x Mac Studio (512GB) | ~500W | 万亿参数处理能力 | 最佳 |
| NVIDIA H100 集群 (4x) | ~2,800W | 类似能力 | 功耗高 5.6 倍 |
| NVIDIA RTX 5090 集群 | ~2,300W | VRAM 有限 | 功耗高 4.6 倍 |
总拥有成本
Mac Studio 集群 (2TB 配置):
- 硬件:47,000 美元
- 年功耗 (24/7):约 500 美元
- 维护:极少
- 5 年总拥有成本:约 49,500 美元
同等 GPU 集群:
- 硬件:100,000 美元以上
- 年功耗 (24/7):约 3,000 美元
- 散热基础设施:10,000 美元以上
- 维护:显著
- 5 年总拥有成本:约 130,000 美元以上
用例与应用
机器学习研究
Thunderbolt 5 集群在学术和企业 ML 研究中表现卓越:
研究应用:
- 模型训练:跨多台 Mac 进行分布式训练,并进行梯度同步
- 微调:在专有数据集上对大型模型进行本地微调
- 推理:在本地运行万亿参数模型进行实验
- 消融研究:无需等待云 GPU 可用性即可快速原型设计
研究工作流示例:
import mlx.core as mx
from mlx_lm import load, generate

# 加载您微调过的模型
model, tokenizer = load("./my-finetuned-model")

# 跨分布式集群运行实验
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
大学和研究实验室 受益于:
- 固定硬件成本与不可预测的云计费相比
- 敏感研究的完整数据隐私
- 分布式计算课程的教学资源
- 可重现的、可用于发表的实验
专业创意工作流
与 Apple 创意生态系统的集成提供了独特的优势:
视频制作:
- 分布式渲染:Final Cut Pro、DaVinci Resolve、Motion 项目
- AI 辅助编辑:用于场景检测、转录的本地 AI 模型
- 色彩分级:跨节点进行 GPU 加速的色彩处理
- 8K RAW 处理:足以处理大型视频文件的内存
音频制作:
- Logic Pro 分布式处理:跨节点进行插件渲染
- AI 音乐生成:运行本地音乐 AI 模型
- 音频修复:本地基于 ML 的降噪
3D 和动态图形:
- Blender 分布式渲染:跨 Mac 集群进行 Cycles 渲染
- Cinema 4D:集群支持的 CPU 渲染
- Houdini:模拟分布式(带有适当的插件)
有关创意工作流的更多信息,请参阅我们的 macOS Tahoe 专业工作流革命指南。
开发和测试
现代 AI 应用程序开发从本地集群中受益匪浅:
AI 驱动的应用程序开发:
# 示例:使用本地推理构建 AI 聊天机器人
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
开发者优势:
- 本地 LLM 开发:测试和迭代,不受 API 速率限制
- CI/CD 加速:分布式构建和测试系统
- AI 应用程序开发:使用本地 AI 后端构建应用程序
- 无成本实验:开发期间无按请求付费
测试优势:
- 在本地针对生产规模模型进行测试
- 测试环境中无网络延迟
- 一致、可重现的测试结果
- 完全控制模型版本
查看我们的 macOS Tahoe 开发者设置指南 以获取开发环境配置。
企业部署场景
大型组织正在部署 Mac 集群以实现:
内部 AI 助手:
- 私有的 ChatGPT 风格界面
- 文档分析和摘要
- 代码审查和生成
- 会议转录和分析
合规性敏感行业:
- 医疗保健:符合 HIPAA 标准的 AI 处理
- 金融:本地模型推理
- 法律:机密文档分析
- 政府:空隙 AI 能力
企业成本效益分析:
| 场景 | 云成本/年 | Mac 集群成本/年 | 节省 |
|---|---|---|---|
| 轻度 (1M token/天) | 约 11,000 美元 | 约 3,000 美元 (摊销) | 73% |
| 中度 (10M token/天) | 约 110,000 美元 | 约 15,000 美元 (摊销) | 86% |
| 重度 (100M token/天) | 约 1.1M 美元 | 约 60,000 美元 (摊销) | 95% |
Mac 集群的未来
M5 及更高版本
Apple M5 芯片 在每个 GPU 核心中引入了神经加速器,提供了 4 倍的 AI 性能提升。当与 Thunderbolt 5 集群结合时:
- 增强的 MLX 支持:完全访问 M5 神经加速器
- 改进的内存带宽:每个芯片 153GB/s
- 更佳的电源效率:每瓦提供更高的性能
Mac Pro 的影响
据报道,Apple 内部已“基本放弃 Mac Pro”。Thunderbolt 5 集群提供了一条替代路径:
- 可扩展性能:根据需要添加节点
- 更低的入门成本:从小规模开始,后续扩展
- 灵活性:混合搭配不同的 Mac 型号
- 面向未来:随着时间推移升级单个节点
安全与隐私考量
为什么本地处理很重要
Mac 集群相对于基于云的 AI 的最显著优势之一是完整的数据隐私。您的提示、训练数据和生成输出永远不会离开您的本地网络。
隐私优势:
- 无数据传输:所有处理均在本地进行
- 合规友好:更易于实现 HIPAA、GDPR、SOC2 合规
- IP 保护:专有数据保持私密
- 无日志记录担忧:完全控制使用日志
Mac 集群安全最佳实践:
- 网络隔离:将您的集群保持在专用 VLAN 上
- 防火墙配置:阻止外部访问集群端口
- SSH 密钥管理:使用 ed25519 密钥,定期轮换
- macOS 安全:启用 FileVault,保持系统更新
- 物理安全:确保服务器机房访问安全
有关 macOS 安全配置的全面信息,请参阅我们的 macOS Tahoe 安全与隐私指南。
实际性能基准
推理速度对比
基于社区测试和 Apple 的演示:
| 模型 | 配置 | 每秒 token 数 | 对比 |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64GB) | ~35 tok/s | 与 RTX 4090 相当 |
| Llama 3.1 405B | 4x Mac Studio (512GB) | ~15 tok/s | 超越云端 A100 |
| Kimi K2 | 2x Mac Studio (512GB) | ~20 tok/s | 首个本地万亿参数模型 |
| DeepSeek V3 | 4x Mac Studio (512GB) | ~12 tok/s | 以前仅限云端 |
延迟分析
| 指标 | Mac 集群 | 云 API | 差异 |
|---|---|---|---|
| 首个 Token | 100-500ms | 500-2000ms | 快 2-10 倍 |
| 一致性延迟 | 是 | 可变 | 更可预测 |
| 冷启动 | 无 | 5-30s | 无需等待 |
| 可用性 | 100% (本地) | 99.9% | 无中断 |
每 Token 成本对比
假设一年 24/7 运行:
| 解决方案 | 硬件成本 | 运营成本 | 1 年总计 | 每 1M Token 成本 |
|---|---|---|---|---|
| 4x Mac Studio 集群 | $47,000 | ~$500 | $47,500 | ~$0.02 |
| OpenAI GPT-4 | $0 | 基于使用量 | 可变 | ~$30.00 |
| Claude API | $0 | 基于使用量 | 可变 | ~$15.00 |
| AWS Bedrock | $0 | 基于使用量 | 可变 | ~$10.00 |
对于重度用户(每年 >1 亿 token),本地 Mac 集群在经济上明显更划算。
常见问题
一个集群中可以连接多少台 Mac?
实际限制取决于您的拓扑结构。使用直接 Thunderbolt 连接(避免集线器),您可以高效连接 4-6 台 Mac。使用环形拓扑可以扩展到更多节点,同时保持全带宽。超过 6 个节点,您将需要仔细的拓扑规划以避免带宽瓶颈。
集群中的 Mac 需要完全相同吗?
不需要,MLX 和 EXO 支持异构集群。但是,集群将受限于最慢的组件。为了获得最佳结果,请使用相似代次的 Mac,并匹配 Thunderbolt 版本。内存分配将根据每个节点的可用 RAM 进行加权。
可以在集群中使用 Thunderbolt 4 Mac 吗?
可以,但这些连接的带宽将限制在 40 Gbps。Thunderbolt 5 和 4 向后兼容。混合使用不同代次时,系统将以较低的速度运行。为了获得最佳性能,请将 TB4 节点作为叶节点,而不是放在环形拓扑的中间。
集群所需的最小内存是多少?
总集群内存必须超过模型所需的内存,并留有一些操作余量。对于 Llama 3.1 70B (140GB 模型),您至少需要 3 台 Mac,每台 48GB (总计 144GB)。我们建议比模型大小多出 10-20% 的余量。
Mac 集群是用于训练还是仅用于推理?
两者皆可!MLX 支持分布式训练,并在节点间进行梯度平均。然而,由于大型模型的内存池化优势,推理是主要用例。训练需要更多的节点间通信,并且对网络延迟更敏感。
与云端 GPU 实例相比如何?
对于长期使用(超过 6 个月的常规使用),Mac 集群更具成本效益。您拥有硬件,没有按小时收费,并能获得有竞争力的性能。对于偶尔使用或实验,云实例最初可能更经济。
集群可以 24/7 运行吗?
当然可以。Mac 硬件专为持续运行而设计。特别是 Mac Studio 具有出色的散热管理能力,可应对持续的工作负载。使用“活动监视器”或 sudo powermetrics 监控温度,并确保充分通风。
如果一个节点出现故障会怎样?
目前,MLX 集群不支持热插拔或自动故障转移。如果一个节点断开连接,作业将失败并需要重新启动。对于关键工作负载,请在您的代码中实现检查点,以便从上次保存的状态恢复。
在运行 AI 工作负载时可以使用集群吗?
可以,但性能可能会受到影响。EXO 界面允许在您使用 Mac 执行其他任务时进行后台操作。为了获得最佳推理性能,请在进行繁重的 AI 工作负载时尽量减少其他活动。
总结
macOS Tahoe 26.2 的 Thunderbolt 5 集群代表了本地 AI 计算的范式转变。通过将多台 Mac 组合成一个统一的超级计算机,用户能够以传统 GPU 集群成本的一小部分运行万亿参数模型。
主要优势:
- 功耗比 GPU 替代方案低 10 倍
- 无需专业硬件
- MLX 和 EXO 设置简单
- 可从 2 个节点扩展到 6 个以上节点
- 本地、私密的 AI 处理
对于投资 Apple 生态系统的用户来说,仅此功能就足以证明升级到 macOS Tahoe 26.2 的合理性。查看我们的 macOS Tahoe 26.2 更新指南 获取完整的更新说明。
准备好优化您的 Mac 以进行 AI 工作负载了吗? 从我们的 macOS Tahoe 存储管理指南 开始,确保您有足够的空间来存储大型模型。
来源
- macOS Tahoe 中的 ML 获得 GPU、Thunderbolt 5 集群加速 - Apple Insider, 2025 年 11 月
- 您可以在 macOS Tahoe 26.2 中将 Mac 集群变成 AI 超级计算机 - Engadget, 2025 年 11 月
- Mac Studio 集群是我们不再需要 Mac Pro 的原因之一 - 9to5Mac, 2025 年 11 月
- AI 集群:2TB 的四台 Mac 可以运行巨型模型 Kimi K2 Thinking - Heise Online, 2025 年 11 月
- MLX 分布式通信文档 - Apple MLX 官方文档
- EXO:在家运行您自己的 AI 集群 - EXO Labs GitHub
- 使用 MLX 探索 Apple 芯片上的大型语言模型 - WWDC25 - Apple 开发者
- Kimi K2 - Moonshot AI - Moonshot AI 官方