Guia de Clustering Thunderbolt 5 no macOS Tahoe 26.2: Construa seu Próprio Supercomputador de IA
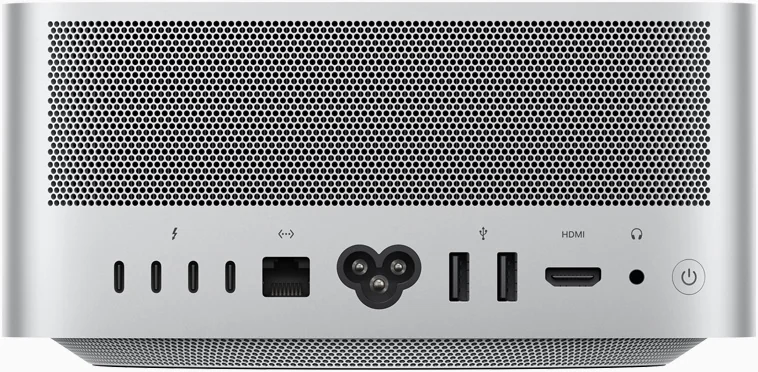
Guia completo para construir clusters Mac com Thunderbolt 5 no macOS Tahoe 26.2. Aprenda a configuração do framework MLX, configuração do EXO, requisitos de hardware e execute modelos de IA de trilhões de parâmetros localmente.
O macOS Tahoe 26.2 introduz um recurso revolucionário que transforma vários Macs em um supercomputador de IA unificado usando clustering Thunderbolt 5. Este guia abrangente cobre tudo, desde os requisitos de hardware até a execução de modelos de trilhões de parâmetros como o Kimi K2 Thinking em seu próprio cluster Mac.
Principais Destaques
- O clustering Thunderbolt 5 no macOS Tahoe 26.2 permite conectar vários Macs a uma velocidade bidirecional de até 80 Gbps
- Quatro Mac Studios com 512 GB cada podem executar o modelo Kimi K2 Thinking de 1 trilhão de parâmetros usando menos de 500 W de potência total
- Dispositivos compatíveis incluem o Mac mini M4 Pro, MacBook Pro M4 Pro/Max e Mac Studio M3 Ultra
- O framework MLX e o software EXO 1.0 fornecem a infraestrutura de computação distribuída
- Nenhum hardware especial necessário - apenas cabos Thunderbolt 5 padrão com menos de 2 metros
Resumo Executivo: Entendendo a Tecnologia de Clustering Mac
Por que o Clustering Thunderbolt 5 é Importante
O lançamento do macOS Tahoe 26.2 marca um momento crucial na estratégia de computação profissional da Apple. Pela primeira vez, a Apple fornece suporte nativo e otimizado para conectar vários Macs em um cluster de computação unificado usando a largura de banda sem precedentes do Thunderbolt 5. Isso não é apenas uma melhoria incremental - muda fundamentalmente o que é possível com o hardware Mac.
O Problema que Resolve:
Executar grandes modelos de IA tradicionalmente exigia clusters de GPU caros com consumo massivo de energia. Uma configuração típica para modelos de trilhões de parâmetros poderia incluir:
- Cluster NVIDIA H100: Hardware de mais de US$ 400.000, consumo de energia superior a 10 kW
- Instâncias de GPU na Nuvem: US$ 2-5 por hora para instâncias capazes
- Infraestrutura de Data Center Personalizada: Refrigeração, distribuição de energia, rede
A Solução do Cluster Mac:
Com o clustering Thunderbolt 5, você pode alcançar capacidades comparáveis com:
- 4x Mac Studio: Hardware de US$ 47.000 (88% de redução de custo vs H100)
- Consumo de Energia: Menos de 500 W (95% de redução)
- Sem Infraestrutura: Ambiente de escritório padrão
- Processamento Local: Privacidade total dos dados
Quem se Beneficia do Clustering Mac?
Pesquisadores de IA e Engenheiros de ML:
- Execute modelos de fronteira localmente sem dependências de nuvem
- Itere mais rápido com hardware dedicado
- Mantenha controle total sobre os dados de treinamento
Profissionais Criativos:
- Renderização de vídeo distribuída em vários Macs
- Edição assistida por IA com modelos locais
- Processamento de arquivos grandes sem latência de rede
Equipes de TI Empresariais:
- Implantações de IA privadas
- Infraestrutura de custo previsível
- Manutenção simplificada em comparação com clusters de GPU
Desenvolvedores Independentes:
- Construa aplicativos de IA com inferência local
- Teste contra grandes modelos durante o desenvolvimento
- Envie produtos sem custos contínuos de API
O que é o Clustering Mac Thunderbolt 5?
A Evolução da Computação Distribuída no Mac
O clustering Mac Thunderbolt 5 representa o renascimento moderno da computação distribuída no Mac pela Apple. Usuários de longa data da Apple podem se lembrar do Xgrid, que transformava coleções de Macs em supercomputadores. O novo clustering Thunderbolt 5 no macOS Tahoe 26.2 segue um conceito semelhante, mas opera em velocidades drasticamente mais altas.
Contexto Histórico:
- Era Xgrid: Limitada a velocidades Ethernet (1-10 Gbps)
- Clusters Thunderbolt 4: 40 Gbps, o uso de hubs reduzia as velocidades para 10 Gbps
- Clusters Thunderbolt 5: 80 Gbps bidirecionais completos, modo burst de 120 Gbps
Como Funciona o Clustering Thunderbolt 5
A tecnologia de clustering usa Acesso Remoto Direto à Memória (RDMA), permitindo que um Mac acesse diretamente a memória de outro sem sobrecarga da CPU. Quando você conecta vários Macs via Thunderbolt 5:
- Pooling de Memória: A memória unificada de cada Mac torna-se acessível a todo o cluster
- Particionamento de Modelo: Grandes modelos de IA são divididos proporcionalmente entre as máquinas
- Processamento Paralelo: Cargas de trabalho são distribuídas com base nos recursos disponíveis
- Comunicação de Baixa Latência: O acesso direto à memória elimina gargalos de rede
Exemplo de Configuração de Pool de Memória:
| Configuração | Memória Total | Caso de Uso |
|---|---|---|
| 2x Mac Studio (512 GB) | 1 TB compartilhado | Kimi K2 Thinking (594 GB) |
| 4x Mac Studio (512 GB) | 2 TB compartilhado | Múltiplos modelos de trilhões de parâmetros |
| 4x Mac mini M4 Pro (64 GB) | 256 GB compartilhado | Modelos de 70B-200B parâmetros |
Vantagem da Memória Unificada Apple Silicon
Uma razão fundamental pela qual o clustering Mac é tão eficaz reside na arquitetura de memória unificada do Apple Silicon. Ao contrário dos computadores tradicionais, onde a GPU e a CPU têm pools de memória separados, o Apple Silicon compartilha a memória entre todas as unidades de processamento.
Benefícios da Memória Unificada para Clustering:
| Aspecto | Arquitetura Tradicional | Apple Silicon |
|---|---|---|
| Acesso à Memória | GPU copia dados da RAM | Acesso compartilhado direto |
| Largura de Banda | Limitada por PCIe (64 GB/s) | Até 800 GB/s (M3 Ultra) |
| Eficiência | Duplicação de dados necessária | Operações de cópia zero |
| Escalabilidade | VRAM limita o tamanho do modelo | Pool unificado escala linearmente |
Quando você agrupa vários Macs, está efetivamente criando um pool de memória unificada maior. Um modelo grande demais para a memória de um Mac pode ser dividido entre nós, com cada Mac mantendo uma parte e compartilhando o acesso via Thunderbolt 5.
Exemplo Prático:
- Mac Studio Único (512 GB): Pode executar modelos de até ~450 GB (deixando margem)
- 2x Mac Studio (1 TB em pool): Pode executar modelos de até ~900 GB
- 4x Mac Studio (2 TB em pool): Pode executar modelos de até ~1,8 TB
Essa escala linear é o que torna modelos de trilhões de parâmetros como o Kimi K2 Thinking viáveis em hardware Mac.
Requisitos de Hardware e Compatibilidade
Modelos de Mac Compatíveis
Suporte Nativo Thunderbolt 5 (80 Gbps Completos):
| Dispositivo | Portas Thunderbolt 5 | Memória Máx. | Notas |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 GB | Melhor para grandes clusters |
| Mac mini (M4 Pro) | 3 frontais | 64 GB | Nós econômicos |
| MacBook Pro 14" (M4 Pro) | 3 | 48 GB | Clustering portátil |
| MacBook Pro 16" (M4 Max) | 3 | 128 GB | Portátil de alta memória |
Especificações Importantes:
- Velocidade Thunderbolt 5: 80 Gbps bidirecional (120 Gbps modo burst para vídeo)
- Largura de Banda de Memória: M4 Pro oferece 273 GB/s, M4 Max oferece 546 GB/s
- Comprimento do Cabo: Mantenha abaixo de 2 metros para desempenho ideal
- Tipo de Cabo: Cabos Thunderbolt 5 padrão (compatíveis com USB4 v2)
Configurações de Cluster Recomendadas
Cluster Econômico (Experimentação de Aprendizado de Máquina):
4x Mac mini M4 Pro (24 GB cada)
Memória Total: 96 GB compartilhados
Custo: ~$7.200
Melhor Para: Modelos de até 70B parâmetros
Consumo de Energia: ~60W ocioso, ~200W pico
Nível de Ruído: Quase silencioso
Esta configuração é perfeita para desenvolvedores aprendendo ML distribuído, pequenas equipes experimentando modelos de código aberto ou executando modelos menores como Llama 3.1 8B e Mistral 7B com excelente desempenho.
Cluster Profissional (Cargas de Trabalho de IA de Produção):
4x Mac mini M4 Pro (64 GB cada)
Memória Total: 256 GB compartilhados
Custo: ~$13.200
Melhor Para: Modelos de até 200B parâmetros
Consumo de Energia: ~80W ocioso, ~300W pico
Nível de Ruído: Quase silencioso
O nível profissional desbloqueia modelos médios-grandes como Llama 3.1 70B e pode executar inferência em modelos de nível empresarial. Este é o ponto ideal para a maioria das empresas que implantam IA local.
Cluster Empresarial (Modelos de Trilhões de Parâmetros):
4x Mac Studio M3 Ultra (512 GB cada)
Memória Total: 2 TB compartilhados
Custo: ~$47.000 (€47.000)
Melhor Para: Kimi K2 Thinking, DeepSeek V3, modelos de fronteira
Consumo de Energia: ~100W ocioso, ~500W pico
Nível de Ruído: Moderado sob carga
Esta configuração de nível superior iguala ou excede clusters de GPU de data center para cargas de trabalho de inferência, consumindo uma fração da energia e não exigindo infraestrutura especializada.
Guia de Seleção de Cabos Thunderbolt 5
Escolher os cabos certos é crítico para o desempenho do cluster. Nem todos os cabos suportam velocidades completas do Thunderbolt 5.
Cabos Recomendados:
| Cabo | Comprimento | Velocidade Máx. | Faixa de Preço |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbps | $69-79 |
| OWC Thunderbolt 5 | 0,8m | 80 Gbps | $50-60 |
| CalDigit TB5 Cable | 1m | 80 Gbps | $45-55 |
| Belkin Connect Pro | 1m | 80 Gbps | $40-50 |
Dicas de Seleção de Cabos:
- Mantenha abaixo de 1 metro: Os 80 Gbps completos exigem cabos curtos e de alta qualidade
- Procure a certificação USB4 v2: Garante compatibilidade com Thunderbolt 5
- Evite adaptadores: Apenas conexões diretas TB5 para TB5
- Compre de marcas respeitáveis: Cabos falsificados podem não atingir as velocidades nominais
- Teste os cabos antes da implantação: Use
system_profiler SPThunderboltDataTypepara verificar a velocidade do link
Aviso: Muitos cabos vendidos online como "compatíveis com Thunderbolt 5" atingem apenas velocidades Thunderbolt 4. Verifique sempre as especificações antes de comprar.
Pilha de Software: Frameworks MLX e EXO
Entendendo a Computação Distribuída MLX
MLX é o framework de array de código aberto da Apple projetado especificamente para aprendizado de máquina no Apple Silicon. Ele fornece suporte nativo para computação distribuída em vários Macs.
Recursos Principais do MLX:
- Acesso à Memória Unificada: Aproveita a arquitetura de memória unificada do Apple Silicon
- Avaliação Preguiçosa: Os cálculos só são executados quando os resultados são necessários
- Compilação Dinâmica: Compilação just-in-time para desempenho ideal
- Primitivas Distribuídas: Suporte integrado para operações multi-máquina
Backends de Comunicação MLX
O MLX suporta três backends de comunicação para diferentes casos de uso:
| Backend | Velocidade | Melhor Para | Complexidade de Configuração |
|---|---|---|---|
| Ring | Mais rápido | Conexões Thunderbolt | Média |
| MPI | Rápido | Redes Ethernet | Maior |
| NCCL | N/A | Ambientes CUDA | N/A no Mac |
O backend Ring é recomendado para clusters Thunderbolt 5, pois é otimizado para conexões peer-to-peer diretas.
Entendendo Treinamento Distribuído vs Infferência
Antes de mergulhar na configuração, é importante entender os dois principais casos de uso para o clustering Mac:
Infferência Distribuída (Execução de Modelos): Este é o principal caso de uso para a maioria dos usuários. Quando você executa inferência:
- O modelo é dividido em vários Macs com base na memória disponível
- Cada Mac mantém uma parte dos pesos do modelo
- Durante a geração, os dados fluem entre os nós conforme necessário
- Nenhum treinamento ocorre — você está usando um modelo pré-treinado
Treinamento Distribuído (Criação de Modelos): Para pesquisadores e usuários avançados:
- Os dados de treinamento são divididos entre nós (paralelismo de dados)
- Os gradientes são calculados em média em todos os nós após cada lote
- Os pesos do modelo são sincronizados periodicamente
- Requer significativamente mais comunicação entre nós
| Caso de Uso | Requisito de Largura de Banda | Complexidade | Usuários Típicos |
|---|---|---|---|
| Infferência | Médio (carregamento de modelo) | Baixa | A maioria dos usuários |
| Ajuste Fino | Alto (sincronização de gradiente) | Média | Engenheiros de ML |
| Treinamento Completo | Muito Alto (sincronização constante) | Alta | Pesquisadores |
Para a maioria dos usuários de cluster Mac, a inferência é o objetivo principal — executar modelos grandes que não caberiam em uma única máquina.
EXO: Gerenciamento de Cluster Simplificado
EXO (da Exo Labs) fornece uma abstração de nível superior para a construção de clusters de IA. A Apple integrou o protocolo do EXO no macOS Tahoe 26.2.
Recursos Principais do EXO:
- Descoberta Automática: Detecta automaticamente outros dispositivos na rede
- Arquitetura Peer-to-Peer: Sem hierarquia mestre-trabalhador
- Particionamento Inteligente: Divide otimamente os modelos com base nas capacidades do dispositivo
- API Compatível com ChatGPT: Endpoint compatível com OpenAI em
localhost:52415
Guia Passo a Passo de Configuração do Cluster
Pré-requisitos
Antes de começar, certifique-se de ter:
- macOS Tahoe 26.2 ou posterior instalado em todos os Macs
- Cabos Thunderbolt 5 (menos de 2 metros)
- Python 3.12+ instalado
- SSH sem senha configurado entre as máquinas
- Mesma rede para todas as máquinas (para descoberta inicial)
Método 1: Configuração Nativa MLX (Recomendado)
Passo 1: Instalar MLX
# Instalar MLX via pip
pip install mlx

# Verificar instalação
python -c "import mlx.core as mx; print(mx.__version__)"
Passo 2: Configurar Rede Thunderbolt
Conecte seus Macs em uma topologia de anel usando cabos Thunderbolt 5:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1Use a ferramenta de configuração distribuída MLX:
# Descobrir anel Thunderbolt e gerar configuração
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# Autoconfigurar todos os nós (requer sudo sem senha)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
Passo 3: Criar Configuração de Arquivo Host
Crie um arquivo ring-4.json:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
Passo 4: Testar Comunicação Distribuída
Crie um script de teste test_distributed.py:
import mlx.core as mx

# Inicializar grupo distribuído
world = mx.distributed.init()

# Cada processo cria um array com seu rank
x = mx.ones(10) * world.rank()

# Somar arrays em todos os processos
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: soma = {result}")
Inicie o teste:
mlx.launch --hostfile ring-4.json test_distributed.pySaída esperada (4 nós):
Rank 0: soma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: soma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: soma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: soma = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Método 2: Configuração EXO (Amigável ao Usuário)
Passo 1: Clonar e Instalar EXO
# Clonar o repositório
git clone https://github.com/exo-explore/exo.git
cd exo

# Instalar dependências
pip install -e .

# Ou usar o script de instalação
source install.sh
Passo 2: Configurar MLX para Apple Silicon
# Executar o script de configuração MLX
./configure_mlx.sh
Isso otimiza a alocação de memória da GPU em Macs com Apple Silicon.
Passo 3: Iniciar o Cluster
Em cada nó, execute o mesmo comando:
exoO EXO irá:
- Descobrir automaticamente outros nós via comunicação peer-to-peer
- Aplicar particionamento ponderado de memória em anel
- Iniciar a interface web em
http://localhost:52415 - Iniciar o endpoint da API em
http://localhost:52415/v1/chat/completions
Passo 4: Acessar a Interface
Abra seu navegador em http://localhost:52415 para uma interface tipo ChatGPT para interagir com seu cluster.
Executando Grandes Modelos de Linguagem
Baixando Modelos
O EXO suporta várias fontes de modelos:
# Baixar do Hugging Face
exo download moonshotai/Kimi-K2-Instruct

# Baixar modelos Llama
exo download meta-llama/Llama-3.1-70B-Instruct
Requisitos de Memória por Modelo
| Modelo | Parâmetros | Memória Necessária | Cluster Recomendado |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 GB | Mac Único |
| Llama 3.1 70B | 70B | 140 GB | 3x Mac mini (64 GB) |
| Llama 3.1 405B | 405B | 810 GB | 4x Mac Studio (512 GB) |
| Kimi K2 | 1T (32B ativos) | 594 GB | 2x Mac Studio (512 GB) |
| Kimi K2 Thinking | 1T (32B ativos) | 594 GB | 2x Mac Studio (512 GB) |
Executando Kimi K2 Thinking
O modelo Kimi K2 Thinking demonstra o poder do clustering Thunderbolt 5. É um modelo de mistura de especialistas (MoE) de 1 trilhão de parâmetros com 32 bilhões de parâmetros ativos. Desenvolvido pela Moonshot AI, representa a vanguarda dos modelos de raciocínio de código aberto.
O que Torna o Kimi K2 Especial:
- Arquitetura: Mistura de Especialistas (MoE) com 1T de parâmetros totais
- Parâmetros Ativos: Apenas 32B parâmetros ativos por inferência
- Janela de Contexto: 256K tokens
- Quantização: INT4 nativo para eficiência
- Tamanho em Disco: ~594 GB (vs 1 TB+ para precisão total)
import mlx.core as mx
from mlx_lm import load, generate

# Inicializar ambiente distribuído
world = mx.distributed.init()

# Carregar modelo (distribuído automaticamente entre nós)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# Gerar texto
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
Resultados de Desempenho (4x Mac Studio M3 Ultra):
- Memória Total: 2 TB unificada
- Consumo de Energia: Menos de 500 W (vs 5.000 W+ para cluster de GPU)
- Geração de Tokens: Competitiva com inferência em nuvem
- Eficiência de Custo: 10x menos energia que o cluster NVIDIA RTX 5090
Otimização de Desempenho
Melhores Práticas de Topologia de Rede
Topologia em Anel (Recomendada para 4+ Nós):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
Topologia Estrela (Simples 2-3 Nós):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3Diretrizes de Cabo e Conexão
| Fator | Recomendação | Impacto |
|---|---|---|
| Comprimento do Cabo | Abaixo de 2 metros | Mantém 80 Gbps completos |
| Qualidade do Cabo | Certificado TB5/USB4 v2 | Previne erros de dados |
| Evitar Hubs | Conexões diretas | Hubs reduzem para 10 Gbps |
| Seleção de Porta | Usar todas disponíveis | Maximiza a largura de banda |
Balanceamento de Memória e Computação
Ao construir um cluster heterogêneo (hardware misto):
# MLX equilibra automaticamente com base nas capacidades do dispositivo
# Mas você pode personalizar o particionamento:

import mlx.core as mx

# Obter informações do mundo distribuído
world = mx.distributed.init()

# Atribuição de peso personalizada
weights = {
    0: 2.0,  # Mac Studio recebe 2x a parte
    1: 1.0,  # Mac mini recebe 1x a parte
    2: 1.0,
    3: 1.0
}
Solução de Problemas Comuns
Problemas de Conexão
Problema: Nós não estão se descobrindo
# Verificar status da conexão Thunderbolt
system_profiler SPThunderboltDataType

# Verificar interfaces de rede
networksetup -listallhardwareports

# Testar conectividade direta
ping mac2.local
Problema: Velocidades de transferência lentas
# Testar largura de banda Thunderbolt
iperf3 -c mac2.local -p 5201

# Esperado: ~9-10 GB/s para TB5
# Se menor: verificar comprimento/qualidade do cabo
Erros MLX
Problema: "Nenhum backend distribuído disponível"
# Garantir que o MLX esteja instalado corretamente
pip install --upgrade mlx

# Verificar versão do Python (requer 3.12+)
python --version
Problema: "Memória insuficiente" na inferência distribuída
# Habilitar modo eficiente em memória
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # Usar 95% da memória disponível

# Ou reduzir tamanho do lote
generate(model, tokenizer, prompt=prompt, max_tokens=100)
Configuração SSH
Garanta SSH sem senha entre todos os nós:
# Gerar chave SSH se necessário
ssh-keygen -t ed25519

# Copiar para todos os nós
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# Testar
ssh mac2.local "hostname"
Eficiência Energética e Análise de Custos
Comparação de Consumo de Energia
| Configuração | Consumo de Energia | Desempenho | $/Desempenho |
|---|---|---|---|
| 4x Mac Studio (512 GB) | ~500 W | Capaz de trilhões de parâmetros | Melhor |
| Cluster NVIDIA H100 (4x) | ~2.800 W | Capacidade semelhante | 5,6x mais energia |
| Cluster NVIDIA RTX 5090 | ~2.300 W | VRAM limitada | 4,6x mais energia |
Custo Total de Propriedade (TCO)
Cluster Mac Studio (Configuração 2 TB):
- Hardware: US$ 47.000
- Energia Anual (24/7): ~$500
- Manutenção: Mínima
- TCO de 5 Anos: ~$49.500
Cluster de GPU Equivalente:
- Hardware: US$ 100.000+
- Energia Anual (24/7): ~$3.000
- Infraestrutura de Refrigeração: US$ 10.000+
- Manutenção: Significativa
- TCO de 5 Anos: ~$130.000+
Casos de Uso e Aplicações
Pesquisa em Aprendizado de Máquina
O clustering Thunderbolt 5 se destaca para pesquisa de ML acadêmica e corporativa:
Aplicações de Pesquisa:
- Treinamento de Modelo: Treinamento distribuído em vários Macs com sincronização de gradiente
- Ajuste Fino: Ajuste fino local de grandes modelos em conjuntos de dados proprietários
- Infferência: Execução local de modelos de trilhões de parâmetros para experimentação
- Estudos de Ablação: Prototipagem rápida sem esperar pela disponibilidade de GPU na nuvem
Exemplo de Fluxo de Trabalho de Pesquisa:
import mlx.core as mx
from mlx_lm import load, generate

# Carregar seu modelo ajustado
model, tokenizer = load("./my-finetuned-model")

# Executar experimentos em cluster distribuído
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
Universidades e Laboratórios de Pesquisa se beneficiam de:
- Custos fixos de hardware vs cobrança de nuvem imprevisível
- Privacidade total de dados para pesquisas sensíveis
- Recursos de ensino para cursos de computação distribuída
- Experimentos reprodutíveis prontos para publicação
Fluxos de Trabalho Criativos Profissionais
A integração com o ecossistema criativo da Apple oferece vantagens únicas:
Produção de Vídeo:
- Renderização Distribuída: Projetos Final Cut Pro, DaVinci Resolve, Motion
- Edição Assistida por IA: Modelos de IA locais para detecção de cena, transcrição
- Correção de Cor: Processamento de cor acelerado por GPU em nós
- Processamento RAW 8K: Memória suficiente para arquivos de vídeo grandes
Produção de Áudio:
- Processamento Distribuído Logic Pro: Renderização de plugins em nós
- Geração de Música por IA: Executar modelos de IA de música locais
- Restauração de Áudio: Redução de ruído baseada em ML localmente
3D e Motion Graphics:
- Renderização Distribuída Blender: Renderização Cycles em cluster Mac
- Cinema 4D: Renderização de CPU com suporte a cluster
- Houdini: Distribuição de simulação (com plugins apropriados)
Para mais informações sobre fluxos de trabalho criativos, consulte nosso Guia da Revolução do Fluxo de Trabalho Profissional do macOS Tahoe.
Desenvolvimento e Testes
O desenvolvimento moderno de aplicativos de IA se beneficia significativamente de clusters locais:
Desenvolvimento de Aplicativos Impulsionados por IA:
# Exemplo: Construindo um chatbot de IA com inferência local
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
Benefícios para Desenvolvedores:
- Desenvolvimento Local de LLM: Teste e itere sem limites de taxa de API
- Aceleração de CI/CD: Sistemas de construção e teste distribuídos
- Desenvolvimento de Aplicativos de IA: Construa aplicativos com backends de IA locais
- Experimentação Sem Custo: Sem cobranças por solicitação durante o desenvolvimento
Vantagens de Teste:
- Teste contra modelos em escala de produção localmente
- Sem latência de rede em ambientes de teste
- Resultados de teste consistentes e reprodutíveis
- Controle total sobre versões de modelo
Confira nosso Guia de Configuração de Desenvolvedor do macOS Tahoe para configuração do ambiente de desenvolvimento.
Cenários de Implantação Empresarial
Grandes organizações estão implantando clusters Mac para:
Assistentes de IA Internos:
- Interfaces privadas estilo ChatGPT
- Análise e resumo de documentos
- Revisão e geração de código
- Transcrição e análise de reuniões
Indústrias Sensíveis à Conformidade:
- Saúde: Processamento de IA compatível com HIPAA
- Finanças: Infferência de modelo local
- Jurídico: Análise confidencial de documentos
- Governo: Capacidades de IA isoladas (air-gapped)
Análise de Custo-Benefício para Empresas:
| Cenário | Custo Nuvem/Ano | Custo Cluster Mac/Ano | Economia |
|---|---|---|---|
| Leve (1M tokens/dia) | ~$11.000 | ~$3.000 (amortizado) | 73% |
| Médio (10M tokens/dia) | ~$110.000 | ~$15.000 (amortizado) | 86% |
| Pesado (100M tokens/dia) | ~$1,1M | ~$60.000 (amortizado) | 95% |
Futuro do Clustering Mac
M5 e Além
O chip Apple M5 introduz Aceleradores Neurais em cada núcleo de GPU, oferecendo uma melhoria de desempenho de IA de 4x. Quando combinado com o clustering Thunderbolt 5:
- Suporte MLX Aprimorado: Acesso total aos aceleradores neurais M5
- Largura de Banda de Memória Melhorada: 153 GB/s por chip
- Melhor Eficiência Energética: Mais desempenho por watt
Implicações para o Mac Pro
Segundo relatos, a Apple "praticamente descartou o Mac Pro" internamente. O clustering Thunderbolt 5 oferece um caminho alternativo:
- Desempenho Escalável: Adicione nós conforme necessário
- Custo de Entrada Mais Baixo: Comece pequeno, expanda depois
- Flexibilidade: Misture diferentes modelos de Mac
- À Prova de Futuro: Atualize nós individuais ao longo do tempo
Considerações de Segurança e Privacidade
Por que o Processamento Local é Importante
Uma das vantagens mais significativas do clustering Mac sobre a IA baseada em nuvem é a privacidade total dos dados. Seus prompts, dados de treinamento e saídas geradas nunca saem de sua rede local.
Benefícios de Privacidade:
- Sem Transmissão de Dados: Todo o processamento acontece localmente
- Amigável à Conformidade: Conformidade mais fácil com HIPAA, GDPR, SOC2
- Proteção de PI: Dados proprietários permanecem privados
- Sem Preocupações de Registro: Controle total sobre logs de uso
Melhores Práticas de Segurança para Clusters Mac:
- Isolamento de Rede: Mantenha seu cluster em uma VLAN dedicada
- Configuração de Firewall: Bloqueie o acesso externo às portas do cluster
- Gerenciamento de Chaves SSH: Use chaves ed25519, rotacione regularmente
- Segurança do macOS: Habilite o FileVault, mantenha os sistemas atualizados
- Segurança Física: Proteja o acesso à sala do servidor
Para uma configuração abrangente de segurança do macOS, consulte nosso Guia de Segurança e Privacidade do macOS Tahoe.
Benchmarks de Desempenho no Mundo Real
Comparação de Velocidade de Infferência
Com base em testes da comunidade e demonstrações da Apple:
| Modelo | Configuração | Tokens/Segundo | Comparação |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 GB) | ~35 tok/s | Comparável ao RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 GB) | ~15 tok/s | Excede nuvem A100 |
| Kimi K2 | 2x Mac Studio (512 GB) | ~20 tok/s | Primeiro trilhão de parâmetros local |
| DeepSeek V3 | 4x Mac Studio (512 GB) | ~12 tok/s | Anteriormente apenas nuvem |
Análise de Latência
| Métrica | Cluster Mac | API Nuvem | Diferença |
|---|---|---|---|
| Primeiro Token | 100-500ms | 500-2000ms | 2-10x mais rápido |
| Latência Consistente | Sim | Variável | Mais previsível |
| Inicialização a Frio | Nenhuma | 5-30s | Sem espera |
| Disponibilidade | 100% (local) | 99,9% | Sem interrupções |
Comparação de Custo Por Token
Assumindo operação 24/7 ao longo de 1 ano:
| Solução | Custo de Hardware | Custo Operacional | Total 1 Ano | Custo/1M Tokens |
|---|---|---|---|---|
| Cluster 4x Mac Studio | $47.000 | ~$500 | $47.500 | ~$0,02 |
| OpenAI GPT-4 | $0 | Baseado em uso | Variável | ~$30,00 |
| Claude API | $0 | Baseado em uso | Variável | ~$15,00 |
| AWS Bedrock | $0 | Baseado em uso | Variável | ~$10,00 |
Para usuários pesados (>100M tokens/ano), o clustering Mac local torna-se significativamente mais econômico.
Perguntas Frequentes (FAQ)
Quantos Macs posso conectar em um cluster?
O limite prático depende da sua topologia. Com conexões Thunderbolt diretas (evitando hubs), você pode conectar eficientemente 4-6 Macs. Usar uma topologia em anel permite escalar para mais nós mantendo a largura de banda total. Além de 6 nós, você precisará de um planejamento cuidadoso da topologia para evitar gargalos de largura de banda.
Preciso de Macs idênticos para clustering?
Não, MLX e EXO suportam clusters heterogêneos. No entanto, o cluster será limitado pelo componente mais lento. Para melhores resultados, use Macs de geração semelhante com versões Thunderbolt correspondentes. A distribuição de memória será ponderada pela RAM disponível de cada nó.
Posso usar Macs Thunderbolt 4 em um cluster?
Sim, mas a largura de banda nessas conexões será limitada a 40 Gbps. Thunderbolt 5 e 4 são compatíveis com versões anteriores. O sistema operará na velocidade mais baixa ao misturar gerações. Para melhor desempenho, mantenha os nós TB4 como nós folha em vez de no meio de um anel.
Qual é a memória mínima necessária para clustering?
A memória total do cluster deve exceder o requisito de memória do seu modelo com alguma margem para operações. Para Llama 3.1 70B (modelo de 140 GB), você precisa de pelo menos 3 Macs com 48 GB cada (144 GB total). Recomendamos 10-20% de margem acima do tamanho do modelo.
O clustering Mac é adequado para treinamento ou apenas inferência?
Ambos! O MLX suporta treinamento distribuído com média de gradiente entre nós. No entanto, a inferência é o principal caso de uso devido aos benefícios de pooling de memória para grandes modelos. O treinamento requer mais comunicação entre nós e é mais sensível à latência da rede.
Como isso se compara às instâncias de GPU na nuvem?
Para uso a longo prazo (mais de 6 meses de uso regular), o clustering Mac é mais econômico. Você possui o hardware, não tem cobranças por hora e obtém desempenho competitivo. Para uso ocasional ou experimentação, instâncias na nuvem podem ser mais econômicas inicialmente.
Posso executar o cluster 24/7?
Absolutamente. O hardware Mac é projetado para operação contínua. Os Mac Studios, em particular, têm excelente gerenciamento térmico para cargas de trabalho sustentadas. Monitore as temperaturas usando o Monitor de Atividade ou sudo powermetrics e garanta ventilação adequada.
O que acontece se um nó falhar?
Atualmente, o clustering MLX não suporta hot-swapping ou failover automático. Se um nó desconectar, o trabalho falhará e precisará ser reiniciado. Para cargas de trabalho críticas, implemente pontos de verificação em seu código para retomar do último estado salvo.
Posso usar o cluster enquanto executo cargas de trabalho de IA?
Sim, mas o desempenho pode ser impactado. A interface EXO permite operação em segundo plano enquanto você usa os Macs para outras tarefas. Para melhor desempenho de inferência, minimize outras atividades durante cargas de trabalho pesadas de IA.
Conclusão
O clustering Thunderbolt 5 do macOS Tahoe 26.2 representa uma mudança de paradigma na computação de IA local. Ao combinar vários Macs em um supercomputador unificado, os usuários podem executar modelos de trilhões de parâmetros a uma fração dos custos dos clusters de GPU tradicionais.
Principais Benefícios:
- Consumo de energia 10x menor do que alternativas de GPU
- Nenhum hardware especializado necessário
- Configuração simples com MLX e EXO
- Escalável de 2 a 6+ nós
- Processamento de IA local e privado
Para usuários investidos no ecossistema da Apple, esse recurso por si só pode justificar a atualização para o macOS Tahoe 26.2. Verifique nosso Guia de Atualização do macOS Tahoe 26.2 para instruções completas de atualização.
Pronto para otimizar seu Mac para cargas de trabalho de IA? Comece com nosso Guia de Gerenciamento de Armazenamento do macOS Tahoe para garantir que você tenha espaço adequado para grandes modelos.
Fontes
- ML no macOS Tahoe recebe impulso de GPU e clustering Thunderbolt 5 - Apple Insider, Novembro 2025
- Você pode transformar um cluster de Macs em um supercomputador de IA no macOS Tahoe 26.2 - Engadget, Novembro 2025
- Um cluster de Mac Studios é apenas uma razão pela qual não precisamos mais de um Mac Pro - 9to5Mac, Novembro 2025
- Cluster de IA: Quatro Macs com 2 TB podem executar o modelo gigante Kimi K2 Thinking - Heise Online, Novembro 2025
- Documentação de Comunicação Distribuída MLX - Documentos Oficiais Apple MLX
- EXO: Execute seu próprio cluster de IA em casa - EXO Labs GitHub
- Explore grandes modelos de linguagem no Apple silicon com MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Oficial Moonshot AI