macOS Tahoe 26.2 Thunderbolt 5 클러스터링 가이드: 나만의 AI 슈퍼컴퓨터 구축하기
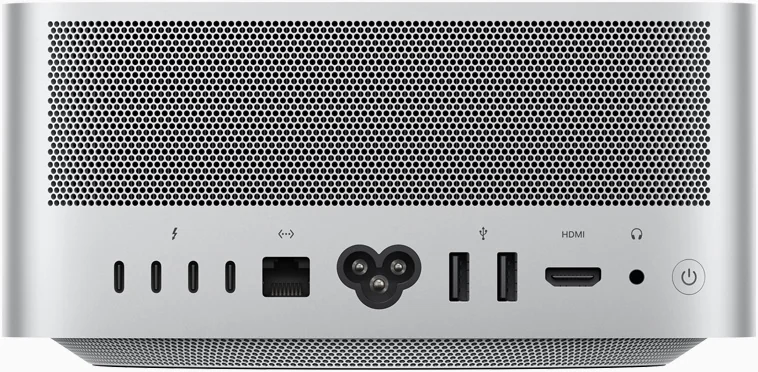
macOS Tahoe 26.2의 Thunderbolt 5로 Mac 클러스터를 구축하는 완벽 가이드. MLX 프레임워크 설정, EXO 구성, 하드웨어 요구 사항을 알아보고 1조 개의 파라미터 AI 모델을 로컬에서 실행해 보세요.
macOS Tahoe 26.2는 Thunderbolt 5 클러스터링을 사용하여 여러 대의 Mac을 통합 AI 슈퍼컴퓨터로 변환하는 혁신적인 기능을 도입했습니다. 이 포괄적인 가이드는 하드웨어 요구 사항부터 나만의 Mac 클러스터에서 Kimi K2 Thinking과 같은 1조 파라미터 모델을 실행하는 방법까지 모든 것을 다룹니다.
핵심 요약
- macOS Tahoe 26.2의 Thunderbolt 5 클러스터링은 최대 80Gbps 양방향 속도로 여러 대의 Mac을 연결할 수 있게 해줍니다.
- 각 512GB 메모리를 탑재한 4대의 Mac Studio는 500W 미만의 총 전력으로 1조 파라미터의 Kimi K2 Thinking 모델을 실행할 수 있습니다.
- 호환 기기에는 M4 Pro Mac mini, M4 Pro/Max MacBook Pro, M3 Ultra Mac Studio가 포함됩니다.
- MLX 프레임워크와 EXO 1.0 소프트웨어는 분산 컴퓨팅 인프라를 제공합니다.
- 특별한 하드웨어가 필요 없습니다 - 2미터 미만의 표준 Thunderbolt 5 케이블만 있으면 됩니다.
요약: Mac 클러스터링 기술의 이해
Thunderbolt 5 클러스터링이 중요한 이유
macOS Tahoe 26.2의 출시는 Apple의 전문 컴퓨팅 전략에 있어 중대한 순간입니다. Apple은 처음으로 Thunderbolt 5의 전례 없는 대역폭을 사용하여 여러 대의 Mac을 통합 컴퓨팅 클러스터로 연결하는 기능을 기본적으로 최적화하여 지원합니다. 이는 단순한 점진적 개선이 아니라 Mac 하드웨어로 가능한 것의 근본적인 변화입니다.
해결하는 문제:
대규모 AI 모델을 실행하려면 전통적으로 막대한 전력을 소비하는 값비싼 GPU 클러스터가 필요했습니다. 1조 파라미터 모델을 위한 일반적인 설정은 다음과 같습니다.
- NVIDIA H100 클러스터: 40만 달러 이상의 하드웨어, 10kW 이상의 전력 소비
- 클라우드 GPU 인스턴스: 고성능 인스턴스의 경우 시간당 2-5달러
- 맞춤형 데이터 센터 인프라: 냉각, 배전, 네트워킹
Mac 클러스터 솔루션:
Thunderbolt 5 클러스터링을 사용하면 다음과 같은 구성으로 비슷한 성능을 얻을 수 있습니다.
- 4x Mac Studio: 47,000달러 하드웨어 (H100 대비 비용 88% 절감)
- 전력 소비: 500W 미만 (95% 절감)
- 인프라 불필요: 표준 사무실 환경에서 가능
- 로컬 처리: 완벽한 데이터 개인정보 보호
Mac 클러스터링의 혜택을 받는 사람들은?
AI 연구원 및 ML 엔지니어:
- 클라우드 의존성 없이 프런티어 모델을 로컬에서 실행
- 전용 하드웨어로 더 빠른 반복 작업
- 학습 데이터에 대한 완전한 통제권 유지
크리에이티브 전문가:
- 여러 대의 Mac에 걸친 분산 비디오 렌더링
- 로컬 모델을 사용한 AI 지원 편집
- 네트워크 지연 없는 대용량 파일 처리
엔터프라이즈 IT 팀:
- 프라이빗 AI 배포
- 비용 예측 가능한 인프라
- GPU 클러스터 대비 간편한 유지보수
독립 개발자:
- 로컬 추론으로 AI 애플리케이션 구축
- 개발 중 대규모 모델에 대해 테스트 수행
- 지속적인 API 비용 없이 제품 출시
Thunderbolt 5 Mac 클러스터링이란?
Mac 분산 컴퓨팅의 진화
Thunderbolt 5 Mac 클러스터링은 Mac에서의 분산 컴퓨팅의 현대적 부활을 의미합니다. 오랜 Apple 사용자라면 여러 대의 Mac을 슈퍼컴퓨터로 만들어주던 Xgrid를 기억할 것입니다. macOS Tahoe 26.2의 새로운 Thunderbolt 5 클러스터링은 비슷한 개념을 따르지만 획기적으로 더 빠른 속도로 작동합니다.
역사적 배경:
- Xgrid 시대: 이더넷 속도(1-10 Gbps)로 제한됨
- Thunderbolt 4 클러스터: 40Gbps, 허브 사용 시 10Gbps로 속도 저하
- Thunderbolt 5 클러스터: 전체 80Gbps 양방향, 120Gbps 버스트 모드
Thunderbolt 5 클러스터링 작동 방식
이 클러스터링 기술은 **원격 직접 메모리 액세스(RDMA)**를 사용하여 CPU 오버헤드 없이 한 Mac이 다른 Mac의 메모리에 직접 액세스할 수 있게 합니다. Thunderbolt 5를 통해 여러 대의 Mac을 연결하면 다음과 같은 일이 일어납니다.
- 메모리 풀링: 각 Mac의 통합 메모리를 전체 클러스터에서 액세스할 수 있게 됩니다.
- 모델 분할: 대규모 AI 모델이 기기 간에 비례적으로 분할됩니다.
- 병렬 처리: 가용 리소스에 따라 워크로드가 분산됩니다.
- 저지연 통신: 직접 메모리 액세스로 네트워크 병목 현상을 제거합니다.
메모리 풀 구성 예시:
| 구성 | 총 메모리 | 사용 사례 |
|---|---|---|
| 2x Mac Studio (512GB) | 1TB 공유 | Kimi K2 Thinking (594GB) |
| 4x Mac Studio (512GB) | 2TB 공유 | 여러 개의 1조 파라미터 모델 |
| 4x Mac mini M4 Pro (64GB) | 256GB 공유 | 70B-200B 파라미터 모델 |
Apple Silicon 통합 메모리의 이점
Mac 클러스터링이 효과적인 주요 이유 중 하나는 Apple Silicon의 통합 메모리 아키텍처에 있습니다. GPU와 CPU가 별도의 메모리 풀을 가진 전통적인 컴퓨터와 달리, Apple Silicon은 모든 처리 장치 간에 메모리를 공유합니다.
클러스터링을 위한 통합 메모리의 이점:
| 측면 | 전통적 아키텍처 | Apple Silicon |
|---|---|---|
| 메모리 액세스 | GPU가 RAM에서 데이터를 복사함 | 직접 공유 액세스 |
| 대역폭 | PCIe로 제한됨 (64 GB/s) | 최대 800 GB/s (M3 Ultra) |
| 효율성 | 데이터 복제 필요 | 제로 카피(Zero-copy) 작업 |
| 확장성 | VRAM이 모델 크기를 제한함 | 통합 풀이 선형적으로 확장됨 |
여러 대의 Mac을 클러스터링하면 효과적으로 더 큰 통합 메모리 풀을 생성하게 됩니다. 한 대의 Mac 메모리에 너무 큰 모델도 노드 간에 분할하여 각 Mac이 일부를 보유하고 Thunderbolt 5를 통해 액세스를 공유함으로써 실행할 수 있습니다.
실제 예시:
- 단일 Mac Studio (512GB): 최대 약 450GB 모델 실행 가능 (여유 공간 확보)
- 2x Mac Studio (1TB 풀): 최대 약 900GB 모델 실행 가능
- 4x Mac Studio (2TB 풀): 최대 약 1.8TB 모델 실행 가능
이러한 선형 확장성 덕분에 Mac 하드웨어에서 Kimi K2 Thinking과 같은 1조 파라미터 모델을 실행할 수 있습니다.
하드웨어 요구 사항 및 호환성
호환되는 Mac 모델
Thunderbolt 5 기본 지원 (전체 80Gbps):
| 기기 | Thunderbolt 5 포트 | 최대 메모리 | 비고 |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512GB | 대규모 클러스터에 최적 |
| Mac mini (M4 Pro) | 3 (전면) | 64GB | 가성비 좋은 노드 |
| MacBook Pro 14" (M4 Pro) | 3 | 48GB | 휴대용 클러스터링 |
| MacBook Pro 16" (M4 Max) | 3 | 128GB | 고용량 메모리 휴대용 |
중요 사양:
- Thunderbolt 5 속도: 80Gbps 양방향 (비디오용 120Gbps 버스트 모드)
- 메모리 대역폭: M4 Pro는 273GB/s, M4 Max는 546GB/s 제공
- 케이블 길이: 최적의 성능을 위해 2미터 미만 유지
- 케이블 유형: 표준 Thunderbolt 5 케이블 (USB4 v2 호환)
추천 클러스터 구성
보급형 클러스터 (머신 러닝 실험용):
4x Mac mini M4 Pro (각 24GB)
총 메모리: 96GB 공유
비용: 약 7,200달러
최적 용도: 최대 70B 파라미터 모델
전력 소비: 유휴 시 약 60W, 피크 시 약 200W
소음 수준: 거의 무소음
이 구성은 분산 ML을 배우는 개발자, 오픈 소스 모델을 실험하는 소규모 팀, 또는 Llama 3.1 8B 및 Mistral 7B와 같은 소형 모델을 뛰어난 성능으로 실행하는 데 완벽합니다.
전문가용 클러스터 (프로덕션 AI 워크로드):
4x Mac mini M4 Pro (각 64GB)
총 메모리: 256GB 공유
비용: 약 13,200달러
최적 용도: 최대 200B 파라미터 모델
전력 소비: 유휴 시 약 80W, 피크 시 약 300W
소음 수준: 거의 무소음
전문가 등급은 Llama 3.1 70B와 같은 중대형 모델을 실행할 수 있으며 엔터프라이즈급 모델에서 추론을 실행할 수 있습니다. 이는 로컬 AI를 배포하는 대부분의 기업에게 가장 적합한 지점입니다.
엔터프라이즈 클러스터 (1조 파라미터 모델):
4x Mac Studio M3 Ultra (각 512GB)
총 메모리: 2TB 공유
비용: 약 47,000달러 (€47,000)
최적 용도: Kimi K2 Thinking, DeepSeek V3, 프런티어 모델
전력 소비: 유휴 시 약 100W, 피크 시 약 500W
소음 수준: 부하 시 보통
이 최상위 구성은 추론 워크로드에서 데이터 센터 GPU 클러스터와 일치하거나 능가하면서도 전력 소비는 아주 적고 전문 인프라가 필요하지 않습니다.
Thunderbolt 5 케이블 선택 가이드
올바른 케이블을 선택하는 것은 클러스터 성능에 매우 중요합니다. 모든 케이블이 전체 Thunderbolt 5 속도를 지원하는 것은 아닙니다.
추천 케이블:
| 케이블 | 길이 | 최대 속도 | 가격대 |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbps | $69-79 |
| OWC Thunderbolt 5 | 0.8m | 80 Gbps | $50-60 |
| CalDigit TB5 Cable | 1m | 80 Gbps | $45-55 |
| Belkin Connect Pro | 1m | 80 Gbps | $40-50 |
케이블 선택 팁:
- 1미터 미만 유지: 전체 80Gbps 속도를 위해서는 짧고 품질 좋은 케이블이 필요합니다.
- USB4 v2 인증 확인: Thunderbolt 5 호환성을 보장합니다.
- 어댑터 피하기: TB5 대 TB5 직접 연결만 사용하세요.
- 신뢰할 수 있는 브랜드 제품 구매: 모조품 케이블은 정격 속도를 내지 못할 수 있습니다.
- 배포 전 케이블 테스트:
system_profiler SPThunderboltDataType을 사용하여 링크 속도를 확인하세요.
경고: 온라인에서 판매되는 많은 "Thunderbolt 5 호환" 케이블은 Thunderbolt 4 속도만 지원합니다. 구매 전 사양을 반드시 확인하세요.
소프트웨어 스택: MLX 및 EXO 프레임워크
MLX 분산 컴퓨팅 이해하기
MLX는 Apple Silicon에서의 머신 러닝을 위해 특별히 설계된 Apple의 오픈 소스 배열 프레임워크입니다. 여러 대의 Mac에 걸친 분산 컴퓨팅을 기본적으로 지원합니다.
MLX 주요 기능:
- 통합 메모리 액세스: Apple Silicon의 통합 메모리 아키텍처 활용
- 지연 평가(Lazy Evaluation): 결과가 필요할 때만 계산 실행
- 동적 컴파일: 최적의 성능을 위한 적시(Just-in-time) 컴파일
- 분산 기본 요소(Primitives): 다중 기기 작업에 대한 내장 지원
MLX 통신 백엔드
MLX는 다양한 사용 사례에 대해 세 가지 통신 백엔드를 지원합니다.
| 백엔드 | 속도 | 최적 용도 | 설정 복잡도 |
|---|---|---|---|
| Ring | 가장 빠름 | Thunderbolt 연결 | 중간 |
| MPI | 빠름 | 이더넷 네트워크 | 높음 |
| NCCL | 해당 없음 | CUDA 환경 | Mac에서 불가 |
Ring 백엔드는 직접적인 P2P(Peer-to-Peer) 연결에 최적화되어 있으므로 Thunderbolt 5 클러스터에 권장됩니다.
분산 학습 vs 추론 이해하기
설정을 시작하기 전에 Mac 클러스터링의 두 가지 주요 사용 사례를 이해하는 것이 중요합니다.
분산 추론 (모델 실행): 이는 대부분의 사용자에게 주된 사용 사례입니다. 추론을 실행할 때:
- 모델은 가용 메모리에 따라 여러 대의 Mac에 분할됩니다.
- 각 Mac은 모델 가중치의 일부를 보유합니다.
- 생성 중 데이터는 필요에 따라 노드 간에 흐릅니다.
- 학습은 일어나지 않습니다—사전 학습된 모델을 사용하는 것입니다.
분산 학습 (모델 생성): 연구원 및 고급 사용자를 위한 것입니다:
- 학습 데이터가 노드 간에 분할됩니다 (데이터 병렬 처리).
- 각 배치 후 모든 노드에서 기울기(gradient)가 평균화됩니다.
- 모델 가중치가 주기적으로 동기화됩니다.
- 노드 간 통신이 훨씬 더 많이 필요합니다.
| 사용 사례 | 대역폭 요구 사항 | 복잡도 | 일반적인 사용자 |
|---|---|---|---|
| 추론 | 중간 (모델 로딩) | 낮음 | 대부분의 사용자 |
| 파인 튜닝 | 높음 (기울기 동기화) | 중간 | ML 엔지니어 |
| 전체 학습 | 매우 높음 (지속적 동기화) | 높음 | 연구원 |
대부분의 Mac 클러스터 사용자에게 주된 목표는 추론입니다. 즉, 단일 기기에 맞지 않는 대규모 모델을 실행하는 것입니다.
EXO: 간소화된 클러스터 관리
EXO(Exo Labs 제공)는 AI 클러스터 구축을 위한 더 높은 수준의 추상화를 제공합니다. Apple은 EXO의 프로토콜을 macOS Tahoe 26.2에 통합했습니다.
EXO 주요 기능:
- 자동 검색: 네트워크상의 다른 기기를 자동으로 감지
- P2P 아키텍처: 마스터-워커 계층 구조 없음
- 지능형 분할: 기기 성능에 따라 모델을 최적으로 분할
- ChatGPT 호환 API:
localhost:52415의 OpenAI 호환 엔드포인트
단계별 클러스터 설정 가이드
전제 조건
시작하기 전에 다음을 확인하세요.
- 모든 Mac에 macOS Tahoe 26.2 이상이 설치되어 있어야 합니다.
- Thunderbolt 5 케이블 (2미터 미만)
- Python 3.12+ 설치
- 기기 간 비밀번호 없는 SSH 구성
- 모든 기기가 동일한 네트워크에 있어야 함 (초기 검색용)
방법 1: MLX 네이티브 설정 (권장)
1단계: MLX 설치
# pip를 통한 MLX 설치
pip install mlx

# 설치 확인
python -c "import mlx.core as mx; print(mx.__version__)"
2단계: Thunderbolt 네트워크 구성
Thunderbolt 5 케이블을 사용하여 Mac을 링 토폴로지로 연결합니다.
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1MLX 분산 구성 도구를 사용합니다.
# Thunderbolt 링 검색 및 구성 생성
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# 모든 노드 자동 설정 (비밀번호 없는 sudo 필요)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
3단계: 호스트 파일 구성 생성
ring-4.json 파일을 생성합니다.
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
4단계: 분산 통신 테스트
테스트 스크립트 test_distributed.py를 생성합니다.
import mlx.core as mx

# 분산 그룹 초기화
world = mx.distributed.init()

# 각 프로세스가 자신의 랭크를 포함하는 배열 생성
x = mx.ones(10) * world.rank()

# 모든 프로세스에 걸쳐 배열 합계 계산
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
테스트를 시작합니다.
mlx.launch --hostfile ring-4.json test_distributed.py예상 출력 (4개 노드):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
방법 2: EXO 설정 (사용자 친화적)
1단계: EXO 복제 및 설치
# 리포지토리 복제
git clone https://github.com/exo-explore/exo.git
cd exo

# 의존성 설치
pip install -e .

# 또는 설치 스크립트 사용
source install.sh
2단계: Apple Silicon용 MLX 구성
# MLX 구성 스크립트 실행
./configure_mlx.sh
이렇게 하면 Apple Silicon Mac에서 GPU 메모리 할당이 최적화됩니다.
3단계: 클러스터 시작
각 노드에서 동일한 명령을 실행합니다.
exoEXO는 다음을 수행합니다.
- P2P 통신을 통해 다른 노드를 자동으로 검색
- 링 메모리 가중치 분할 적용
http://localhost:52415에서 웹 인터페이스 시작http://localhost:52415/v1/chat/completions에서 API 엔드포인트 시작
4단계: 인터페이스 액세스
브라우저에서 http://localhost:52415를 열어 ChatGPT와 유사한 인터페이스로 클러스터와 상호 작용합니다.
대규모 언어 모델 실행
모델 다운로드
EXO는 다양한 모델 소스를 지원합니다.
# Hugging Face에서 다운로드
exo download moonshotai/Kimi-K2-Instruct

# Llama 모델 다운로드
exo download meta-llama/Llama-3.1-70B-Instruct
모델별 메모리 요구 사항
| 모델 | 파라미터 | 필요 메모리 | 권장 클러스터 |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16GB | 단일 Mac |
| Llama 3.1 70B | 70B | 140GB | 3x Mac mini (64GB) |
| Llama 3.1 405B | 405B | 810GB | 4x Mac Studio (512GB) |
| Kimi K2 | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
| Kimi K2 Thinking | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
Kimi K2 Thinking 실행하기
Kimi K2 Thinking 모델은 Thunderbolt 5 클러스터링의 힘을 보여줍니다. 이는 320억 개의 활성 파라미터를 가진 1조 파라미터의 전문가 혼합(MoE) 모델입니다. Moonshot AI가 개발한 이 모델은 오픈 소스 추론 모델의 최첨단을 나타냅니다.
Kimi K2의 특별한 점:
- 아키텍처: 전문가 혼합(MoE), 총 파라미터 1T
- 활성 파라미터: 추론당 32B 파라미터만 활성
- 컨텍스트 창: 256K 토큰
- 양자화: 효율성을 위한 네이티브 INT4
- 디스크 크기: 약 594GB (풀 프리시전의 경우 1TB 이상)
import mlx.core as mx
from mlx_lm import load, generate

# 분산 환경 초기화
world = mx.distributed.init()

# 모델 로드 (노드 간에 자동으로 분산됨)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# 텍스트 생성
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
성능 결과 (4x Mac Studio M3 Ultra):
- 총 메모리: 2TB 통합
- 전력 소비: 500W 미만 (GPU 클러스터 5,000W+ 대비)
- 토큰 생성: 클라우드 추론과 경쟁력 있음
- 비용 효율성: NVIDIA RTX 5090 클러스터보다 10배 낮은 전력
성능 최적화
네트워크 토폴로지 모범 사례
링 토폴로지 (4개 이상의 노드에 권장):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
스타 토폴로지 (간단한 2-3개 노드):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3케이블 및 연결 가이드라인
| 요소 | 권장 사항 | 영향 |
|---|---|---|
| 케이블 길이 | 2미터 미만 | 전체 80Gbps 유지 |
| 케이블 품질 | 인증된 TB5/USB4 v2 | 데이터 오류 방지 |
| 허브 피하기 | 직접 연결 | 허브 사용 시 10Gbps로 속도 저하 |
| 포트 선택 | 사용 가능한 모든 포트 사용 | 대역폭 극대화 |
메모리 및 컴퓨팅 균형 조정
이기종 클러스터(혼합 하드웨어)를 구축할 때:
# MLX는 기기 성능에 따라 자동으로 균형을 맞춥니다
# 하지만 분할을 사용자 정의할 수 있습니다:

import mlx.core as mx

# 분산 월드 정보 가져오기
world = mx.distributed.init()

# 사용자 정의 가중치 할당
weights = {
    0: 2.0,  # Mac Studio는 2배 지분
    1: 1.0,  # Mac mini는 1배 지분
    2: 1.0,
    3: 1.0
}
일반적인 문제 해결
연결 문제
문제: 노드가 서로를 검색하지 못함
# Thunderbolt 연결 상태 확인
system_profiler SPThunderboltDataType

# 네트워크 인터페이스 확인
networksetup -listallhardwareports

# 직접 연결 테스트
ping mac2.local
문제: 느린 전송 속도
# Thunderbolt 대역폭 테스트
iperf3 -c mac2.local -p 5201

# 예상: TB5의 경우 약 9-10 GB/s
# 더 낮은 경우: 케이블 길이/품질 확인
MLX 오류
문제: "사용 가능한 분산 백엔드 없음 (No distributed backend available)"
# MLX가 제대로 설치되었는지 확인
pip install --upgrade mlx

# Python 버전 확인 (3.12+ 필요)
python --version
문제: 분산 추론 시 "메모리 부족 (Out of memory)"
# 메모리 효율 모드 활성화
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # 사용 가능한 메모리의 95% 사용

# 또는 배치 크기 줄이기
generate(model, tokenizer, prompt=prompt, max_tokens=100)
SSH 구성
모든 노드 간에 비밀번호 없는 SSH가 설정되었는지 확인하세요.
# 필요한 경우 SSH 키 생성
ssh-keygen -t ed25519

# 모든 노드에 복사
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# 테스트
ssh mac2.local "hostname"
전력 효율성 및 비용 분석
전력 소비 비교
| 구성 | 전력 소비 | 성능 | 달러당 성능 |
|---|---|---|---|
| 4x Mac Studio (512GB) | ~500W | 1조 파라미터 가능 | 최고 |
| NVIDIA H100 클러스터 (4x) | ~2,800W | 유사한 성능 | 5.6배 더 많은 전력 |
| NVIDIA RTX 5090 클러스터 | ~2,300W | 제한된 VRAM | 4.6배 더 많은 전력 |
총 소유 비용 (TCO)
Mac Studio 클러스터 (2TB 구성):
- 하드웨어: 47,000달러
- 연간 전력 (24/7): 약 500달러
- 유지보수: 최소
- 5년 TCO: 약 49,500달러
동급 GPU 클러스터:
- 하드웨어: 100,000달러 이상
- 연간 전력 (24/7): 약 3,000달러
- 냉각 인프라: 10,000달러 이상
- 유지보수: 상당함
- 5년 TCO: 약 130,000달러 이상
사용 사례 및 애플리케이션
머신 러닝 연구
Thunderbolt 5 클러스터링은 학계 및 기업 ML 연구에 탁월합니다.
연구 응용 분야:
- 모델 학습: 기울기 동기화를 통해 여러 대의 Mac에 걸친 분산 학습
- 파인 튜닝: 독점 데이터셋에서 대규모 모델의 로컬 파인 튜닝
- 추론: 실험을 위해 1조 파라미터 모델을 로컬에서 실행
- 소거 연구(Ablation Studies): 클라우드 GPU 가용성을 기다리지 않고 신속한 프로토타이핑
연구 워크플로 예시:
import mlx.core as mx
from mlx_lm import load, generate

# 파인 튜닝된 모델 로드
model, tokenizer = load("./my-finetuned-model")

# 분산 클러스터 전반에서 실험 실행
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
대학 및 연구실의 이점:
- 예측 불가능한 클라우드 청구 대비 고정된 하드웨어 비용
- 민감한 연구를 위한 완벽한 데이터 개인정보 보호
- 분산 컴퓨팅 과정을 위한 교육 리소스
- 재현 가능하고 출판 가능한 실험
전문 크리에이티브 워크플로
Apple의 크리에이티브 생태계와의 통합은 독특한 이점을 제공합니다.
비디오 제작:
- 분산 렌더링: Final Cut Pro, DaVinci Resolve, Motion 프로젝트
- AI 지원 편집: 장면 감지, 전사를 위한 로컬 AI 모델
- 색 보정: 노드 간 GPU 가속 색상 처리
- 8K RAW 처리: 대용량 비디오 파일을 위한 충분한 메모리
오디오 제작:
- Logic Pro 분산 처리: 노드 간 플러그인 렌더링
- AI 음악 생성: 로컬 음악 AI 모델 실행
- 오디오 복원: 로컬에서 ML 기반 노이즈 감소
3D 및 모션 그래픽:
- Blender 분산 렌더링: Mac 클러스터 전반에서 Cycles 렌더링
- Cinema 4D: 클러스터 지원 CPU 렌더링
- Houdini: 시뮬레이션 분산 (적절한 플러그인 사용)
크리에이티브 워크플로에 대한 자세한 내용은 macOS Tahoe 전문 워크플로 혁명 가이드를 참조하세요.
개발 및 테스트
현대 AI 애플리케이션 개발은 로컬 클러스터의 이점을 크게 누립니다.
AI 기반 애플리케이션 개발:
# 예: 로컬 추론으로 AI 챗봇 구축
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
개발자 이점:
- 로컬 LLM 개발: API 속도 제한 없이 테스트 및 반복
- CI/CD 가속화: 분산 빌드 및 테스트 시스템
- AI 애플리케이션 개발: 로컬 AI 백엔드로 앱 구축
- 비용 없는 실험: 개발 중 요청당 요금 없음
테스트 이점:
- 프로덕션 규모 모델에 대해 로컬에서 테스트
- 테스트 환경에서 네트워크 지연 없음
- 일관되고 재현 가능한 테스트 결과
- 모델 버전에 대한 완전한 통제
개발 환경 구성에 대해서는 macOS Tahoe 개발자 설정 가이드를 확인하세요.
엔터프라이즈 배포 시나리오
대규모 조직은 다음과 같은 목적으로 Mac 클러스터를 배포하고 있습니다.
내부 AI 비서:
- 프라이빗 ChatGPT 스타일 인터페이스
- 문서 분석 및 요약
- 코드 리뷰 및 생성
- 회의 전사 및 분석
규정 준수가 중요한 산업:
- 의료: HIPAA 준수 AI 처리
- 금융: 온프레미스 모델 추론
- 법률: 기밀 문서 분석
- 정부: 에어갭 AI 기능
기업용 비용 편익 분석:
| 시나리오 | 클라우드 비용/년 | Mac 클러스터 비용/년 | 절감액 |
|---|---|---|---|
| 라이트 (1M 토큰/일) | 약 11,000달러 | 약 3,000달러 (상각) | 73% |
| 미디엄 (10M 토큰/일) | 약 110,000달러 | 약 15,000달러 (상각) | 86% |
| 헤비 (100M 토큰/일) | 약 1.1M 달러 | 약 60,000달러 (상각) | 95% |
Mac 클러스터링의 미래
M5와 그 이후
Apple M5 칩은 모든 GPU 코어에 Neural Accelerator를 도입하여 4배의 AI 성능 향상을 제공합니다. Thunderbolt 5 클러스터링과 결합 시:
- 향상된 MLX 지원: M5 Neural Accelerator에 대한 완전한 액세스
- 향상된 메모리 대역폭: 칩당 153GB/s
- 더 나은 전력 효율성: 와트당 더 많은 성능
Mac Pro에 대한 시사점
보도에 따르면 Apple은 내부적으로 "Mac Pro를 사실상 포기"했다고 합니다. Thunderbolt 5 클러스터링은 대안 경로를 제공합니다.
- 확장 가능한 성능: 필요에 따라 노드 추가
- 낮은 진입 비용: 작게 시작하여 나중에 확장
- 유연성: 다른 Mac 모델 혼합
- 미래 보장: 시간이 지남에 따라 개별 노드 업그레이드
보안 및 개인정보 보호 고려 사항
로컬 처리가 중요한 이유
클라우드 기반 AI 대비 Mac 클러스터링의 가장 큰 장점 중 하나는 완벽한 데이터 개인정보 보호입니다. 프롬프트, 학습 데이터, 생성된 출력은 로컬 네트워크를 절대 벗어나지 않습니다.
개인정보 보호 이점:
- 데이터 전송 없음: 모든 처리가 온프레미스에서 발생
- 규정 준수 용이: HIPAA, GDPR, SOC2 준수 용이
- IP 보호: 독점 데이터가 비공개로 유지됨
- 로그 기록 우려 없음: 사용 로그에 대한 완전한 통제
Mac 클러스터 보안 모범 사례:
- 네트워크 격리: 클러스터를 전용 VLAN에 유지
- 방화벽 구성: 클러스터 포트에 대한 외부 액세스 차단
- SSH 키 관리: ed25519 키 사용, 정기적 교체
- macOS 보안: FileVault 활성화, 시스템 업데이트 유지
- 물리적 보안: 서버실 액세스 보안
포괄적인 macOS 보안 구성은 macOS Tahoe 보안 및 개인정보 보호 가이드를 참조하세요.
실제 성능 벤치마크
추론 속도 비교
커뮤니티 테스트 및 Apple 시연 기반:
| 모델 | 구성 | 토큰/초 | 비교 |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64GB) | ~35 tok/s | RTX 4090과 비슷 |
| Llama 3.1 405B | 4x Mac Studio (512GB) | ~15 tok/s | 클라우드 A100 능가 |
| Kimi K2 | 2x Mac Studio (512GB) | ~20 tok/s | 최초의 로컬 1조 파라미터 |
| DeepSeek V3 | 4x Mac Studio (512GB) | ~12 tok/s | 이전에는 클라우드 전용 |
지연 시간 분석
| 지표 | Mac 클러스터 | 클라우드 API | 차이 |
|---|---|---|---|
| 첫 번째 토큰 | 100-500ms | 500-2000ms | 2-10배 빠름 |
| 일관된 지연 시간 | 예 | 가변적 | 더 예측 가능 |
| 콜드 스타트 | 없음 | 5-30초 | 대기 없음 |
| 가용성 | 100% (로컬) | 99.9% | 중단 없음 |
토큰당 비용 비교
1년 24/7 가동 가정:
| 솔루션 | 하드웨어 비용 | 운영 비용 | 1년 총계 | 1M 토큰당 비용 |
|---|---|---|---|---|
| 4x Mac Studio 클러스터 | $47,000 | ~$500 | $47,500 | ~$0.02 |
| OpenAI GPT-4 | $0 | 사용량 기반 | 가변적 | ~$30.00 |
| Claude API | $0 | 사용량 기반 | 가변적 | ~$15.00 |
| AWS Bedrock | $0 | 사용량 기반 | 가변적 | ~$10.00 |
헤비 유저(연간 1억 토큰 이상)의 경우 로컬 Mac 클러스터링이 훨씬 경제적입니다.
자주 묻는 질문 (FAQ)
클러스터에 몇 대의 Mac을 연결할 수 있나요?
실제 제한은 토폴로지에 따라 다릅니다. 직접 Thunderbolt 연결(허브 피함)을 사용하면 4-6대의 Mac을 효율적으로 연결할 수 있습니다. 링 토폴로지를 사용하면 전체 대역폭을 유지하면서 더 많은 노드로 확장할 수 있습니다. 6개 노드를 초과하면 대역폭 병목 현상을 피하기 위해 신중한 토폴로지 계획이 필요합니다.
클러스터링을 위해 동일한 Mac이 필요한가요?
아니요, MLX와 EXO는 이기종 클러스터를 지원합니다. 그러나 클러스터는 가장 느린 구성 요소에 의해 제한됩니다. 최상의 결과를 위해 유사한 세대의 Mac을 사용하고 Thunderbolt 버전을 일치시키세요. 메모리 분산은 각 노드의 가용 RAM에 따라 가중치가 적용됩니다.
클러스터에서 Thunderbolt 4 Mac을 사용할 수 있나요?
네, 하지만 해당 연결의 대역폭은 40Gbps로 제한됩니다. Thunderbolt 5와 4는 하위 호환됩니다. 세대를 혼합하면 시스템은 더 낮은 속도로 작동합니다. 최상의 성능을 위해 TB4 노드를 링 중간이 아닌 리프 노드로 유지하세요.
클러스터링에 필요한 최소 메모리는 얼마인가요?
총 클러스터 메모리는 작업 여유 공간을 포함하여 모델의 메모리 요구 사항을 초과해야 합니다. Llama 3.1 70B(140GB 모델)의 경우 최소 3대의 Mac(각 48GB, 총 144GB)이 필요합니다. 모델 크기보다 10-20%의 여유 공간을 두는 것이 좋습니다.
Mac 클러스터링은 학습에 적합한가요, 아니면 추론에만 적합한가요?
둘 다입니다! MLX는 노드 간 기울기 평균화를 통한 분산 학습을 지원합니다. 그러나 대규모 모델의 메모리 풀링 이점 때문에 추론이 주된 사용 사례입니다. 학습은 더 많은 노드 간 통신이 필요하며 네트워크 지연에 더 민감합니다.
클라우드 GPU 인스턴스와 비교하면 어떤가요?
장기간 사용(6개월 이상의 정기적 사용)의 경우 Mac 클러스터링이 더 비용 효율적입니다. 하드웨어를 소유하고 시간당 요금이 없으며 경쟁력 있는 성능을 얻을 수 있습니다. 가끔 사용하거나 실험하는 경우 처음에는 클라우드 인스턴스가 더 경제적일 수 있습니다.
클러스터를 24/7 실행할 수 있나요?
물론입니다. Mac 하드웨어는 지속적인 작동을 위해 설계되었습니다. 특히 Mac Studio는 지속적인 워크로드에 대해 뛰어난 열 관리 기능을 갖추고 있습니다. 활성 상태 보기 또는 sudo powermetrics를 사용하여 온도를 모니터링하고 적절한 환기를 확보하세요.
한 노드가 실패하면 어떻게 되나요?
현재 MLX 클러스터링은 핫 스왑이나 자동 장애 조치를 지원하지 않습니다. 노드 연결이 끊어지면 작업이 실패하고 다시 시작해야 합니다. 중요한 워크로드의 경우 코드에 체크포인트를 구현하여 마지막으로 저장된 상태에서 다시 시작하세요.
AI 워크로드를 실행하는 동안 클러스터를 사용할 수 있나요?
네, 하지만 성능에 영향을 줄 수 있습니다. EXO 인터페이스는 다른 작업에 Mac을 사용하는 동안 백그라운드 작업을 허용합니다. 최상의 추론 성능을 위해 무거운 AI 워크로드 중에는 다른 활동을 최소화하세요.
결론
macOS Tahoe 26.2의 Thunderbolt 5 클러스터링은 로컬 AI 컴퓨팅의 패러다임 전환을 나타냅니다. 여러 대의 Mac을 통합 슈퍼컴퓨터로 결합함으로써 사용자는 기존 GPU 클러스터 비용의 일부만으로 1조 파라미터 모델을 실행할 수 있습니다.
주요 이점:
- GPU 대안보다 10배 낮은 전력 소비
- 특별한 하드웨어 불필요
- MLX 및 EXO로 간편한 설정
- 2개 노드에서 6개 이상으로 확장 가능
- 로컬 프라이빗 AI 처리
Apple 생태계에 투자한 사용자에게는 이 기능 하나만으로도 macOS Tahoe 26.2로 업그레이드할 정당한 이유가 될 수 있습니다. 전체 업데이트 지침은 macOS Tahoe 26.2 업데이트 가이드를 확인하세요.
AI 워크로드에 맞게 Mac을 최적화할 준비가 되셨나요? 대규모 모델을 위한 충분한 공간을 확보하려면 macOS Tahoe 스토리지 관리 가이드부터 시작하세요.
출처
- macOS Tahoe의 ML, GPU 및 Thunderbolt 5 클러스터링 부스트 - Apple Insider, 2025년 11월
- macOS Tahoe 26.2에서 Mac 클러스터를 AI 슈퍼컴퓨터로 만들 수 있습니다 - Engadget, 2025년 11월
- Mac Studio 클러스터는 우리가 더 이상 Mac Pro를 필요로 하지 않는 이유 중 하나일 뿐입니다 - 9to5Mac, 2025년 11월
- AI 클러스터: 2TB의 Mac 4대로 거대 모델 Kimi K2 Thinking 실행 가능 - Heise Online, 2025년 11월
- MLX 분산 통신 문서 - Apple MLX 공식 문서
- EXO: 집에서 나만의 AI 클러스터 실행 - EXO Labs GitHub
- MLX로 Apple Silicon에서 대규모 언어 모델 탐색 - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Moonshot AI 공식