macOS Tahoe 26.2 Thunderbolt 5 クラスタリングガイド:自分だけのAIスーパーコンピュータを構築しよう
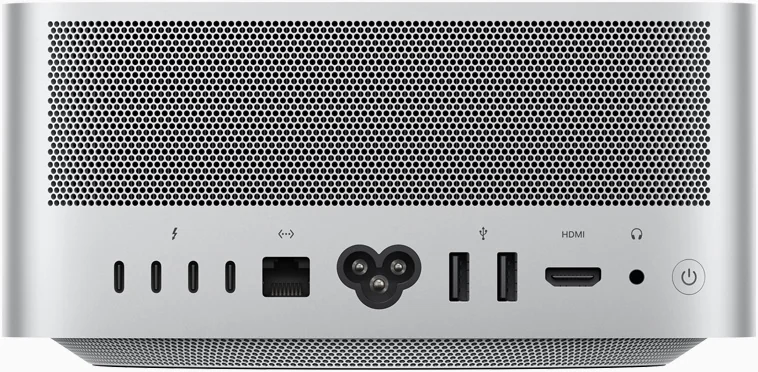
macOS Tahoe 26.2のThunderbolt 5でMacクラスタを構築するための完全ガイド。MLXフレームワークのセットアップ、EXOの設定、ハードウェア要件を学び、1兆パラメータのAIモデルをローカルで実行しましょう。
macOS Tahoe 26.2は、Thunderbolt 5クラスタリングを使用して複数のMacを統合AIスーパーコンピュータに変える画期的な機能を導入しました。この包括的なガイドでは、ハードウェア要件から、Kimi K2 Thinkingのような1兆パラメータモデルを自分のMacクラスタで実行する方法まで、すべてを網羅しています。
重要なポイント
- macOS Tahoe 26.2の Thunderbolt 5 クラスタリング は、最大80 Gbpsの双方向速度で複数のMacを接続可能にします
- 512GBのメモリを搭載した4台のMac Studio で、1兆パラメータのKimi K2 Thinkingモデルを500W未満の総消費電力で実行可能です
- 互換性のあるデバイス には、M4 Pro Mac mini、M4 Pro/Max MacBook Pro、M3 Ultra Mac Studioが含まれます
- MLX フレームワーク と EXO 1.0 ソフトウェアが分散コンピューティングインフラストラクチャを提供します
- 特別なハードウェアは不要 - 2メートル未満の標準的なThunderbolt 5ケーブルのみが必要です
エグゼクティブサマリー:Macクラスタリング技術を理解する
なぜThunderbolt 5 クラスタリングが重要なのか
macOS Tahoe 26.2のリリースは、Appleのプロフェッショナルコンピューティング戦略における極めて重要な瞬間を示しています。Appleは初めて、Thunderbolt 5のかつてない帯域幅を使用して、複数のMacを統合コンピューティングクラスタに接続するためのネイティブかつ最適化されたサポートを提供します。これは単なる段階的な改善ではなく、Macハードウェアで何が可能かを根本的に変えるものです。
解決する問題:
大規模なAIモデルの実行には、従来、大量の電力を消費する高価なGPUクラスタが必要でした。1兆パラメータモデルの一般的なセットアップは以下のようになります:
- NVIDIA H100 クラスタ:40万ドル以上のハードウェア、10kW以上の消費電力
- クラウドGPUインスタンス:高性能インスタンスの場合、1時間あたり2〜5ドル
- カスタムデータセンターインフラ:冷却、配電、ネットワーク
Macクラスタによるソリューション:
Thunderbolt 5 クラスタリングを使用すると、以下のような構成で同等の機能を実現できます:
- 4x Mac Studio:47,000ドルのハードウェア(H100と比較して88%のコスト削減)
- 消費電力:500W未満(95%削減)
- インフラ不要:標準的なオフィス環境で利用可能
- ローカル処理:完全なデータプライバシー
誰がMacクラスタリングの恩恵を受けるのか?
AI研究者およびMLエンジニア:
- クラウドに依存せずにフロンティアモデルをローカルで実行
- 専用ハードウェアでより高速に反復
- トレーニングデータの完全な管理を維持
クリエイティブプロフェッショナル:
- 複数のMac間での分散ビデオレンダリング
- ローカルモデルを使用したAI支援編集
- ネットワーク遅延のない大容量ファイル処理
企業ITチーム:
- プライベートAIの展開
- コスト予測可能なインフラストラクチャ
- GPUクラスタと比較して簡素化されたメンテナンス
独立系開発者:
- ローカル推論を使用したAIアプリケーションの構築
- 開発中に大規模モデルに対してテスト
- 継続的なAPIコストなしで製品を出荷
Thunderbolt 5 Macクラスタリングとは?
Mac分散コンピューティングの進化
Thunderbolt 5 Macクラスタリングは、Macにおける分散コンピューティングの現代的な復活を象徴しています。長年のAppleユーザーは、複数のMacをスーパーコンピュータに変えたXgridを覚えているかもしれません。macOS Tahoe 26.2の新しいThunderbolt 5クラスタリングも同様のコンセプトに従っていますが、劇的に高速な速度で動作します。
歴史的背景:
- Xgrid 時代:イーサネット速度(1-10 Gbps)に制限
- Thunderbolt 4 クラスタ:40 Gbps、ハブ使用時は10 Gbpsに速度低下
- Thunderbolt 5 クラスタ:完全な80 Gbps双方向、120 Gbpsバーストモード
Thunderbolt 5 クラスタリングの仕組み
このクラスタリング技術は リモートダイレクトメモリアクセス (RDMA) を使用しており、CPUのオーバーヘッドなしにあるMacが別のMacのメモリに直接アクセスできるようにします。Thunderbolt 5経由で複数のMacを接続すると:
- メモリプーリング:各Macのユニファイドメモリがクラスタ全体からアクセス可能になります
- モデル分割:大規模なAIモデルがマシン間で比例的に分割されます
- 並列処理:ワークロードが利用可能なリソースに基づいて分散されます
- 低遅延通信:ダイレクトメモリアクセスによりネットワークのボトルネックが解消されます
メモリプール構成例:
| 構成 | 合計メモリ | ユースケース |
|---|---|---|
| 2x Mac Studio (512GB) | 1TB 共有 | Kimi K2 Thinking (594GB) |
| 4x Mac Studio (512GB) | 2TB 共有 | 複数の1兆パラメータモデル |
| 4x Mac mini M4 Pro (64GB) | 256GB 共有 | 70B-200B パラメータモデル |
Appleシリコンのユニファイドメモリの利点
Macクラスタリングがこれほど効果的である主な理由の一つは、Appleシリコンのユニファイドメモリ アーキテクチャにあります。GPUとCPUが別々のメモリプールを持つ従来のコンピュータとは異なり、Appleシリコンはすべての処理ユニット間でメモリを共有します。
クラスタリングにおけるユニファイドメモリの利点:
| 側面 | 従来のアーキテクチャ | Appleシリコン |
|---|---|---|
| メモリアクセス | GPUがRAMからデータをコピー | 直接共有アクセス |
| 帯域幅 | PCIeによる制限 (64 GB/s) | 最大800 GB/s (M3 Ultra) |
| 効率性 | データ複製が必要 | ゼロコピー操作 |
| 拡張性 | VRAMがモデルサイズを制限 | 統合プールが線形に拡張 |
複数のMacをクラスタリングすると、実質的により大きなユニファイドメモリプールを作成することになります。1台のMacのメモリに対して大きすぎるモデルでも、ノード間で分割し、各Macがその一部を保持してThunderbolt 5経由でアクセスを共有することで実行可能になります。
実例:
- シングル Mac Studio (512GB):最大約450GBのモデルを実行可能(余裕を持たせて)
- 2x Mac Studio (1TB プール):最大約900GBのモデルを実行可能
- 4x Mac Studio (2TB プール):最大約1.8TBのモデルを実行可能
この線形スケーリングにより、Macハードウェア上でKimi K2 Thinkingのような1兆パラメータモデルの実行が可能になります。
ハードウェア要件と互換性
互換性のあるMacモデル
Thunderbolt 5 ネイティブサポート (フル 80 Gbps):
| デバイス | Thunderbolt 5 ポート | 最大メモリ | 備考 |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512GB | 大規模クラスタに最適 |
| Mac mini (M4 Pro) | 3 (前面) | 64GB | コスト効率の良いノード |
| MacBook Pro 14" (M4 Pro) | 3 | 48GB | ポータブルクラスタリング |
| MacBook Pro 16" (M4 Max) | 3 | 128GB | 高メモリポータブル |
重要な仕様:
- Thunderbolt 5 速度:80 Gbps 双方向(ビデオ用120 Gbpsバーストモード)
- メモリ帯域幅:M4 Proは273GB/s、M4 Maxは546GB/sを提供
- ケーブル長:最適なパフォーマンスのために2メートル未満を維持
- ケーブルタイプ:標準Thunderbolt 5ケーブル(USB4 v2互換)
推奨クラスタ構成
予算重視クラスタ(機械学習の実験用):
4x Mac mini M4 Pro (各24GB)
合計メモリ:96GB 共有
コスト:約7,200ドル
最適:最大70Bパラメータのモデル
消費電力:アイドル時約60W、ピーク時約200W
騒音レベル:ほぼ無音
この構成は、分散MLを学習する開発者、オープンソースモデルを実験する小規模チーム、またはLlama 3.1 8BやMistral 7Bのような小規模モデルを優れたパフォーマンスで実行するのに最適です。
プロフェッショナルクラスタ(本番AIワークロード):
4x Mac mini M4 Pro (各64GB)
合計メモリ:256GB 共有
コスト:約13,200ドル
最適:最大200Bパラメータのモデル
消費電力:アイドル時約80W、ピーク時約300W
騒音レベル:ほぼ無音
プロフェッショナル層は、Llama 3.1 70Bのような中規模から大規模なモデルを解放し、エンタープライズグレードのモデルで推論を実行できます。これは、ローカルAIを展開する大多数の企業にとって最適なスポットです。
エンタープライズクラスタ(1兆パラメータモデル):
4x Mac Studio M3 Ultra (各512GB)
合計メモリ:2TB 共有
コスト:約47,000ドル (€47,000)
最適:Kimi K2 Thinking, DeepSeek V3, フロンティアモデル
消費電力:アイドル時約100W、ピーク時約500W
騒音レベル:負荷時は中程度
この最上位構成は、推論ワークロードにおいてデータセンターのGPUクラスタに匹敵するかそれを上回りながら、消費電力はその数分の一で済み、専門的なインフラも必要としません。
Thunderbolt 5 ケーブル選択ガイド
適切なケーブルを選択することは、クラスタのパフォーマンスにとって非常に重要です。すべてのケーブルが完全なThunderbolt 5速度をサポートしているわけではありません。
推奨ケーブル:
| ケーブル | 長さ | 最大速度 | 価格帯 |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbps | $69-79 |
| OWC Thunderbolt 5 | 0.8m | 80 Gbps | $50-60 |
| CalDigit TB5 Cable | 1m | 80 Gbps | $45-55 |
| Belkin Connect Pro | 1m | 80 Gbps | $40-50 |
ケーブル選択のヒント:
- 1メートル未満を厳守:完全な80 Gbpsには短く高品質なケーブルが必要です
- USB4 v2認証を探す:Thunderbolt 5との互換性を保証します
- アダプタを避ける:TB5対TB5の直接接続のみ
- 信頼できるブランドから購入:模造品のケーブルは定格速度が出ない可能性があります
- 展開前にケーブルをテスト:
system_profiler SPThunderboltDataTypeを使用してリンク速度を確認
警告:オンラインで販売されている多くの「Thunderbolt 5互換」ケーブルは、Thunderbolt 4の速度しか出ません。購入前に必ず仕様を確認してください。
ソフトウェアスタック:MLX と EXO フレームワーク
MLX 分布式コンピューティングを理解する
MLXは、Appleシリコンでの機械学習のために特別に設計されたAppleのオープンソース配列フレームワークです。複数のMac間での分散コンピューティングをネイティブにサポートしています。
MLXの主な機能:
- ユニファイドメモリアクセス:Appleシリコンのユニファイドメモリ アーキテクチャを活用
- 遅延評価:計算は結果が必要な場合にのみ実行されます
- 動的コンパイル:最適なパフォーマンスのためのジャストインタイムコンパイル
- 分散プリミティブ:マルチマシン操作の組み込みサポート
MLX 通信バックエンド
MLXは、さまざまなユースケースに対応する3つの通信バックエンドをサポートしています:
| バックエンド | 速度 | 最適 | セットアップの複雑さ |
|---|---|---|---|
| Ring | 最速 | Thunderbolt接続 | 中程度 |
| MPI | 高速 | イーサネットネットワーク | 高め |
| NCCL | N/A | CUDA環境 | Macでは不可 |
Ringバックエンドは、Thunderbolt 5クラスタに推奨されます。これは、直接的なピアツーピア接続に最適化されているためです。
分布式トレーニングと推論の理解
セットアップに入る前に、Macクラスタリングの2つの主要なユースケースを理解することが重要です:
分散推論(モデルの実行): これは大多数のユーザーにとっての主要なユースケースです。推論を実行する場合:
- モデルは利用可能なメモリに基づいて複数のMacに分割されます
- 各Macはモデルの重みの一部を保持します
- 生成中、データは必要に応じてノード間を流れます
- トレーニングは行われません—事前トレーニングされたモデルを使用しています
分散トレーニング(モデルの作成): 研究者および上級ユーザー向け:
- トレーニングデータはノード間で分割されます(データ並列化)
- 各バッチの後、勾配がすべてのノード間で平均化されます
- モデルの重みは定期的に同期されます
- かなり多くのノード間通信が必要です
| ユースケース | 帯域幅要件 | 複雑さ | 一般的なユーザー |
|---|---|---|---|
| 推論 | 中(モデルロード) | 低 | 大多数のユーザー |
| ファインチューニング | 高(勾配同期) | 中 | MLエンジニア |
| フルトレーニング | 非常に高(常時同期) | 高 | 研究者 |
大多数のMacクラスタユーザーにとって、推論が主な目標です。つまり、1台のマシンには収まらない大規模モデルを実行することです。
EXO:簡素化されたクラスタ管理
EXO(Exo Labs発)は、AIクラスタを構築するためのより高レベルの抽象化を提供します。AppleはEXOのプロトコルをmacOS Tahoe 26.2に統合しました。
EXOの主な機能:
- 自動検出:ネットワーク上の他のデバイスを自動的に検出
- ピアツーピアアーキテクチャ:マスター・ワーカーの階層なし
- インテリジェントな分割:デバイスの機能に基づいてモデルを最適に分割
- ChatGPT互換API:
localhost:52415でのOpenAI互換エンドポイント
ステップバイステップ:クラスタセットアップガイド
前提条件
開始する前に、以下を確認してください:
- すべてのMacに macOS Tahoe 26.2 以降がインストールされていること
- Thunderbolt 5 ケーブル(2メートル未満)
- Python 3.12+ がインストールされていること
- マシン間で パスワードなしSSH が設定されていること
- すべてのマシンが 同じネットワーク にあること(初期検出用)
方法 1: MLX ネイティブセットアップ(推奨)
ステップ 1: MLXのインストール
# pip経由でMLXをインストール
pip install mlx

# インストールの確認
python -c "import mlx.core as mx; print(mx.__version__)"
ステップ 2: Thunderboltネットワークの構成
Thunderbolt 5ケーブルを使用して、Macをリングトポロジーで接続します:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1MLX分散構成ツールを使用します:
# Thunderboltリングを検出し、構成を生成
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# 全ノードの自動セットアップ(パスワードなしsudoが必要)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
ステップ 3: ホストファイル構成の作成
ring-4.json ファイルを作成します:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
ステップ 4: 分布式通信のテスト
テストスクリプト test_distributed.py を作成します:
import mlx.core as mx

# 分布式グループの初期化
world = mx.distributed.init()

# 各プロセスがランクを含む配列を作成
x = mx.ones(10) * world.rank()

# 全プロセス間で配列を合計
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
テストを起動します:
mlx.launch --hostfile ring-4.json test_distributed.py期待される出力(4ノード):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
方法 2: EXO セットアップ(ユーザーフレンドリー)
ステップ 1: EXOのクローンとインストール
# リポジトリをクローン
git clone https://github.com/exo-explore/exo.git
cd exo

# 依存関係をインストール
pip install -e .

# またはインストールスクリプトを使用
source install.sh
ステップ 2: Appleシリコン用MLXの構成
# MLX構成スクリプトを実行
./configure_mlx.sh
これにより、AppleシリコンMacでのGPUメモリ割り当てが最適化されます。
ステップ 3: クラスタの開始
各ノードで同じコマンドを実行します:
exoEXOは以下を実行します:
- ピアツーピア通信経由で他のノードを自動的に検出
- リングメモリの加重分割を適用
http://localhost:52415でWebインターフェースを開始http://localhost:52415/v1/chat/completionsでAPIエンドポイントを開始
ステップ 4: インターフェースへのアクセス
ブラウザで http://localhost:52415 を開き、クラスタと対話するためのChatGPTのようなインターフェースにアクセスします。
大規模言語モデルの実行
モデルのダウンロード
EXOはさまざまなモデルソースをサポートしています:
# Hugging Faceからダウンロード
exo download moonshotai/Kimi-K2-Instruct

# Llamaモデルのダウンロード
exo download meta-llama/Llama-3.1-70B-Instruct
モデル別のメモリ要件
| モデル | パラメータ | 必要メモリ | 推奨クラスタ |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16GB | シングル Mac |
| Llama 3.1 70B | 70B | 140GB | 3x Mac mini (64GB) |
| Llama 3.1 405B | 405B | 810GB | 4x Mac Studio (512GB) |
| Kimi K2 | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
| Kimi K2 Thinking | 1T (32B active) | 594GB | 2x Mac Studio (512GB) |
Kimi K2 Thinking の実行
Kimi K2 Thinkingモデルは、Thunderbolt 5クラスタリングの威力を実証しています。これは、320億の有効パラメータを持つ1兆パラメータのMixture-of-Experts (MoE) モデルです。Moonshot AIによって開発され、オープンソース推論モデルの最先端を表しています。
Kimi K2の特徴:
- アーキテクチャ:Mixture-of-Experts (MoE)、合計1Tパラメータ
- 有効パラメータ:推論ごとにわずか32Bパラメータが有効
- コンテキストウィンドウ:256Kトークン
- 量子化:効率的なネイティブINT4
- ディスクサイズ:約594GB(フル精度の1TB+と比較して)
import mlx.core as mx
from mlx_lm import load, generate

# 分布式環境の初期化
world = mx.distributed.init()

# モデルのロード(ノード間で自動的に分散)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# テキスト生成
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
パフォーマンス結果 (4x Mac Studio M3 Ultra):
- 合計メモリ:2TB ユニファイド
- 消費電力:500W未満(GPUクラスタの5,000W+と比較して)
- トークン生成:クラウド推論と競争力あり
- コスト効率:NVIDIA RTX 5090クラスタよりも10倍低い電力
パフォーマンスの最適化
ネットワークトポロジーのベストプラクティス
リングトポロジー(4ノード以上に推奨):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
スタートポロジー(シンプルな2〜3ノード):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3ケーブルと接続のガイドライン
| 要素 | 推奨 | 影響 |
|---|---|---|
| ケーブル長 | 2メートル未満 | 完全な80 Gbpsを維持 |
| ケーブル品質 | 認定済み TB5/USB4 v2 | データエラーを防止 |
| ハブの回避 | 直接接続 | ハブは速度を10 Gbpsに低下させる |
| ポート選択 | 利用可能なすべてを使用 | 帯域幅を最大化 |
メモリと計算のバランス調整
異種クラスタ(混合ハードウェア)を構築する場合:
# MLXはデバイスの機能に基づいて自動的にバランスを取ります
# しかし、パーティショニングをカスタマイズすることもできます:

import mlx.core as mx

# 分布式ワールド情報の取得
world = mx.distributed.init()

# カスタム重みの割り当て
weights = {
    0: 2.0,  # Mac Studioは2倍のシェアを取得
    1: 1.0,  # Mac miniは1倍のシェアを取得
    2: 1.0,
    3: 1.0
}
一般的な問題のトラブルシューティング
接続の問題
問題:ノードがお互いを検出しない
# Thunderbolt接続ステータスの確認
system_profiler SPThunderboltDataType

# ネットワークインターフェースの確認
networksetup -listallhardwareports

# 直接接続のテスト
ping mac2.local
問題:転送速度が遅い
# Thunderbolt帯域幅のテスト
iperf3 -c mac2.local -p 5201

# 期待値:TB5で約9-10 GB/s
# 低い場合:ケーブルの長さ/品質を確認
MLX エラー
問題:「利用可能な分散バックエンドがありません」
# MLXが正しくインストールされていることを確認
pip install --upgrade mlx

# Pythonバージョンの確認(3.12+が必要)
python --version
問題:分散推論での「メモリ不足」
# メモリ効率モードの有効化
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # 利用可能なメモリの95%を使用

# またはバッチサイズの削減
generate(model, tokenizer, prompt=prompt, max_tokens=100)
SSH 構成
全ノード間でパスワードなしSSHを確認してください:
# 必要に応じてSSHキーを生成
ssh-keygen -t ed25519

# 全ノードにコピー
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# テスト
ssh mac2.local "hostname"
電力効率とコスト分析
消費電力の比較
| 構成 | 消費電力 | パフォーマンス | $/パフォーマンス |
|---|---|---|---|
| 4x Mac Studio (512GB) | ~500W | 1兆パラメータ対応 | 最良 |
| NVIDIA H100 クラスタ (4x) | ~2,800W | 同様の能力 | 5.6倍の電力 |
| NVIDIA RTX 5090 クラスタ | ~2,300W | VRAM制限 | 4.6倍の電力 |
総所有コスト
Mac Studio クラスタ (2TB 構成):
- ハードウェア:47,000ドル
- 年間電力 (24/7):約500ドル
- メンテナンス:最小限
- 5年間のTCO:約49,500ドル
同等のGPUクラスタ:
- ハードウェア:100,000ドル以上
- 年間電力 (24/7):約3,000ドル
- 冷却インフラ:10,000ドル以上
- メンテナンス:多大
- 5年間のTCO:約130,000ドル以上
ユースケースとアプリケーション
機械学習研究
Thunderbolt 5 クラスタリングは、学術および企業のML研究において優れています:
研究アプリケーション:
- モデルトレーニング:勾配同期を伴う複数のMac間での分散トレーニング
- ファインチューニング:独自のデータセットでの大規模モデルのローカルファインチューニング
- 推論:実験用にローカルで1兆パラメータモデルを実行
- アブレーション研究:クラウドGPUの空き状況を待たずに迅速なプロトタイピング
研究ワークフロー例:
import mlx.core as mx
from mlx_lm import load, generate

# ファインチューニング済みモデルのロード
model, tokenizer = load("./my-finetuned-model")

# 分布式クラスタ全体で実験を実行
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
大学および研究ラボ のメリット:
- 予測不可能なクラウド請求と比較して固定されたハードウェアコスト
- 機密性の高い研究のための完全なデータプライバシー
- 分散コンピューティングコースのための教育リソース
- 再現可能で出版可能な実験
プロフェッショナルクリエイティブワークフロー
Appleのクリエイティブエコシステムとの統合は、独自の利点を提供します:
ビデオ制作:
- 分散レンダリング:Final Cut Pro、DaVinci Resolve、Motion プロジェクト
- AI支援編集:シーン検出、文字起こし用のローカルAIモデル
- カラーグレーディング:ノード間でのGPUアクセラレーションによるカラー処理
- 8K RAW 処理:大容量ビデオファイルに十分なメモリ
オーディオ制作:
- Logic Pro 分散処理:ノード間でのプラグインレンダリング
- AI音楽生成:ローカル音楽AIモデルの実行
- オーディオ修復:ローカルでのMLベースのノイズリダクション
3D およびモーショングラフィックス:
- Blender 分散レンダリング:Macクラスタ全体でのCyclesレンダリング
- Cinema 4D:クラスタサポート付きのCPUレンダリング
- Houdini:シミュレーションの分散(適切なプラグインを使用)
クリエイティブワークフローの詳細については、macOS Tahoe プロフェッショナルワークフロー革命ガイド をご覧ください。
開発とテスト
現代のAIアプリケーション開発は、ローカルクラスタから大きな恩恵を受けます:
AI搭載アプリケーション開発:
# 例:ローカル推論を使用したAIチャットボットの構築
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
開発者のメリット:
- ローカルLLM開発:APIレート制限なしでテストと反復
- CI/CD 加速:分散ビルドおよびテストシステム
- AIアプリケーション開発:ローカルAIバックエンドを使用したアプリの構築
- コスト不要の実験:開発中のリクエストごとの課金なし
テストの利点:
- ローカルで本番規模のモデルに対してテスト
- テスト環境でのネットワーク遅延なし
- 一貫性のある再現可能なテスト結果
- モデルバージョンの完全な制御
開発環境の構成については、macOS Tahoe 開発者セットアップガイド を確認してください。
エンタープライズ展開シナリオ
大企業は、以下の目的でMacクラスタを展開しています:
社内AIアシスタント:
- プライベートなChatGPTスタイルのインターフェース
- ドキュメント分析と要約
- コードレビューと生成
- 会議の文字起こしと分析
コンプライアンスに敏感な業界:
- ヘルスケア:HIPAA準拠のAI処理
- 金融:オンプレミスモデル推論
- 法律:機密文書の分析
- 政府:エアギャップ環境でのAI機能
企業向け費用対効果分析:
| シナリオ | クラウドコスト/年 | Macクラスタコスト/年 | 削減 |
|---|---|---|---|
| ライト (1M トークン/日) | ~$11,000 | ~$3,000 (償却) | 73% |
| ミディアム (10M トークン/日) | ~$110,000 | ~$15,000 (償却) | 86% |
| ヘビー (100M トークン/日) | ~$1.1M | ~$60,000 (償却) | 95% |
Macクラスタリングの未来
M5 とその先
Apple M5 チップ は、すべてのGPUコアにNeural Acceleratorを導入し、4倍のAIパフォーマンス向上を実現します。Thunderbolt 5クラスタリングと組み合わせると:
- 強化されたMLXサポート:M5 Neural Acceleratorへの完全アクセス
- 改善されたメモリ帯域幅:チップあたり153GB/s
- より良い電力効率:ワットあたりのパフォーマンス向上
Mac Pro への影響
報道によると、Appleは内部的に「Mac Proをほぼ帳消しにした」とのことです。Thunderbolt 5クラスタリングは代替パスを提供します:
- スケーラブルなパフォーマンス:必要に応じてノードを追加
- 低い参入コスト:小さく始めて、後で拡張
- 柔軟性:異なるMacモデルを組み合わせる
- 将来性:時間の経過とともに個々のノードをアップグレード
セキュリティとプライバシーの考慮事項
なぜローカル処理が重要なのか
クラウドベースのAIに対するMacクラスタリングの最も重要な利点の1つは、完全なデータプライバシーです。プロンプト、トレーニングデータ、生成された出力がローカルネットワークから出ることはありません。
プライバシーの利点:
- データ送信なし:すべての処理はオンプレミスで行われます
- コンプライアンスに優しい:HIPAA、GDPR、SOC2への準拠が容易
- IP保護:独自のデータは非公開のまま
- ログの懸念なし:使用ログの完全な制御
Macクラスタのセキュリティベストプラクティス:
- ネットワーク分離:クラスタを専用VLANに維持
- ファイアウォール構成:クラスタポートへの外部アクセスをブロック
- SSHキー管理:ed25519キーを使用し、定期的にローテーション
- macOSセキュリティ:FileVaultを有効にし、システムを最新の状態に維持
- 物理的セキュリティ:サーバールームへのアクセスを保護
包括的なmacOSセキュリティ構成については、macOS Tahoe セキュリティ&プライバシーガイド を参照してください。
実際のパフォーマンスベンチマーク
推論速度の比較
コミュニティのテストとAppleのデモンストレーションに基づく:
| モデル | 構成 | トークン/秒 | 比較 |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64GB) | ~35 tok/s | RTX 4090 に匹敵 |
| Llama 3.1 405B | 4x Mac Studio (512GB) | ~15 tok/s | クラウド A100 を超える |
| Kimi K2 | 2x Mac Studio (512GB) | ~20 tok/s | 初のローカル1兆パラメータ |
| DeepSeek V3 | 4x Mac Studio (512GB) | ~12 tok/s | 以前はクラウドのみ |
レイテンシ分析
| 指標 | Mac クラスタ | クラウド API | 差異 |
|---|---|---|---|
| 最初のトークン | 100-500ms | 500-2000ms | 2〜10倍高速 |
| 一貫したレイテンシ | はい | 可変 | より予測可能 |
| コールドスタート | なし | 5-30秒 | 待ち時間なし |
| 可用性 | 100% (ローカル) | 99.9% | 停止なし |
トークンあたりのコスト比較
1年間24/7運用を想定:
| ソリューション | ハードウェアコスト | 運用コスト | 1年合計 | 1Mトークンあたりのコスト |
|---|---|---|---|---|
| 4x Mac Studio クラスタ | $47,000 | ~$500 | $47,500 | ~$0.02 |
| OpenAI GPT-4 | $0 | 使用量ベース | 可変 | ~$30.00 |
| Claude API | $0 | 使用量ベース | 可変 | ~$15.00 |
| AWS Bedrock | $0 | 使用量ベース | 可変 | ~$10.00 |
ヘビーユーザー(年間1億トークン以上)の場合、ローカルMacクラスタリングは経済的に非常に有利になります。
よくある質問 (FAQ)
クラスタには何台のMacを接続できますか?
実用的な制限はトポロジーによって異なります。直接Thunderbolt接続(ハブを回避)を使用すると、4〜6台のMacを効率的に接続できます。リングトポロジーを使用すると、全帯域幅を維持しながらより多くのノードに拡張できます。6ノードを超えると、帯域幅のボトルネックを回避するために慎重なトポロジー計画が必要になります。
クラスタリングには同一のMacが必要ですか?
いいえ、MLXとEXOは異種クラスタをサポートしています。ただし、クラスタは最も遅いコンポーネントによって制限されます。最良の結果を得るには、類似した世代のMacを使用し、Thunderboltのバージョンを一致させてください。メモリ分散は、各ノードの利用可能なRAMによって重み付けされます。
クラスタでThunderbolt 4 Macを使用できますか?
はい、ただしそれらの接続の帯域幅は40 Gbpsに制限されます。Thunderbolt 5と4は下位互換性があります。世代を混在させると、システムは低い速度で動作します。最高のパフォーマンスを得るには、TB4ノードをリングの途中ではなくリーフノードとして維持してください。
クラスタリングに必要な最小メモリは?
合計クラスタメモリは、操作の余裕を持たせてモデルのメモリ要件を超える必要があります。Llama 3.1 70B(140GBモデル)の場合、少なくとも3台のMac(各48GB、合計144GB)が必要です。モデルサイズより10〜20%の余裕を持たせることをお勧めします。
Macクラスタリングはトレーニングに適していますか、それとも推論のみですか?
両方です!MLXは、ノード間での勾配平均化を伴う分散トレーニングをサポートしています。ただし、大規模モデルのメモリプーリングの利点から、推論が主要なユースケースです。トレーニングにはより多くのノード間通信が必要であり、ネットワーク遅延に対してより敏感です。
クラウドGPUインスタンスと比較してどうですか?
長期使用(6ヶ月以上の定期使用)の場合、Macクラスタリングの方がコスト効率が高くなります。ハードウェアを所有し、時間単位の料金がなく、競争力のあるパフォーマンスを実現できます。たまに使用する場合や実験の場合は、最初はクラウドインスタンスの方が経済的かもしれません。
クラスタを24/7実行できますか?
もちろんです。Macハードウェアは連続動作用に設計されています。特にMac Studioは、持続的なワークロードに対して優れた熱管理機能を備えています。Activity Monitorまたは sudo powermetrics を使用して温度を監視し、十分な換気を確保してください。
1つのノードが故障した場合はどうなりますか?
現在、MLXクラスタリングはホットスワップや自動フェイルオーバーをサポートしていません。ノードが切断されると、ジョブは失敗し、再起動する必要があります。重要なワークロードについては、最後に保存された状態から再開できるようにコードにチェックポイントを実装してください。
AIワークロードの実行中にクラスタを使用できますか?
はい、ただしパフォーマンスに影響する可能性があります。EXOインターフェースを使用すると、Macを他のタスクに使用しながらバックグラウンド操作が可能です。最高の推論パフォーマンスを得るには、重いAIワークロード中は他のアクティビティを最小限に抑えてください。
結論
macOS Tahoe 26.2のThunderbolt 5クラスタリングは、ローカルAIコンピューティングにおけるパラダイムシフトを表しています。複数のMacを統合スーパーコンピュータに組み合わせることで、ユーザーは従来のGPUクラスタコストの数分の一で1兆パラメータモデルを実行できます。
主なメリット:
- GPUの代替品よりも10倍低い消費電力
- 特別なハードウェア不要
- MLXとEXOによる簡単なセットアップ
- 2ノードから6ノード以上に拡張可能
- ローカルでプライベートなAI処理
Appleエコシステムに投資しているユーザーにとって、この機能だけでもmacOS Tahoe 26.2へのアップグレードを正当化する可能性があります。完全な更新手順については、macOS Tahoe 26.2 更新ガイド を確認してください。
AIワークロード用にMacを最適化する準備はできましたか? 大規模モデル用の十分なスペースを確保するために、macOS Tahoe ストレージ管理ガイド から始めてください。
情報源
- macOS TahoeのMLがGPU、Thunderbolt 5クラスタリングでブースト - Apple Insider, 2025年11月
- macOS Tahoe 26.2でMacのクラスタをAIスーパーコンピュータに変えることができます - Engadget, 2025年11月
- Mac Studioのクラスタは、もはやMac Proを必要としない理由の1つにすぎません - 9to5Mac, 2025年11月
- AIクラスタ:2TBの4台のMacで巨大モデルKimi K2 Thinkingを実行可能 - Heise Online, 2025年11月
- MLX 分散通信ドキュメント - Apple MLX 公式ドキュメント
- EXO:自宅で独自のAIクラスタを実行 - EXO Labs GitHub
- MLXでAppleシリコン上の大規模言語モデルを探索 - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Moonshot AI 公式