Guide du clustering Thunderbolt 5 sous macOS Tahoe 26.2 : Construisez votre propre supercalculateur IA
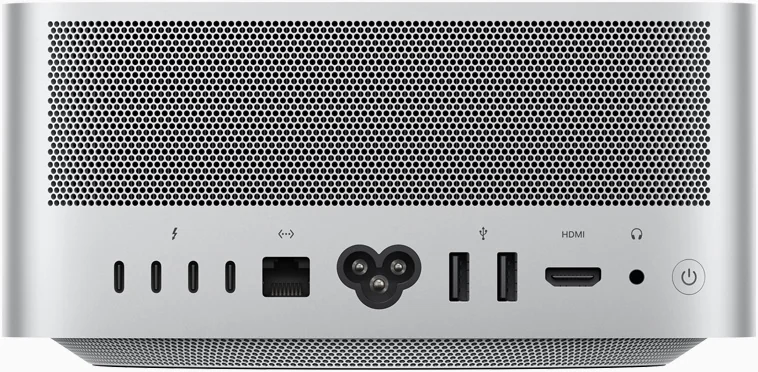
Guide complet pour construire des clusters Mac avec Thunderbolt 5 sous macOS Tahoe 26.2. Apprenez la configuration du framework MLX, d'EXO, les exigences matérielles et exécutez localement des modèles IA de plusieurs milliers de milliards de paramètres.
macOS Tahoe 26.2 introduit une fonctionnalité révolutionnaire qui transforme plusieurs Mac en un supercalculateur IA unifié grâce au clustering Thunderbolt 5. Ce guide complet couvre tout, des exigences matérielles à l'exécution de modèles de milliers de milliards de paramètres comme Kimi K2 Thinking sur votre propre cluster Mac.
Points clés
- Le clustering Thunderbolt 5 dans macOS Tahoe 26.2 permet de connecter plusieurs Mac à une vitesse bidirectionnelle allant jusqu'à 80 Gbps
- Quatre Mac Studio avec 512 Go chacun peuvent exécuter le modèle Kimi K2 Thinking d'un billion de paramètres en utilisant moins de 500 W de puissance totale
- Les appareils compatibles incluent le Mac mini M4 Pro, le MacBook Pro M4 Pro/Max et le Mac Studio M3 Ultra
- Le framework MLX et le logiciel EXO 1.0 fournissent l'infrastructure de calcul distribué
- Aucun matériel spécial requis - juste des câbles Thunderbolt 5 standard de moins de 2 mètres
Résumé : Comprendre la technologie de clustering Mac
Pourquoi le clustering Thunderbolt 5 est important
La sortie de macOS Tahoe 26.2 marque un moment charnière dans la stratégie informatique professionnelle d'Apple. Pour la première fois, Apple fournit une prise en charge native et optimisée pour connecter plusieurs Mac en un cluster informatique unifié utilisant la bande passante sans précédent de Thunderbolt 5. Ce n'est pas juste une amélioration progressive — cela change fondamentalement ce qui est possible avec le matériel Mac.
Le problème qu'il résout :
L'exécution de grands modèles d'IA nécessitait traditionnellement des clusters GPU coûteux avec une consommation d'énergie massive. Une configuration typique pour des modèles de milliers de milliards de paramètres pourrait inclure :
- Cluster NVIDIA H100 : Matériel à plus de 400 000 $, consommation de plus de 10 kW
- Instances GPU Cloud : 2 à 5 $ par heure pour des instances performantes
- Infrastructure de centre de données personnalisée : Refroidissement, distribution d'énergie, réseau
La solution du cluster Mac :
Avec le clustering Thunderbolt 5, vous pouvez obtenir des capacités comparables avec :
- 4x Mac Studio : Matériel à 47 000 $ (réduction de coût de 88 % par rapport au H100)
- Consommation électrique : Moins de 500 W (réduction de 95 %)
- Aucune infrastructure : Environnement de bureau standard
- Traitement local : Confidentialité totale des données
Qui bénéficie du clustering Mac ?
Chercheurs en IA et ingénieurs ML :
- Exécutez des modèles de pointe localement sans dépendances cloud
- Itérez plus rapidement avec du matériel dédié
- Gardez un contrôle total sur les données d'entraînement
Professionnels de la création :
- Rendu vidéo distribué sur plusieurs Mac
- Édition assistée par IA avec des modèles locaux
- Traitement de fichiers volumineux sans latence réseau
Équipes informatiques d'entreprise :
- Déploiements d'IA privés
- Infrastructure à coût prévisible
- Maintenance simplifiée par rapport aux clusters GPU
Développeurs indépendants :
- Créez des applications d'IA avec inférence locale
- Testez contre de grands modèles pendant le développement
- Livrez des produits sans coûts d'API continus
Qu'est-ce que le clustering Mac Thunderbolt 5 ?
L'évolution du calcul distribué sur Mac
Le clustering Mac Thunderbolt 5 représente la renaissance moderne du calcul distribué sur Mac par Apple. Les utilisateurs Apple de longue date se souviendront peut-être de Xgrid, qui transformait des collections de Mac en supercalculateurs. Le nouveau clustering Thunderbolt 5 dans macOS Tahoe 26.2 suit un concept similaire mais fonctionne à des vitesses considérablement plus élevées.
Contexte historique :
- Ère Xgrid : Limitée aux vitesses Ethernet (1-10 Gbps)
- Clusters Thunderbolt 4 : 40 Gbps, l'utilisation de hubs réduisait les vitesses à 10 Gbps
- Clusters Thunderbolt 5 : Pleine vitesse 80 Gbps bidirectionnelle, mode rafale 120 Gbps
Comment fonctionne le clustering Thunderbolt 5
La technologie de clustering utilise l'accès direct à la mémoire à distance (RDMA), permettant à un Mac d'accéder directement à la mémoire d'un autre sans surcharge du processeur. Lorsque vous connectez plusieurs Mac via Thunderbolt 5 :
- Mise en commun de la mémoire : La mémoire unifiée de chaque Mac devient accessible à l'ensemble du cluster
- Partitionnement du modèle : Les grands modèles d'IA sont répartis proportionnellement sur les machines
- Traitement parallèle : Les charges de travail sont distribuées en fonction des ressources disponibles
- Communication à faible latence : L'accès direct à la mémoire élimine les goulots d'étranglement du réseau
Exemple de configuration de pool de mémoire :
| Configuration | Mémoire totale | Cas d'utilisation |
|---|---|---|
| 2x Mac Studio (512 Go) | 1 To partagé | Kimi K2 Thinking (594 Go) |
| 4x Mac Studio (512 Go) | 2 To partagé | Plusieurs modèles de milliers de milliards de paramètres |
| 4x Mac mini M4 Pro (64 Go) | 256 Go partagé | Modèles de 70B-200B paramètres |
Avantage de la mémoire unifiée Apple Silicon
Une raison clé pour laquelle le clustering Mac est si efficace réside dans l'architecture de mémoire unifiée d'Apple Silicon. Contrairement aux ordinateurs traditionnels où le GPU et le CPU ont des pools de mémoire séparés, Apple Silicon partage la mémoire entre toutes les unités de traitement.
Avantages de la mémoire unifiée pour le clustering :
| Aspect | Architecture traditionnelle | Apple Silicon |
|---|---|---|
| Accès mémoire | Le GPU copie les données de la RAM | Accès partagé direct |
| Bande passante | Limitée par PCIe (64 Go/s) | Jusqu'à 800 Go/s (M3 Ultra) |
| Efficacité | Duplication des données requise | Opérations zéro copie |
| Évolutivité | La VRAM limite la taille du modèle | Le pool unifié s'adapte linéairement |
Lorsque vous clusterisez plusieurs Mac, vous créez efficacement un plus grand pool de mémoire unifiée. Un modèle trop grand pour la mémoire d'un seul Mac peut être réparti sur plusieurs nœuds, chaque Mac en détenant une partie et partageant l'accès via Thunderbolt 5.
Exemple pratique :
- Un seul Mac Studio (512 Go) : Peut exécuter des modèles jusqu'à ~450 Go (en laissant de la marge)
- 2x Mac Studio (1 To mis en commun) : Peut exécuter des modèles jusqu'à ~900 Go
- 4x Mac Studio (2 To mis en commun) : Peut exécuter des modèles jusqu'à ~1,8 To
Cette mise à l'échelle linéaire est ce qui rend les modèles de milliers de milliards de paramètres comme Kimi K2 Thinking réalisables sur du matériel Mac.
Exigences matérielles et compatibilité
Modèles Mac compatibles
Support natif Thunderbolt 5 (Pleine vitesse 80 Gbps) :
| Appareil | Ports Thunderbolt 5 | Mémoire max | Notes |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 Go | Idéal pour les grands clusters |
| Mac mini (M4 Pro) | 3 avant | 64 Go | Nœuds économiques |
| MacBook Pro 14" (M4 Pro) | 3 | 48 Go | Clustering portable |
| MacBook Pro 16" (M4 Max) | 3 | 128 Go | Portable à haute mémoire |
Spécifications importantes :
- Vitesse Thunderbolt 5 : 80 Gbps bidirectionnel (120 Gbps en mode rafale pour la vidéo)
- Bande passante mémoire : M4 Pro offre 273 Go/s, M4 Max offre 546 Go/s
- Longueur du câble : Gardez moins de 2 mètres pour des performances optimales
- Type de câble : Câbles Thunderbolt 5 standard (compatibles USB4 v2)
Configurations de cluster recommandées
Cluster économique (Expérimentation en Machine Learning) :
4x Mac mini M4 Pro (24 Go chacun)
Mémoire totale : 96 Go partagé
Coût : ~7 200 $
Idéal pour : Modèles jusqu'à 70B paramètres
Consommation : ~60 W inactif, ~200 W pic
Niveau sonore : Presque silencieux
Cette configuration est parfaite pour les développeurs apprenant le ML distribué, les petites équipes expérimentant des modèles open source, ou l'exécution de modèles plus petits comme Llama 3.1 8B et Mistral 7B avec d'excellentes performances.
Cluster professionnel (Charges de travail IA en production) :
4x Mac mini M4 Pro (64 Go chacun)
Mémoire totale : 256 Go partagé
Coût : ~13 200 $
Idéal pour : Modèles jusqu'à 200B paramètres
Consommation : ~80 W inactif, ~300 W pic
Niveau sonore : Presque silencieux
Le niveau professionnel débloque des modèles moyens-grands comme Llama 3.1 70B et peut exécuter des inférences sur des modèles de qualité entreprise. C'est le point idéal pour la plupart des entreprises déployant une IA locale.
Cluster d'entreprise (Modèles de milliers de milliards de paramètres) :
4x Mac Studio M3 Ultra (512 Go chacun)
Mémoire totale : 2 To partagé
Coût : ~47 000 $ (47 000 €)
Idéal pour : Kimi K2 Thinking, DeepSeek V3, modèles de pointe
Consommation : ~100 W inactif, ~500 W pic
Niveau sonore : Modéré en charge
Cette configuration haut de gamme égale ou dépasse les clusters GPU de centres de données pour les charges de travail d'inférence tout en consommant une fraction de l'énergie et ne nécessitant aucune infrastructure spécialisée.
Guide de sélection des câbles Thunderbolt 5
Le choix des bons câbles est critique pour les performances du cluster. Tous les câbles ne prennent pas en charge les vitesses complètes de Thunderbolt 5.
Câbles recommandés :
| Câble | Longueur | Vitesse max | Gamme de prix |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1 m | 120 Gbps | 69-79 $ |
| OWC Thunderbolt 5 | 0,8 m | 80 Gbps | 50-60 $ |
| CalDigit TB5 Cable | 1 m | 80 Gbps | 45-55 $ |
| Belkin Connect Pro | 1 m | 80 Gbps | 40-50 $ |
Conseils pour le choix des câbles :
- Restez en dessous d'1 mètre : La pleine vitesse de 80 Gbps nécessite des câbles courts et de haute qualité
- Recherchez la certification USB4 v2 : Assure la compatibilité Thunderbolt 5
- Évitez les adaptateurs : Connexions directes TB5 vers TB5 uniquement
- Achetez auprès de marques réputées : Les câbles contrefaits peuvent ne pas atteindre les vitesses nominales
- Testez les câbles avant déploiement : Utilisez
system_profiler SPThunderboltDataTypepour vérifier la vitesse de liaison
Avertissement : De nombreux câbles vendus en ligne comme "compatibles Thunderbolt 5" n'atteignent que les vitesses Thunderbolt 4. Vérifiez toujours les spécifications avant l'achat.
Pile logicielle : Frameworks MLX et EXO
Comprendre le calcul distribué MLX
MLX est le framework de tableau open source d'Apple conçu spécifiquement pour l'apprentissage automatique sur Apple Silicon. Il fournit une prise en charge native du calcul distribué sur plusieurs Mac.
Fonctionnalités clés de MLX :
- Accès mémoire unifié : Tire parti de l'architecture de mémoire unifiée d'Apple Silicon
- Évaluation paresseuse : Les calculs ne s'exécutent que lorsque les résultats sont nécessaires
- Compilation dynamique : Compilation juste-à-temps pour des performances optimales
- Primitives distribuées : Prise en charge intégrée des opérations multi-machines
Backends de communication MLX
MLX prend en charge trois backends de communication pour différents cas d'utilisation :
| Backend | Vitesse | Idéal pour | Complexité de configuration |
|---|---|---|---|
| Ring | Le plus rapide | Connexions Thunderbolt | Moyen |
| MPI | Rapide | Réseaux Ethernet | Plus élevé |
| NCCL | N/A | Environnements CUDA | N/A sur Mac |
Le backend Ring est recommandé pour les clusters Thunderbolt 5 car il est optimisé pour les connexions point à point directes.
Comprendre l'entraînement distribué vs l'inférence
Avant de plonger dans la configuration, il est important de comprendre les deux principaux cas d'utilisation du clustering Mac :
Inférence distribuée (Exécution de modèles) : C'est le cas d'utilisation principal pour la plupart des utilisateurs. Lorsque vous exécutez une inférence :
- Le modèle est divisé sur plusieurs Mac en fonction de la mémoire disponible
- Chaque Mac détient une partie des poids du modèle
- Pendant la génération, les données circulent entre les nœuds selon les besoins
- Aucun entraînement n'a lieu — vous utilisez un modèle pré-entraîné
Entraînement distribué (Création de modèles) : Pour les chercheurs et les utilisateurs avancés :
- Les données d'entraînement sont réparties sur les nœuds (parallélisme des données)
- Les gradients sont moyennés sur tous les nœuds après chaque lot
- Les poids du modèle sont synchronisés périodiquement
- Nécessite beaucoup plus de communication entre les nœuds
| Cas d'utilisation | Exigence de bande passante | Complexité | Utilisateurs typiques |
|---|---|---|---|
| Inférence | Moyenne (chargement du modèle) | Basse | La plupart des utilisateurs |
| Fine-tuning | Haute (synchro des gradients) | Moyenne | Ingénieurs ML |
| Entraînement complet | Très haute (synchro constante) | Haute | Chercheurs |
Pour la plupart des utilisateurs de clusters Mac, l'inférence est l'objectif principal — exécuter de grands modèles qui ne tiendraient pas sur une seule machine.
EXO : Gestion de cluster simplifiée
EXO (d'Exo Labs) fournit une abstraction de plus haut niveau pour construire des clusters IA. Apple a intégré le protocole d'EXO dans macOS Tahoe 26.2.
Fonctionnalités clés d'EXO :
- Découverte automatique : Détecte automatiquement les autres appareils sur le réseau
- Architecture Peer-to-Peer : Pas de hiérarchie maître-esclave
- Partitionnement intelligent : Divise les modèles de manière optimale en fonction des capacités des appareils
- API compatible ChatGPT : Point de terminaison compatible OpenAI à
localhost:52415
Guide de configuration de cluster étape par étape
Prérequis
Avant de commencer, assurez-vous d'avoir :
- macOS Tahoe 26.2 ou ultérieur installé sur tous les Mac
- Câbles Thunderbolt 5 (moins de 2 mètres)
- Python 3.12+ installé
- SSH sans mot de passe configuré entre les machines
- Même réseau pour toutes les machines (pour la découverte initiale)
Méthode 1 : Configuration native MLX (Recommandé)
Étape 1 : Installer MLX
# Installer MLX via pip
pip install mlx

# Vérifier l'installation
python -c "import mlx.core as mx; print(mx.__version__)"
Étape 2 : Configurer le réseau Thunderbolt
Connectez vos Mac dans une topologie en anneau à l'aide de câbles Thunderbolt 5 :
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1Utilisez l'outil de configuration distribuée MLX :
# Découvrir l'anneau Thunderbolt et générer la configuration
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# Auto-configurer tous les nœuds (nécessite sudo sans mot de passe)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
Étape 3 : Créer la configuration du fichier hôte
Créez un fichier ring-4.json :
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
Étape 4 : Tester la communication distribuée
Créez un script de test test_distributed.py :
import mlx.core as mx

# Initialiser le groupe distribué
world = mx.distributed.init()

# Chaque processus crée un tableau avec son rang
x = mx.ones(10) * world.rank()

# Somme des tableaux sur tous les processus
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
Lancez le test :
mlx.launch --hostfile ring-4.json test_distributed.pySortie attendue (4 nœuds) :
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Méthode 2 : Configuration EXO (Conviviale)
Étape 1 : Cloner et installer EXO
# Cloner le dépôt
git clone https://github.com/exo-explore/exo.git
cd exo

# Installer les dépendances
pip install -e .

# Ou utiliser le script d'installation
source install.sh
Étape 2 : Configurer MLX pour Apple Silicon
# Exécuter le script de configuration MLX
./configure_mlx.sh
Cela optimise l'allocation de la mémoire GPU sur les Mac Apple Silicon.
Étape 3 : Démarrer le cluster
Sur chaque nœud, exécutez la même commande :
exoEXO va :
- Découvrir automatiquement les autres nœuds via la communication peer-to-peer
- Appliquer un partitionnement pondéré de la mémoire en anneau
- Démarrer l'interface web à
http://localhost:52415 - Démarrer le point de terminaison API à
http://localhost:52415/v1/chat/completions
Étape 4 : Accéder à l'interface
Ouvrez votre navigateur sur http://localhost:52415 pour une interface de type ChatGPT afin d'interagir avec votre cluster.
Exécution de grands modèles de langage
Téléchargement des modèles
EXO prend en charge diverses sources de modèles :
# Télécharger depuis Hugging Face
exo download moonshotai/Kimi-K2-Instruct

# Télécharger des modèles Llama
exo download meta-llama/Llama-3.1-70B-Instruct
Exigences mémoire par modèle
| Modèle | Paramètres | Mémoire requise | Cluster recommandé |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 Go | Mac unique |
| Llama 3.1 70B | 70B | 140 Go | 3x Mac mini (64 Go) |
| Llama 3.1 405B | 405B | 810 Go | 4x Mac Studio (512 Go) |
| Kimi K2 | 1T (32B actifs) | 594 Go | 2x Mac Studio (512 Go) |
| Kimi K2 Thinking | 1T (32B actifs) | 594 Go | 2x Mac Studio (512 Go) |
Exécution de Kimi K2 Thinking
Le modèle Kimi K2 Thinking démontre la puissance du clustering Thunderbolt 5. C'est un modèle mélange d'experts (MoE) d'un billion de paramètres avec 32 milliards de paramètres actifs. Développé par Moonshot AI, il représente la pointe des modèles de raisonnement open source.
Ce qui rend Kimi K2 spécial :
- Architecture : Mélange d'experts (MoE) avec 1T de paramètres totaux
- Paramètres actifs : Seulement 32B paramètres actifs par inférence
- Fenêtre contextuelle : 256K tokens
- Quantification : INT4 natif pour l'efficacité
- Taille sur disque : ~594 Go (contre 1 To+ pour la précision complète)
import mlx.core as mx
from mlx_lm import load, generate

# Initialiser l'environnement distribué
world = mx.distributed.init()

# Charger le modèle (automatiquement distribué sur les nœuds)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# Générer du texte
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
Résultats de performance (4x Mac Studio M3 Ultra) :
- Mémoire totale : 2 To unifiés
- Consommation électrique : Moins de 500 W (contre 5 000 W+ pour un cluster GPU)
- Génération de tokens : Compétitive avec l'inférence cloud
- Efficacité coût : Puissance 10 fois inférieure à celle d'un cluster NVIDIA RTX 5090
Optimisation des performances
Meilleures pratiques de topologie réseau
Topologie en anneau (Recommandée pour 4+ nœuds) :
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
Topologie en étoile (Simple 2-3 nœuds) :
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3Directives de câblage et de connexion
| Facteur | Recommandation | Impact |
|---|---|---|
| Longueur du câble | Moins de 2 mètres | Maintient les 80 Gbps complets |
| Qualité du câble | Certifié TB5/USB4 v2 | Empêche les erreurs de données |
| Éviter les hubs | Connexions directes | Les hubs réduisent à 10 Gbps |
| Sélection des ports | Utiliser tous les ports disponibles | Maximise la bande passante |
Équilibrage mémoire et calcul
Lors de la construction d'un cluster hétérogène (matériel mixte) :
# MLX équilibre automatiquement en fonction des capacités de l'appareil
# Mais vous pouvez personnaliser le partitionnement :

import mlx.core as mx

# Obtenir les infos du monde distribué
world = mx.distributed.init()

# Attribution de poids personnalisée
weights = {
    0: 2.0,  # Mac Studio obtient 2x la part
    1: 1.0,  # Mac mini obtient 1x la part
    2: 1.0,
    3: 1.0
}
Dépannage des problèmes courants
Problèmes de connexion
Problème : Les nœuds ne se découvrent pas
# Vérifier l'état de la connexion Thunderbolt
system_profiler SPThunderboltDataType

# Vérifier les interfaces réseau
networksetup -listallhardwareports

# Tester la connectivité directe
ping mac2.local
Problème : Vitesses de transfert lentes
# Tester la bande passante Thunderbolt
iperf3 -c mac2.local -p 5201

# Attendu : ~9-10 Go/s pour TB5
# Si inférieur : vérifier la longueur/qualité du câble
Erreurs MLX
Problème : "Aucun backend distribué disponible"
# Assurez-vous que MLX est correctement installé
pip install --upgrade mlx

# Vérifier la version Python (nécessite 3.12+)
python --version
Problème : "Mémoire insuffisante" lors de l'inférence distribuée
# Activer le mode économe en mémoire
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # Utiliser 95% de la mémoire disponible

# Ou réduire la taille du lot
generate(model, tokenizer, prompt=prompt, max_tokens=100)
Configuration SSH
Assurez un SSH sans mot de passe entre tous les nœuds :
# Générer une clé SSH si nécessaire
ssh-keygen -t ed25519

# Copier sur tous les nœuds
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# Tester
ssh mac2.local "hostname"
Efficacité énergétique et analyse des coûts
Comparaison de la consommation électrique
| Configuration | Consommation | Performance | $/Performance |
|---|---|---|---|
| 4x Mac Studio (512 Go) | ~500 W | Capable de 1T paramètres | Meilleur |
| Cluster NVIDIA H100 (4x) | ~2 800 W | Capacité similaire | 5,6x plus d'énergie |
| Cluster NVIDIA RTX 5090 | ~2 300 W | VRAM limitée | 4,6x plus d'énergie |
Coût total de possession (TCO)
Cluster Mac Studio (Configuration 2 To) :
- Matériel : 47 000 $
- Électricité annuelle (24/7) : ~500 $
- Maintenance : Minimale
- TCO sur 5 ans : ~49 500 $
Cluster GPU équivalent :
- Matériel : 100 000 $+
- Électricité annuelle (24/7) : ~3 000 $
- Infrastructure de refroidissement : 10 000 $+
- Maintenance : Significative
- TCO sur 5 ans : ~130 000 $+
Cas d'utilisation et applications
Recherche en apprentissage automatique
Le clustering Thunderbolt 5 excelle pour la recherche ML universitaire et d'entreprise :
Applications de recherche :
- Entraînement de modèles : Entraînement distribué sur plusieurs Mac avec synchronisation de gradients
- Fine-Tuning : Ajustement local de grands modèles sur des ensembles de données propriétaires
- Inférence : Exécution locale de modèles de milliers de milliards de paramètres pour l'expérimentation
- Études d'ablation : Prototypage rapide sans attendre la disponibilité des GPU cloud
Exemple de flux de travail de recherche :
import mlx.core as mx
from mlx_lm import load, generate

# Charger votre modèle affiné
model, tokenizer = load("./my-finetuned-model")

# Exécuter des expériences sur le cluster distribué
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
Les universités et les laboratoires de recherche bénéficient de :
- Coûts matériels fixes par rapport à la facturation cloud imprévisible
- Confidentialité totale des données pour les recherches sensibles
- Ressources pédagogiques pour les cours de calcul distribué
- Expériences reproductibles prêtes pour la publication
Flux de travail créatifs professionnels
L'intégration avec l'écosystème créatif d'Apple offre des avantages uniques :
Production vidéo :
- Rendu distribué : Projets Final Cut Pro, DaVinci Resolve, Motion
- Édition assistée par IA : Modèles IA locaux pour la détection de scènes, la transcription
- Étalonnage des couleurs : Traitement des couleurs accéléré par GPU sur les nœuds
- Traitement RAW 8K : Mémoire suffisante pour les fichiers vidéo volumineux
Production audio :
- Traitement distribué Logic Pro : Rendu de plugins sur les nœuds
- Génération de musique IA : Exécuter des modèles IA musicaux locaux
- Restauration audio : Réduction de bruit basée sur ML localement
3D et Motion Design :
- Rendu distribué Blender : Rendu Cycles sur cluster Mac
- Cinema 4D : Rendu CPU avec prise en charge du cluster
- Houdini : Distribution de simulation (avec les plugins appropriés)
Pour en savoir plus sur les flux de travail créatifs, consultez notre Guide de la révolution des flux de travail professionnels macOS Tahoe.
Développement et tests
Le développement d'applications IA modernes bénéficie considérablement des clusters locaux :
Développement d'applications basées sur l'IA :
# Exemple : Construction d'un chatbot IA avec inférence locale
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
Avantages pour les développeurs :
- Développement LLM local : Testez et itérez sans limites de taux d'API
- Accélération CI/CD : Systèmes de construction et de test distribués
- Développement d'applications IA : Créez des applications avec des backends IA locaux
- Expérimentation sans frais : Pas de frais par requête pendant le développement
Avantages des tests :
- Testez contre des modèles à l'échelle de la production localement
- Pas de latence réseau dans les environnements de test
- Résultats de test cohérents et reproductibles
- Contrôle total sur les versions des modèles
Consultez notre Guide de configuration développeur macOS Tahoe pour la configuration de l'environnement de développement.
Scénarios de déploiement en entreprise
Les grandes organisations déploient des clusters Mac pour :
Assistants IA internes :
- Interfaces privées de type ChatGPT
- Analyse et résumé de documents
- Revue et génération de code
- Transcription et analyse de réunions
Industries sensibles à la conformité :
- Santé : Traitement IA conforme HIPAA
- Finance : Inférence de modèles sur site
- Juridique : Analyse de documents confidentiels
- Gouvernement : Capacités IA isolées (air-gapped)
Analyse coûts-avantages pour l'entreprise :
| Scénario | Coût Cloud/An | Coût Cluster Mac/An | Économies |
|---|---|---|---|
| Léger (1M tokens/jour) | ~11 000 $ | ~3 000 $ (amorti) | 73 % |
| Moyen (10M tokens/jour) | ~110 000 $ | ~15 000 $ (amorti) | 86 % |
| Lourd (100M tokens/jour) | ~1,1M $ | ~60 000 $ (amorti) | 95 % |
Avenir du clustering Mac
M5 et au-delà
La puce Apple M5 introduit des accélérateurs neuronaux dans chaque cœur GPU, offrant une amélioration des performances IA de 4x. Lorsqu'elle est combinée avec le clustering Thunderbolt 5 :
- Prise en charge MLX améliorée : Accès complet aux accélérateurs neuronaux M5
- Bande passante mémoire améliorée : 153 Go/s par puce
- Meilleure efficacité énergétique : Plus de performances par watt
Implications pour le Mac Pro
Selon les rapports, Apple a "largement fait une croix sur le Mac Pro" en interne. Le clustering Thunderbolt 5 offre une voie alternative :
- Performance évolutive : Ajoutez des nœuds selon les besoins
- Coût d'entrée inférieur : Commencez petit, développez plus tard
- Flexibilité : Mélangez différents modèles de Mac
- Pérennité : Mettez à niveau les nœuds individuels au fil du temps
Considérations de sécurité et de confidentialité
Pourquoi le traitement local est important
L'un des avantages les plus significatifs du clustering Mac par rapport à l'IA basée sur le cloud est la confidentialité totale des données. Vos invites, données d'entraînement et sorties générées ne quittent jamais votre réseau local.
Avantages de confidentialité :
- Aucune transmission de données : Tout le traitement se fait sur site
- Conformité facile : Conformité HIPAA, GDPR, SOC2 plus facile
- Protection IP : Les données propriétaires restent privées
- Pas de soucis de journalisation : Contrôle total sur les journaux d'utilisation
Meilleures pratiques de sécurité pour les clusters Mac :
- Isolation réseau : Gardez votre cluster sur un VLAN dédié
- Configuration du pare-feu : Bloquez l'accès externe aux ports du cluster
- Gestion des clés SSH : Utilisez des clés ed25519, effectuez une rotation régulière
- Sécurité macOS : Activez FileVault, gardez les systèmes à jour
- Sécurité physique : Sécurisez l'accès à la salle des serveurs
Pour une configuration de sécurité macOS complète, consultez notre Guide de sécurité et confidentialité macOS Tahoe.
Benchmarks de performance réels
Comparaison de la vitesse d'inférence
Basé sur des tests communautaires et des démonstrations d'Apple :
| Modèle | Configuration | Tokens/Seconde | Comparaison |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 Go) | ~35 tok/s | Comparable à RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 Go) | ~15 tok/s | Dépasse le cloud A100 |
| Kimi K2 | 2x Mac Studio (512 Go) | ~20 tok/s | Premier billion de paramètres local |
| DeepSeek V3 | 4x Mac Studio (512 Go) | ~12 tok/s | Auparavant cloud uniquement |
Analyse de latence
| Métrique | Cluster Mac | API Cloud | Différence |
|---|---|---|---|
| Premier Token | 100-500ms | 500-2000ms | 2 à 10x plus rapide |
| Latence cohérente | Oui | Variable | Plus prévisible |
| Démarrage à froid | Aucun | 5-30s | Pas d'attente |
| Disponibilité | 100% (local) | 99,9% | Aucune panne |
Comparaison du coût par token
En supposant un fonctionnement 24/7 sur 1 an :
| Solution | Coût matériel | Coût d'exploitation | Total 1 an | Coût/1M Tokens |
|---|---|---|---|---|
| Cluster 4x Mac Studio | 47 000 $ | ~500 $ | 47 500 $ | ~0,02 $ |
| OpenAI GPT-4 | 0 $ | Basé sur l'utilisation | Variable | ~30,00 $ |
| Claude API | 0 $ | Basé sur l'utilisation | Variable | ~15,00 $ |
| AWS Bedrock | 0 $ | Basé sur l'utilisation | Variable | ~10,00 $ |
Pour les gros utilisateurs (>100M tokens/an), le clustering Mac local devient nettement plus économique.
FAQ
Combien de Mac puis-je connecter dans un cluster ?
La limite pratique dépend de votre topologie. Avec des connexions Thunderbolt directes (en évitant les hubs), vous pouvez connecter efficacement 4 à 6 Mac. L'utilisation d'une topologie en anneau permet de passer à plus de nœuds tout en maintenant une bande passante complète. Au-delà de 6 nœuds, vous aurez besoin d'une planification topologique minutieuse pour éviter les goulots d'étranglement de bande passante.
Ai-je besoin de Mac identiques pour le clustering ?
Non, MLX et EXO prennent en charge les clusters hétérogènes. Cependant, le cluster sera limité par le composant le plus lent. Pour de meilleurs résultats, utilisez des Mac de génération similaire avec des versions Thunderbolt correspondantes. La distribution de la mémoire sera pondérée par la RAM disponible de chaque nœud.
Puis-je utiliser des Mac Thunderbolt 4 dans un cluster ?
Oui, mais la bande passante sera limitée à 40 Gbps sur ces connexions. Thunderbolt 5 et 4 sont rétrocompatibles. Le système fonctionnera à la vitesse inférieure lors du mélange des générations. Pour de meilleures performances, gardez les nœuds TB4 comme nœuds feuilles plutôt qu'au milieu d'un anneau.
Quelle est la mémoire minimale requise pour le clustering ?
La mémoire totale du cluster doit dépasser les besoins en mémoire de votre modèle avec une certaine marge pour les opérations. Pour Llama 3.1 70B (modèle de 140 Go), vous avez besoin d'au moins 3 Mac avec 48 Go chacun (144 Go au total). Nous recommandons une marge de 10 à 20 % au-dessus de la taille du modèle.
Le clustering Mac convient-il à l'entraînement ou uniquement à l'inférence ?
Les deux ! MLX prend en charge l'entraînement distribué avec moyenne des gradients sur les nœuds. Cependant, l'inférence est le cas d'utilisation principal en raison des avantages de la mise en commun de la mémoire pour les grands modèles. L'entraînement nécessite plus de communication entre les nœuds et est plus sensible à la latence du réseau.
Comment cela se compare-t-il aux instances GPU cloud ?
Pour une utilisation à long terme (plus de 6 mois d'utilisation régulière), le clustering Mac est plus rentable. Vous possédez le matériel, n'avez pas de frais horaires et obtenez des performances compétitives. Pour une utilisation occasionnelle ou une expérimentation, les instances cloud peuvent être plus économiques au début.
Puis-je faire fonctionner le cluster 24/7 ?
Absolument. Le matériel Mac est conçu pour un fonctionnement continu. Les Mac Studio en particulier ont une excellente gestion thermique pour les charges de travail soutenues. Surveillez les températures à l'aide du moniteur d'activité ou de sudo powermetrics et assurez une ventilation adéquate.
Que se passe-t-il si un nœud tombe en panne ?
Actuellement, le clustering MLX ne prend pas en charge le remplacement à chaud ou le basculement automatique. Si un nœud se déconnecte, le travail échouera et devra être redémarré. Pour les charges de travail critiques, implémentez des points de contrôle dans votre code pour reprendre à partir du dernier état enregistré.
Puis-je utiliser le cluster tout en exécutant des charges de travail IA ?
Oui, mais les performances peuvent être impactées. L'interface EXO permet un fonctionnement en arrière-plan pendant que vous utilisez les Mac pour d'autres tâches. Pour de meilleures performances d'inférence, minimisez les autres activités pendant les charges de travail IA lourdes.
Conclusion
Le clustering Thunderbolt 5 de macOS Tahoe 26.2 représente un changement de paradigme dans l'informatique IA locale. En combinant plusieurs Mac en un supercalculateur unifié, les utilisateurs peuvent exécuter des modèles de milliers de milliards de paramètres à une fraction du coût des clusters GPU traditionnels.
Avantages clés :
- Consommation d'énergie 10 fois inférieure aux alternatives GPU
- Aucun matériel spécialisé requis
- Configuration simple avec MLX et EXO
- Évolutif de 2 à 6+ nœuds
- Traitement IA local et privé
Pour les utilisateurs investis dans l'écosystème Apple, cette fonctionnalité peut à elle seule justifier la mise à niveau vers macOS Tahoe 26.2. Consultez notre Guide de mise à jour macOS Tahoe 26.2 pour des instructions de mise à jour complètes.
Prêt à optimiser votre Mac pour les charges de travail IA ? Commencez par notre Guide de gestion du stockage macOS Tahoe pour vous assurer d'avoir suffisamment d'espace pour les grands modèles.
Sources
- Le ML dans macOS Tahoe bénéficie d'un boost GPU et clustering Thunderbolt 5 - Apple Insider, novembre 2025
- Vous pouvez transformer un cluster de Mac en un supercalculateur IA dans macOS Tahoe 26.2 - Engadget, novembre 2025
- Un cluster de Mac Studio est juste une raison pour laquelle nous n'avons plus besoin d'un Mac Pro - 9to5Mac, novembre 2025
- Cluster IA : Quatre Mac avec 2 To peuvent exécuter le modèle géant Kimi K2 Thinking - Heise Online, novembre 2025
- Documentation de communication distribuée MLX - Docs officiels Apple MLX
- EXO : Exécutez votre propre cluster IA à la maison - EXO Labs GitHub
- Explorez les grands modèles de langage sur Apple silicon avec MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Officiel Moonshot AI