macOS Tahoe 26.2 Thunderbolt 5 Clustering-Guide: Bauen Sie Ihren eigenen AI-Supercomputer
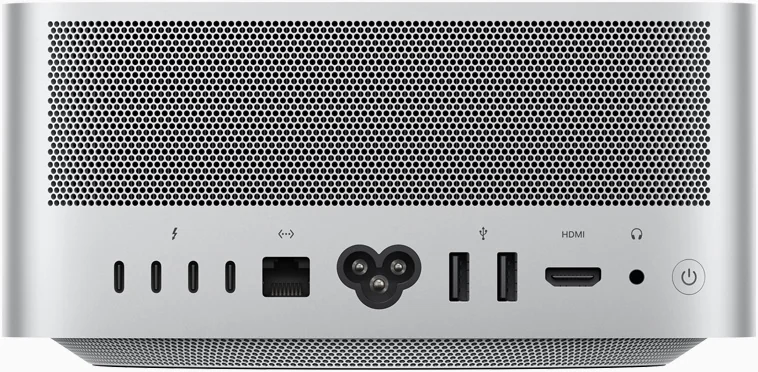
Vollständiger Leitfaden zum Aufbau von Mac-Clustern mit Thunderbolt 5 in macOS Tahoe 26.2. Lernen Sie das MLX-Framework-Setup, EXO-Konfiguration, Hardwareanforderungen und führen Sie Billionen-Parameter-AI-Modelle lokal aus.
macOS Tahoe 26.2 führt eine revolutionäre Funktion ein, die mehrere Macs mithilfe von Thunderbolt 5 Clustering in einen einheitlichen AI-Supercomputer verwandelt. Dieser umfassende Leitfaden deckt alles ab, von den Hardwareanforderungen bis hin zur Ausführung von Billionen-Parameter-Modellen wie Kimi K2 Thinking auf Ihrem eigenen Mac-Cluster.
Wichtige Erkenntnisse
- Thunderbolt 5 Clustering in macOS Tahoe 26.2 ermöglicht die Verbindung mehrerer Macs mit einer bidirektionalen Geschwindigkeit von bis zu 80 Gbit/s
- Vier Mac Studios mit jeweils 512 GB können das 1 Billion Parameter Kimi K2 Thinking Modell bei einem Gesamtstromverbrauch von unter 500 W ausführen
- Kompatible Geräte umfassen M4 Pro Mac mini, M4 Pro/Max MacBook Pro und M3 Ultra Mac Studio
- MLX-Framework und EXO 1.0 Software bieten die Infrastruktur für verteiltes Rechnen
- Keine spezielle Hardware erforderlich - nur Standard-Thunderbolt-5-Kabel unter 2 Metern
Executive Summary: Mac-Clustering-Technologie verstehen
Warum Thunderbolt 5 Clustering wichtig ist
Die Veröffentlichung von macOS Tahoe 26.2 markiert einen entscheidenden Moment in der professionellen Computerstrategie von Apple. Zum ersten Mal bietet Apple native, optimierte Unterstützung für die Verbindung mehrerer Macs zu einem einheitlichen Rechencluster unter Nutzung der beispiellosen Bandbreite von Thunderbolt 5. Dies ist nicht nur eine inkrementelle Verbesserung – es verändert grundlegend, was mit Mac-Hardware möglich ist.
Das Problem, das es löst:
Die Ausführung großer AI-Modelle erforderte traditionell teure GPU-Cluster mit massivem Stromverbrauch. Ein typisches Setup für Billionen-Parameter-Modelle könnte Folgendes umfassen:
- NVIDIA H100 Cluster: 400.000 $+ Hardware, 10 kW+ Stromverbrauch
- Cloud-GPU-Instanzen: 2-5 $ pro Stunde für leistungsfähige Instanzen
- Benutzerdefinierte Rechenzentrumsinfrastruktur: Kühlung, Stromverteilung, Netzwerk
Die Mac-Cluster-Lösung:
Mit Thunderbolt 5 Clustering können Sie vergleichbare Fähigkeiten erreichen mit:
- 4x Mac Studio: 47.000 $ Hardware (88% Kostenreduzierung gegenüber H100)
- Stromverbrauch: Unter 500 W (95% Reduzierung)
- Keine Infrastruktur: Standard-Büroumgebung
- Lokale Verarbeitung: Vollständige Datensicherheit
Wer profitiert von Mac-Clustering?
AI-Forscher und ML-Ingenieure:
- Führen Sie Frontier-Modelle lokal ohne Cloud-Abhängigkeiten aus
- Iterieren Sie schneller mit dedizierter Hardware
- Behalten Sie die vollständige Kontrolle über Trainingsdaten
Kreative Profis:
- Verteiltes Video-Rendering über mehrere Macs
- AI-gestützte Bearbeitung mit lokalen Modellen
- Verarbeitung großer Dateien ohne Netzwerklatenz
Unternehmens-IT-Teams:
- Private AI-Bereitstellungen
- Kosten-vorhersehbare Infrastruktur
- Vereinfachte Wartung im Vergleich zu GPU-Clustern
Unabhängige Entwickler:
- Bauen Sie AI-Anwendungen mit lokaler Inferenz
- Testen Sie während der Entwicklung gegen große Modelle
- Liefern Sie Produkte ohne laufende API-Kosten
Was ist Thunderbolt 5 Mac-Clustering?
Die Entwicklung des verteilten Rechnens auf dem Mac
Thunderbolt 5 Mac-Clustering repräsentiert Apples moderne Wiederbelebung des verteilten Rechnens auf dem Mac. Langjährige Apple-Nutzer erinnern sich vielleicht an Xgrid, das Sammlungen von Macs in Supercomputer verwandelte. Das neue Thunderbolt 5 Clustering in macOS Tahoe 26.2 folgt einem ähnlichen Konzept, arbeitet jedoch mit dramatisch höheren Geschwindigkeiten.
Historischer Kontext:
- Xgrid-Ära: Begrenzt auf Ethernet-Geschwindigkeiten (1-10 Gbit/s)
- Thunderbolt 4 Cluster: 40 Gbit/s, Hub-Nutzung reduzierte Geschwindigkeiten auf 10 Gbit/s
- Thunderbolt 5 Cluster: Volle 80 Gbit/s bidirektional, 120 Gbit/s Burst-Modus
Wie Thunderbolt 5 Clustering funktioniert
Die Clustering-Technologie verwendet Remote Direct Memory Access (RDMA), wodurch ein Mac direkt auf den Arbeitsspeicher eines anderen zugreifen kann, ohne CPU-Overhead. Wenn Sie mehrere Macs über Thunderbolt 5 verbinden:
- Speicher-Pooling: Der Unified Memory jedes Macs wird für den gesamten Cluster zugänglich
- Modell-Partitionierung: Große AI-Modelle werden proportional auf Maschinen aufgeteilt
- Parallele Verarbeitung: Arbeitslasten werden basierend auf verfügbaren Ressourcen verteilt
- Kommunikation mit geringer Latenz: Direkter Speicherzugriff eliminiert Netzwerkengpässe
Beispiel Speicherpool-Konfiguration:
| Konfiguration | Gesamtspeicher | Anwendungsfall |
|---|---|---|
| 2x Mac Studio (512 GB) | 1 TB geteilt | Kimi K2 Thinking (594 GB) |
| 4x Mac Studio (512 GB) | 2 TB geteilt | Mehrere Billionen-Parameter-Modelle |
| 4x Mac mini M4 Pro (64 GB) | 256 GB geteilt | 70B-200B Parameter-Modelle |
Apple Silicon Unified Memory Vorteil
Ein Hauptgrund, warum Mac-Clustering so effektiv ist, liegt in der Unified Memory Architektur von Apple Silicon. Im Gegensatz zu herkömmlichen Computern, bei denen GPU und CPU separate Speicherpools haben, teilt sich Apple Silicon den Speicher zwischen allen Verarbeitungseinheiten.
Unified Memory Vorteile für Clustering:
| Aspekt | Traditionelle Architektur | Apple Silicon |
|---|---|---|
| Speicherzugriff | GPU kopiert Daten vom RAM | Direkter gemeinsamer Zugriff |
| Bandbreite | Begrenzt durch PCIe (64 GB/s) | Bis zu 800 GB/s (M3 Ultra) |
| Effizienz | Datenduplizierung erforderlich | Zero-Copy-Operationen |
| Skalierbarkeit | VRAM begrenzt Modellgröße | Einheitlicher Pool skaliert linear |
Wenn Sie mehrere Macs clustern, erstellen Sie effektiv einen größeren Unified Memory Pool. Ein Modell, das zu groß für den Speicher eines einzelnen Macs ist, kann über Knoten aufgeteilt werden, wobei jeder Mac einen Teil hält und den Zugriff über Thunderbolt 5 teilt.
Praktisches Beispiel:
- Einzelner Mac Studio (512 GB): Kann Modelle bis zu ~450 GB ausführen (mit Spielraum)
- 2x Mac Studio (1 TB gepoolt): Kann Modelle bis zu ~900 GB ausführen
- 4x Mac Studio (2 TB gepoolt): Kann Modelle bis zu ~1,8 TB ausführen
Diese lineare Skalierung macht Billionen-Parameter-Modelle wie Kimi K2 Thinking auf Mac-Hardware machbar.
Hardwareanforderungen und Kompatibilität
Kompatible Mac-Modelle
Native Thunderbolt 5 Unterstützung (Volle 80 Gbit/s):
| Gerät | Thunderbolt 5 Anschlüsse | Max. Speicher | Hinweise |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 GB | Am besten für große Cluster |
| Mac mini (M4 Pro) | 3 vorne | 64 GB | Kostengünstige Knoten |
| MacBook Pro 14" (M4 Pro) | 3 | 48 GB | Tragbares Clustering |
| MacBook Pro 16" (M4 Max) | 3 | 128 GB | Tragbar mit viel Speicher |
Wichtige Spezifikationen:
- Thunderbolt 5 Geschwindigkeit: 80 Gbit/s bidirektional (120 Gbit/s Burst-Modus für Video)
- Speicherbandbreite: M4 Pro liefert 273 GB/s, M4 Max liefert 546 GB/s
- Kabellänge: Unter 2 Metern halten für optimale Leistung
- Kabeltyp: Standard-Thunderbolt-5-Kabel (USB4 v2 kompatibel)
Empfohlene Cluster-Konfigurationen
Budget-Cluster (Machine Learning Experimente):
4x Mac mini M4 Pro (je 24 GB)
Gesamtspeicher: 96 GB geteilt
Kosten: ~7.200 $
Am besten für: Modelle bis zu 70B Parameter
Stromverbrauch: ~60 W Leerlauf, ~200 W Spitze
Geräuschpegel: Nahezu lautlos
Diese Konfiguration ist perfekt für Entwickler, die verteiltes ML lernen, kleine Teams, die mit Open-Source-Modellen experimentieren, oder um kleinere Modelle wie Llama 3.1 8B und Mistral 7B mit hervorragender Leistung auszuführen.
Professioneller Cluster (Produktions-AI-Workloads):
4x Mac mini M4 Pro (je 64 GB)
Gesamtspeicher: 256 GB geteilt
Kosten: ~13.200 $
Am besten für: Modelle bis zu 200B Parameter
Stromverbrauch: ~80 W Leerlauf, ~300 W Spitze
Geräuschpegel: Nahezu lautlos
Die professionelle Stufe schaltet mittelgroße Modelle wie Llama 3.1 70B frei und kann Inferenz auf Enterprise-Grade-Modellen ausführen. Dies ist der Sweetspot für die meisten Unternehmen, die lokale AI einsetzen.
Enterprise-Cluster (Billionen-Parameter-Modelle):
4x Mac Studio M3 Ultra (je 512 GB)
Gesamtspeicher: 2 TB geteilt
Kosten: ~47.000 $ (€47.000)
Am besten für: Kimi K2 Thinking, DeepSeek V3, Frontier-Modelle
Stromverbrauch: ~100 W Leerlauf, ~500 W Spitze
Geräuschpegel: Moderat unter Last
Diese Top-Tier-Konfiguration entspricht oder übertrifft Rechenzentrum-GPU-Cluster für Inferenz-Workloads, verbraucht dabei nur einen Bruchteil der Energie und erfordert keine spezialisierte Infrastruktur.
Thunderbolt 5 Kabelauswahl-Leitfaden
Die Wahl der richtigen Kabel ist entscheidend für die Cluster-Leistung. Nicht alle Kabel unterstützen die vollen Thunderbolt-5-Geschwindigkeiten.
Empfohlene Kabel:
| Kabel | Länge | Max. Geschwindigkeit | Preisbereich |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1m | 120 Gbit/s | 69-79 $ |
| OWC Thunderbolt 5 | 0,8m | 80 Gbit/s | 50-60 $ |
| CalDigit TB5 Cable | 1m | 80 Gbit/s | 45-55 $ |
| Belkin Connect Pro | 1m | 80 Gbit/s | 40-50 $ |
Kabelauswahl-Tipps:
- Bleiben Sie unter 1 Meter: Volle 80 Gbit/s erfordern kurze, hochwertige Kabel
- Achten Sie auf USB4 v2 Zertifizierung: Gewährleistet Thunderbolt 5 Kompatibilität
- Vermeiden Sie Adapter: Nur direkte TB5-zu-TB5-Verbindungen
- Kaufen Sie von seriösen Marken: Nachgemachte Kabel erreichen möglicherweise nicht die angegebenen Geschwindigkeiten
- Kabel vor Einsatz testen: Verwenden Sie
system_profiler SPThunderboltDataTypeum die Verbindungsgeschwindigkeit zu überprüfen
Warnung: Viele online verkaufte "Thunderbolt 5 kompatible" Kabel erreichen nur Thunderbolt 4 Geschwindigkeiten. Überprüfen Sie vor dem Kauf immer die Spezifikationen.
Software-Stack: MLX und EXO Frameworks
MLX Distributed Computing verstehen
MLX ist Apples Open-Source-Array-Framework, das speziell für maschinelles Lernen auf Apple Silicon entwickelt wurde. Es bietet native Unterstützung für verteiltes Rechnen über mehrere Macs.
Wichtige MLX-Funktionen:
- Unified Memory Access: Nutzt die Unified Memory Architektur von Apple Silicon
- Lazy Evaluation: Berechnungen werden nur ausgeführt, wenn Ergebnisse benötigt werden
- Dynamic Compilation: Just-in-Time-Kompilierung für optimale Leistung
- Distributed Primitives: Integrierte Unterstützung für Multi-Maschinen-Operationen
MLX Kommunikations-Backends
MLX unterstützt drei Kommunikations-Backends für verschiedene Anwendungsfälle:
| Backend | Geschwindigkeit | Am besten für | Setup-Komplexität |
|---|---|---|---|
| Ring | Am schnellsten | Thunderbolt-Verbindungen | Mittel |
| MPI | Schnell | Ethernet-Netzwerke | Höher |
| NCCL | N/A | CUDA-Umgebungen | N/A auf Mac |
Das Ring-Backend wird für Thunderbolt 5 Cluster empfohlen, da es für direkte Peer-to-Peer-Verbindungen optimiert ist.
Verständnis von verteiltem Training vs. Inferenz
Bevor Sie mit der Einrichtung beginnen, ist es wichtig, die zwei primären Anwendungsfälle für Mac-Clustering zu verstehen:
Verteilte Inferenz (Ausführen von Modellen): Dies ist der primäre Anwendungsfall für die meisten Benutzer. Wenn Sie Inferenz ausführen:
- Wird das Modell basierend auf dem verfügbaren Speicher auf mehrere Macs aufgeteilt
- Hält jeder Mac einen Teil der Modellgewichte
- Fließen Daten während der Generierung je nach Bedarf zwischen den Knoten
- Findet kein Training statt – Sie verwenden ein vorab trainiertes Modell
Verteiltes Training (Erstellen von Modellen): Für Forscher und fortgeschrittene Benutzer:
- Trainingsdaten werden auf Knoten aufgeteilt (Datenparallelität)
- Gradienten werden nach jedem Batch über alle Knoten gemittelt
- Modellgewichte werden periodisch synchronisiert
- Erfordert deutlich mehr Kommunikation zwischen den Knoten
| Anwendungsfall | Bandbreitenanforderung | Komplexität | Typische Nutzer |
|---|---|---|---|
| Inferenz | Mittel (Modellladen) | Niedrig | Die meisten Nutzer |
| Fine-Tuning | Hoch (Gradientensynchronisation) | Mittel | ML-Ingenieure |
| Vollständiges Training | Sehr hoch (konstante Synchronisation) | Hoch | Forscher |
Für die meisten Mac-Cluster-Benutzer ist Inferenz das Hauptziel – die Ausführung großer Modelle, die nicht auf eine einzelne Maschine passen würden.
EXO: Vereinfachtes Cluster-Management
EXO (von Exo Labs) bietet eine Abstraktion auf höherer Ebene zum Aufbau von AI-Clustern. Apple hat das Protokoll von EXO in macOS Tahoe 26.2 integriert.
Wichtige EXO-Funktionen:
- Auto-Discovery: Erkennt automatisch andere Geräte im Netzwerk
- Peer-to-Peer-Architektur: Keine Master-Worker-Hierarchie
- Intelligente Partitionierung: Teilt Modelle optimal basierend auf Gerätefähigkeiten auf
- ChatGPT-kompatible API: OpenAI-kompatibler Endpunkt unter
localhost:52415
Schritt-für-Schritt Cluster-Einrichtungsanleitung
Voraussetzungen
Bevor Sie beginnen, stellen Sie sicher, dass Sie Folgendes haben:
- macOS Tahoe 26.2 oder neuer auf allen Macs installiert
- Thunderbolt 5 Kabel (unter 2 Metern)
- Python 3.12+ installiert
- Passwortloses SSH zwischen Maschinen konfiguriert
- Gleiches Netzwerk für alle Maschinen (für anfängliche Entdeckung)
Methode 1: MLX Native Setup (Empfohlen)
Schritt 1: MLX installieren
# MLX über pip installieren
pip install mlx

# Installation überprüfen
python -c "import mlx.core as mx; print(mx.__version__)"
Schritt 2: Thunderbolt-Netzwerk konfigurieren
Verbinden Sie Ihre Macs in einer Ringtopologie mit Thunderbolt 5 Kabeln:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1Verwenden Sie das MLX-Tool für verteilte Konfiguration:
# Thunderbolt-Ring entdecken und Konfiguration generieren
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# Alle Knoten automatisch konfigurieren (erfordert passwortloses sudo)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
Schritt 3: Hostfile-Konfiguration erstellen
Erstellen Sie eine ring-4.json Datei:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
Schritt 4: Verteilte Kommunikation testen
Erstellen Sie ein Testskript test_distributed.py:
import mlx.core as mx

# Verteilte Gruppe initialisieren
world = mx.distributed.init()

# Jeder Prozess erstellt ein Array mit seinem Rang
x = mx.ones(10) * world.rank()

# Summiere Arrays über alle Prozesse
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
Starten Sie den Test:
mlx.launch --hostfile ring-4.json test_distributed.pyErwartete Ausgabe (4 Knoten):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Methode 2: EXO Setup (Benutzerfreundlich)
Schritt 1: EXO klonen und installieren
# Repository klonen
git clone https://github.com/exo-explore/exo.git
cd exo

# Abhängigkeiten installieren
pip install -e .

# Oder das Installationsskript verwenden
source install.sh
Schritt 2: MLX für Apple Silicon konfigurieren
# MLX-Konfigurationsskript ausführen
./configure_mlx.sh
Dies optimiert die GPU-Speicherzuweisung auf Apple Silicon Macs.
Schritt 3: Cluster starten
Führen Sie auf jedem Knoten den gleichen Befehl aus:
exoEXO wird:
- Andere Knoten automatisch über Peer-to-Peer-Kommunikation entdecken
- Ring-Speicher gewichtete Partitionierung anwenden
- Die Weboberfläche unter
http://localhost:52415starten - Den API-Endpunkt unter
http://localhost:52415/v1/chat/completionsstarten
Schritt 4: Auf die Oberfläche zugreifen
Öffnen Sie Ihren Browser unter http://localhost:52415, um eine ChatGPT-ähnliche Oberfläche zur Interaktion mit Ihrem Cluster zu erhalten.
Ausführen großer Sprachmodelle
Modelle herunterladen
EXO unterstützt verschiedene Modellquellen:
# Von Hugging Face herunterladen
exo download moonshotai/Kimi-K2-Instruct

# Llama-Modelle herunterladen
exo download meta-llama/Llama-3.1-70B-Instruct
Speicheranforderungen nach Modell
| Modell | Parameter | Erforderlicher Speicher | Empfohlener Cluster |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 GB | Einzelner Mac |
| Llama 3.1 70B | 70B | 140 GB | 3x Mac mini (64 GB) |
| Llama 3.1 405B | 405B | 810 GB | 4x Mac Studio (512 GB) |
| Kimi K2 | 1T (32B aktiv) | 594 GB | 2x Mac Studio (512 GB) |
| Kimi K2 Thinking | 1T (32B aktiv) | 594 GB | 2x Mac Studio (512 GB) |
Ausführen von Kimi K2 Thinking
Das Kimi K2 Thinking Modell demonstriert die Leistungsfähigkeit von Thunderbolt 5 Clustering. Es ist ein 1 Billion Parameter Mixture-of-Experts (MoE) Modell mit 32 Milliarden aktiven Parametern. Entwickelt von Moonshot AI, repräsentiert es die Spitze der Open-Source-Reasoning-Modelle.
Was Kimi K2 besonders macht:
- Architektur: Mixture-of-Experts (MoE) mit 1T Gesamtparametern
- Aktive Parameter: Nur 32B Parameter pro Inferenz aktiv
- Kontextfenster: 256K Token
- Quantisierung: Native INT4 für Effizienz
- Größe auf der Festplatte: ~594 GB (vs 1 TB+ für volle Präzision)
import mlx.core as mx
from mlx_lm import load, generate

# Verteilte Umgebung initialisieren
world = mx.distributed.init()

# Modell laden (automatisch über Knoten verteilt)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# Text generieren
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
Leistungsergebnisse (4x Mac Studio M3 Ultra):
- Gesamtspeicher: 2 TB Unified
- Stromverbrauch: Unter 500 W (vs 5.000 W+ für GPU-Cluster)
- Token-Generierung: Wettbewerbsfähig mit Cloud-Inferenz
- Kosteneffizienz: 10x niedrigerer Stromverbrauch als NVIDIA RTX 5090 Cluster
Leistungsoptimierung
Netzwerktopologie Best Practices
Ringtopologie (Empfohlen für 4+ Knoten):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
Sterntopologie (Einfache 2-3 Knoten):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3Kabel- und Verbindungsrichtlinien
| Faktor | Empfehlung | Auswirkung |
|---|---|---|
| Kabellänge | Unter 2 Metern | Behält volle 80 Gbit/s bei |
| Kabelqualität | Zertifiziertes TB5/USB4 v2 | Verhindert Datenfehler |
| Hubs vermeiden | Direkte Verbindungen | Hubs reduzieren auf 10 Gbit/s |
| Port-Auswahl | Alle verfügbaren nutzen | Maximiert Bandbreite |
Speicher- und Rechenbalance
Beim Aufbau eines heterogenen Clusters (gemischte Hardware):
# MLX balanciert automatisch basierend auf Gerätefähigkeiten
# Aber Sie können die Partitionierung anpassen:

import mlx.core as mx

# Verteilte Welt-Infos abrufen
world = mx.distributed.init()

# Benutzerdefinierte Gewichtszuweisung
weights = {
    0: 2.0,  # Mac Studio erhält 2x Anteil
    1: 1.0,  # Mac mini erhält 1x Anteil
    2: 1.0,
    3: 1.0
}
Fehlerbehebung bei häufigen Problemen
Verbindungsprobleme
Problem: Knoten entdecken sich nicht gegenseitig
# Thunderbolt-Verbindungsstatus prüfen
system_profiler SPThunderboltDataType

# Netzwerkschnittstellen überprüfen
networksetup -listallhardwareports

# Direkte Konnektivität testen
ping mac2.local
Problem: Langsame Übertragungsgeschwindigkeiten
# Thunderbolt-Bandbreite testen
iperf3 -c mac2.local -p 5201

# Erwartet: ~9-10 GB/s für TB5
# Wenn niedriger: Kabellänge/-qualität prüfen
MLX Fehler
Problem: "No distributed backend available"
# Sicherstellen, dass MLX ordnungsgemäß installiert ist
pip install --upgrade mlx

# Python-Version prüfen (erfordert 3.12+)
python --version
Problem: "Out of memory" bei verteilter Inferenz
# Speichereffizienten Modus aktivieren
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # Nutze 95% des verfügbaren Speichers

# Oder Batch-Größe reduzieren
generate(model, tokenizer, prompt=prompt, max_tokens=100)
SSH Konfiguration
Stellen Sie passwortloses SSH zwischen allen Knoten sicher:
# SSH-Schlüssel generieren, falls erforderlich
ssh-keygen -t ed25519

# Auf alle Knoten kopieren
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# Testen
ssh mac2.local "hostname"
Energieeffizienz und Kostenanalyse
Stromverbrauchsvergleich
| Konfiguration | Stromverbrauch | Leistung | $/Leistung |
|---|---|---|---|
| 4x Mac Studio (512 GB) | ~500 W | Billion-Parameter-fähig | Am besten |
| NVIDIA H100 Cluster (4x) | ~2.800 W | Ähnliche Fähigkeit | 5,6x mehr Strom |
| NVIDIA RTX 5090 Cluster | ~2.300 W | Begrenzter VRAM | 4,6x mehr Strom |
Gesamtbetriebskosten (TCO)
Mac Studio Cluster (2 TB Konfiguration):
- Hardware: 47.000 $
- Jährlicher Strom (24/7): ~500 $
- Wartung: Minimal
- 5-Jahres-TCO: ~49.500 $
Äquivalenter GPU-Cluster:
- Hardware: 100.000 $+
- Jährlicher Strom (24/7): ~3.000 $
- Kühlungsinfrastruktur: 10.000 $+
- Wartung: Signifikant
- 5-Jahres-TCO: ~130.000 $+
Anwendungsfälle und Anwendungen
Machine Learning Forschung
Thunderbolt 5 Clustering zeichnet sich in der akademischen und unternehmerischen ML-Forschung aus:
Forschungsanwendungen:
- Modelltraining: Verteiltes Training über mehrere Macs mit Gradientensynchronisation
- Fine-Tuning: Lokales Feintuning großer Modelle auf proprietären Datensätzen
- Inferenz: Ausführung von Billionen-Parameter-Modellen lokal für Experimente
- Ablationsstudien: Schnelles Prototyping ohne Warten auf Cloud-GPU-Verfügbarkeit
Beispiel Forschungs-Workflow:
import mlx.core as mx
from mlx_lm import load, generate

# Laden Sie Ihr feinabgestimmtes Modell
model, tokenizer = load("./my-finetuned-model")

# Experimente über verteilten Cluster ausführen
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
Universitäten und Forschungslabore profitieren von:
- Fixen Hardwarekosten vs. unvorhersehbaren Cloud-Abrechnungen
- Vollständiger Datensicherheit für sensible Forschung
- Lehrressourcen für Kurse zu verteiltem Rechnen
- Reproduzierbaren Experimenten, bereit zur Veröffentlichung
Professionelle Kreativ-Workflows
Die Integration in das kreative Ökosystem von Apple bietet einzigartige Vorteile:
Videoproduktion:
- Verteiltes Rendering: Final Cut Pro, DaVinci Resolve, Motion Projekte
- AI-gestützte Bearbeitung: Lokale AI-Modelle für Szenenerkennung, Transkription
- Farbkorrektur: GPU-beschleunigte Farbverarbeitung über Knoten hinweg
- 8K RAW Verarbeitung: Ausreichend Speicher für große Videodateien
Audioproduktion:
- Logic Pro Verteilte Verarbeitung: Plugin-Rendering über Knoten hinweg
- AI-Musikgenerierung: Ausführung lokaler Musik-AI-Modelle
- Audio-Restaurierung: ML-basierte Rauschunterdrückung lokal
3D und Motion Graphics:
- Blender Verteiltes Rendering: Cycles-Rendering über Mac-Cluster
- Cinema 4D: CPU-Rendering mit Cluster-Unterstützung
- Houdini: Simulationsverteilung (mit entsprechenden Plugins)
Weitere Informationen zu kreativen Workflows finden Sie in unserem macOS Tahoe Professional Workflow Revolution Guide.
Entwicklung und Testen
Die Entwicklung moderner AI-Anwendungen profitiert erheblich von lokalen Clustern:
AI-gestützte Anwendungsentwicklung:
# Beispiel: Bau eines AI-Chatbots mit lokaler Inferenz
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
Entwicklervorteile:
- Lokale LLM-Entwicklung: Testen und iterieren ohne API-Ratenbegrenzungen
- CI/CD-Beschleunigung: Verteilte Build- und Testsysteme
- AI-Anwendungsentwicklung: Apps mit lokalen AI-Backends bauen
- Kostenloses Experimentieren: Keine Gebühren pro Anfrage während der Entwicklung
Testvorteile:
- Testen gegen Modelle im Produktionsmaßstab lokal
- Keine Netzwerklatenz in Testumgebungen
- Konsistente, reproduzierbare Testergebnisse
- Volle Kontrolle über Modellversionen
Überprüfen Sie unseren macOS Tahoe Developer Setup Guide für die Konfiguration der Entwicklungsumgebung.
Unternehmensbereitstellungsszenarien
Große Organisationen setzen Mac-Cluster ein für:
Interne AI-Assistenten:
- Private ChatGPT-ähnliche Schnittstellen
- Dokumentenanalyse und -zusammenfassung
- Code-Review und -Generierung
- Meeting-Transkription und -Analyse
Compliance-sensible Branchen:
- Gesundheitswesen: HIPAA-konforme AI-Verarbeitung
- Finanzen: On-Premise-Modellinferenz
- Recht: Vertrauliche Dokumentenanalyse
- Regierung: Air-Gapped AI-Fähigkeiten
Kosten-Nutzen-Analyse für Unternehmen:
| Szenario | Cloud-Kosten/Jahr | Mac-Cluster-Kosten/Jahr | Ersparnis |
|---|---|---|---|
| Leicht (1M Token/Tag) | ~11.000 $ | ~3.000 $ (amortisiert) | 73% |
| Mittel (10M Token/Tag) | ~110.000 $ | ~15.000 $ (amortisiert) | 86% |
| Schwer (100M Token/Tag) | ~1,1 Mio. $ | ~60.000 $ (amortisiert) | 95% |
Zukunft des Mac-Clusterings
M5 und darüber hinaus
Der Apple M5 Chip führt Neural Accelerators in jedem GPU-Kern ein und liefert eine 4-fache Verbesserung der AI-Leistung. In Kombination mit Thunderbolt 5 Clustering:
- Erweiterte MLX-Unterstützung: Voller Zugriff auf M5 Neural Accelerators
- Verbesserte Speicherbandbreite: 153 GB/s pro Chip
- Bessere Energieeffizienz: Mehr Leistung pro Watt
Implikationen für den Mac Pro
Berichten zufolge hat Apple den Mac Pro intern "weitgehend abgeschrieben". Thunderbolt 5 Clustering bietet einen alternativen Weg:
- Skalierbare Leistung: Fügen Sie Knoten nach Bedarf hinzu
- Niedrigere Einstiegskosten: Klein anfangen, später erweitern
- Flexibilität: Mischen Sie verschiedene Mac-Modelle
- Zukunftssicher: Rüsten Sie einzelne Knoten im Laufe der Zeit auf
Sicherheits- und Datenschutzüberlegungen
Warum lokale Verarbeitung wichtig ist
Einer der bedeutendsten Vorteile von Mac-Clustering gegenüber Cloud-basierter AI ist die vollständige Datensicherheit. Ihre Prompts, Trainingsdaten und generierten Ausgaben verlassen niemals Ihr lokales Netzwerk.
Datenschutzvorteile:
- Keine Datenübertragung: Alle Verarbeitungen finden vor Ort statt
- Compliance-freundlich: Einfachere Einhaltung von HIPAA, DSGVO, SOC2
- IP-Schutz: Proprietäre Daten bleiben privat
- Keine Logging-Bedenken: Volle Kontrolle über Nutzungsprotokolle
Sicherheits-Best-Practices für Mac-Cluster:
- Netzwerkisolierung: Halten Sie Ihren Cluster in einem dedizierten VLAN
- Firewall-Konfiguration: Blockieren Sie externen Zugriff auf Cluster-Ports
- SSH-Schlüsselverwaltung: Verwenden Sie ed25519-Schlüssel, rotieren Sie regelmäßig
- macOS-Sicherheit: Aktivieren Sie FileVault, halten Sie Systeme auf dem neuesten Stand
- Physische Sicherheit: Sichern Sie den Zugang zum Serverraum
Für eine umfassende macOS-Sicherheitskonfiguration siehe unseren macOS Tahoe Security & Privacy Guide.
Reale Leistungs-Benchmarks
Inferenz-Geschwindigkeitsvergleich
Basierend auf Community-Tests und Apples Demonstrationen:
| Modell | Konfiguration | Token/Sekunde | Vergleich |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 GB) | ~35 tok/s | Vergleichbar mit RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 GB) | ~15 tok/s | Übertrifft Cloud A100 |
| Kimi K2 | 2x Mac Studio (512 GB) | ~20 tok/s | Erstes lokales Billionen-Parameter |
| DeepSeek V3 | 4x Mac Studio (512 GB) | ~12 tok/s | Zuvor nur Cloud |
Latenzanalyse
| Metrik | Mac Cluster | Cloud API | Unterschied |
|---|---|---|---|
| Erstes Token | 100-500ms | 500-2000ms | 2-10x schneller |
| Konsistente Latenz | Ja | Variabel | Vorhersehbarer |
| Kaltstart | Keiner | 5-30s | Kein Warten |
| Verfügbarkeit | 100% (lokal) | 99,9% | Keine Ausfälle |
Kosten pro Token Vergleich
Annahme: 24/7 Betrieb über 1 Jahr:
| Lösung | Hardwarekosten | Betriebskosten | Gesamt 1 Jahr | Kosten/1M Token |
|---|---|---|---|---|
| 4x Mac Studio Cluster | 47.000 $ | ~500 $ | 47.500 $ | ~0,02 $ |
| OpenAI GPT-4 | 0 $ | Nutzungsbasiert | Variabel | ~30,00 $ |
| Claude API | 0 $ | Nutzungsbasiert | Variabel | ~15,00 $ |
| AWS Bedrock | 0 $ | Nutzungsbasiert | Variabel | ~10,00 $ |
Für Heavy User (>100 Mio. Token/Jahr) wird lokales Mac-Clustering deutlich wirtschaftlicher.
FAQ
Wie viele Macs kann ich in einem Cluster verbinden?
Die praktische Grenze hängt von Ihrer Topologie ab. Mit direkten Thunderbolt-Verbindungen (ohne Hubs) können Sie 4-6 Macs effizient verbinden. Die Verwendung einer Ringtopologie ermöglicht die Skalierung auf mehr Knoten bei Beibehaltung der vollen Bandbreite. Jenseits von 6 Knoten benötigen Sie eine sorgfältige Topologieplanung, um Bandbreitenengpässe zu vermeiden.
Benötige ich identische Macs für das Clustering?
Nein, MLX und EXO unterstützen heterogene Cluster. Der Cluster wird jedoch durch die langsamste Komponente begrenzt. Für beste Ergebnisse verwenden Sie Macs ähnlicher Generation mit passenden Thunderbolt-Versionen. Die Speicherverteilung wird nach dem verfügbaren RAM jedes Knotens gewichtet.
Kann ich Thunderbolt 4 Macs in einem Cluster verwenden?
Ja, aber die Bandbreite dieser Verbindungen wird auf 40 Gbit/s begrenzt. Thunderbolt 5 und 4 sind abwärtskompatibel. Das System arbeitet mit der niedrigeren Geschwindigkeit, wenn Generationen gemischt werden. Für beste Leistung halten Sie TB4-Knoten als Blattknoten und nicht in der Mitte eines Rings.
Was ist der minimale Speicherbedarf für Clustering?
Der gesamte Clusterspeicher muss die Speicheranforderung Ihres Modells mit etwas Spielraum für Operationen übersteigen. Für Llama 3.1 70B (140 GB Modell) benötigen Sie mindestens 3 Macs mit jeweils 48 GB (144 GB gesamt). Wir empfehlen 10-20% Spielraum über der Modellgröße.
Ist Mac-Clustering für Training oder nur für Inferenz geeignet?
Beides! MLX unterstützt verteiltes Training mit Gradientenmittelung über Knoten hinweg. Inferenz ist jedoch aufgrund der Vorteile des Speicher-Poolings für große Modelle der primäre Anwendungsfall. Training erfordert mehr Kommunikation zwischen den Knoten und ist empfindlicher gegenüber Netzwerklatenz.
Wie verhält sich dies im Vergleich zu Cloud-GPU-Instanzen?
Für die Langzeitnutzung (mehr als 6 Monate regelmäßige Nutzung) ist Mac-Clustering kostengünstiger. Sie besitzen die Hardware, haben keine stündlichen Gebühren und erreichen wettbewerbsfähige Leistung. Für gelegentliche Nutzung oder Experimente können Cloud-Instanzen anfangs wirtschaftlicher sein.
Kann ich den Cluster 24/7 betreiben?
Absolut. Mac-Hardware ist für den Dauerbetrieb ausgelegt. Insbesondere Mac Studios verfügen über ein hervorragendes Wärmemanagement für dauerhafte Arbeitslasten. Überwachen Sie die Temperaturen mit der Aktivitätsanzeige oder sudo powermetrics und sorgen Sie für ausreichende Belüftung.
Was passiert, wenn ein Knoten ausfällt?
Derzeit unterstützt MLX-Clustering kein Hot-Swapping oder automatisches Failover. Wenn ein Knoten die Verbindung trennt, schlägt der Job fehl und muss neu gestartet werden. Für kritische Workloads implementieren Sie Checkpointing in Ihrem Code, um vom letzten gespeicherten Zustand fortzufahren.
Kann ich den Cluster verwenden, während AI-Workloads laufen?
Ja, aber die Leistung kann beeinträchtigt werden. Die EXO-Schnittstelle ermöglicht Hintergrundoperationen, während Sie die Macs für andere Aufgaben verwenden. Für beste Inferenzleistung minimieren Sie andere Aktivitäten während schwerer AI-Workloads.
Fazit
macOS Tahoe 26.2's Thunderbolt 5 Clustering repräsentiert einen Paradigmenwechsel im lokalen AI-Computing. Durch die Kombination mehrerer Macs zu einem einheitlichen Supercomputer können Benutzer Billionen-Parameter-Modelle zu einem Bruchteil der Kosten traditioneller GPU-Cluster ausführen.
Hauptvorteile:
- 10x geringerer Stromverbrauch als GPU-Alternativen
- Keine spezielle Hardware erforderlich
- Einfache Einrichtung mit MLX und EXO
- Skalierbar von 2 auf 6+ Knoten
- Lokale, private AI-Verarbeitung
Für Benutzer, die in das Apple-Ökosystem investiert sind, kann diese Funktion allein das Upgrade auf macOS Tahoe 26.2 rechtfertigen. Lesen Sie unseren macOS Tahoe 26.2 Update-Guide für vollständige Update-Anweisungen.
Bereit, Ihren Mac für AI-Workloads zu optimieren? Beginnen Sie mit unserem macOS Tahoe Speichermanagement-Guide, um sicherzustellen, dass Sie ausreichend Platz für große Modelle haben.
Quellen
- ML in macOS Tahoe gets GPU, Thunderbolt 5 clustering boost - Apple Insider, November 2025
- You can turn a cluster of Macs into an AI supercomputer in macOS Tahoe 26.2 - Engadget, November 2025
- A cluster of Mac Studios is just one reason we no longer need a Mac Pro - 9to5Mac, November 2025
- AI Cluster: Four Macs with 2 TB can run the giant model Kimi K2 Thinking - Heise Online, November 2025
- MLX Distributed Communication Documentation - Apple MLX Official Docs
- EXO: Run your own AI cluster at home - EXO Labs GitHub
- Explore large language models on Apple silicon with MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - Moonshot AI Official