دليل تجميع Thunderbolt 5 في macOS Tahoe 26.2: ابنِ حاسوبك الفائق للذكاء الاصطناعي
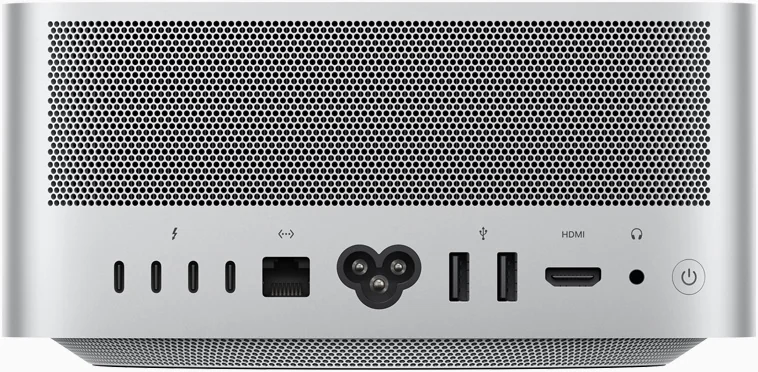
دليل كامل لبناء مجموعات Mac باستخدام Thunderbolt 5 في macOS Tahoe 26.2. تعرف على إعداد إطار عمل MLX، وتكوين EXO، ومتطلبات الأجهزة، وتشغيل نماذج الذكاء الاصطناعي بتريليون معلمة محليًا.
يقدم macOS Tahoe 26.2 ميزة ثورية تحول أجهزة Mac متعددة إلى حاسوب فائق موحد للذكاء الاصطناعي باستخدام تجميع Thunderbolt 5. يغطي هذا الدليل الشامل كل شيء بدءًا من متطلبات الأجهزة ووصولًا إلى تشغيل نماذج بتريليون معلمة مثل Kimi K2 Thinking على مجموعة Mac الخاصة بك.
النقاط الرئيسية
- تجميع Thunderbolt 5 في macOS Tahoe 26.2 يتيح توصيل أجهزة Mac متعددة بسرعة تصل إلى 80 جيجابت في الثانية ثنائية الاتجاه
- أربعة أجهزة Mac Studio بذاكرة 512 جيجابايت لكل منها يمكنها تشغيل نموذج Kimi K2 Thinking بتريليون معلمة باستخدام أقل من 500 واط من إجمالي الطاقة
- الأجهزة المتوافقة تشمل M4 Pro Mac mini و M4 Pro/Max MacBook Pro و M3 Ultra Mac Studio
- إطار عمل MLX وبرنامج EXO 1.0 يوفران البنية التحتية للحوسبة الموزعة
- لا توجد أجهزة خاصة مطلوبة - فقط كابلات Thunderbolt 5 القياسية بطول أقل من 2 متر
ملخص تنفيذي: فهم تقنية تجميع Mac
لماذا يهم تجميع Thunderbolt 5
يمثل إصدار macOS Tahoe 26.2 لحظة محورية في استراتيجية الحوسبة الاحترافية لشركة Apple. لأول مرة، توفر Apple دعمًا أصليًا ومحسّنًا لتوصيل أجهزة Mac متعددة في مجموعة حوسبة موحدة باستخدام النطاق الترددي غير المسبوق لـ Thunderbolt 5. هذا ليس مجرد تحسين تدريجي - إنه يغير بشكل جذري ما هو ممكن باستخدام أجهزة Mac.
المشكلة التي يحلها:
تطلب تشغيل نماذج الذكاء الاصطناعي الكبيرة تقليديًا مجموعات GPU باهظة الثمن مع استهلاك هائل للطاقة. قد يتضمن الإعداد النموذجي لنماذج التريليون معلمة ما يلي:
- مجموعة NVIDIA H100: أجهزة بقيمة 400,000 دولار+، استهلاك طاقة 10 كيلوواط+
- حالات GPU السحابية: 2-5 دولار في الساعة للحالات القادرة
- البنية التحتية المخصصة لمركز البيانات: التبريد، توزيع الطاقة، الشبكات
حل مجموعة Mac:
مع تجميع Thunderbolt 5، يمكنك تحقيق قدرات مماثلة مع:
- 4x Mac Studio: أجهزة بقيمة 47,000 دولار (تخفيض التكلفة بنسبة 88% مقابل H100)
- استهلاك الطاقة: أقل من 500 واط (تخفيض بنسبة 95%)
- لا توجد بنية تحتية: بيئة مكتبية قياسية
- المعالجة المحلية: خصوصية بيانات كاملة
من يستفيد من تجميع Mac؟
باحثو الذكاء الاصطناعي ومهندسو تعلم الآلة:
- تشغيل النماذج الحدودية محليًا دون الاعتماد على السحابة
- التكرار بشكل أسرع مع الأجهزة المخصصة
- الحفاظ على السيطرة الكاملة على بيانات التدريب
المحترفون المبدعون:
- عرض الفيديو الموزع عبر أجهزة Mac متعددة
- التحرير بمساعدة الذكاء الاصطناعي مع النماذج المحلية
- معالجة الملفات الكبيرة دون تأخير الشبكة
فرق تكنولوجيا المعلومات في المؤسسات:
- عمليات نشر الذكاء الاصطناعي الخاصة
- بنية تحتية بتكلفة يمكن التنبؤ بها
- صيانة مبسطة مقارنة بمجموعات GPU
المطورون المستقلون:
- بناء تطبيقات الذكاء الاصطناعي مع الاستدلال المحلي
- الاختبار ضد النماذج الكبيرة أثناء التطوير
- شحن المنتجات دون تكاليف API مستمرة
ما هو تجميع Thunderbolt 5 Mac؟
تطور الحوسبة الموزعة على Mac
يمثل تجميع Thunderbolt 5 Mac إحياء Apple الحديث للحوسبة الموزعة على Mac. قد يتذكر مستخدمو Apple القدامى Xgrid، الذي حول مجموعات من أجهزة Mac إلى حواسيب فائقة. يتبع تجميع Thunderbolt 5 الجديد في macOS Tahoe 26.2 مفهومًا مشابهًا ولكنه يعمل بسرعات أعلى بشكل كبير.
السياق التاريخي:
- عصر Xgrid: يقتصر على سرعات Ethernet (1-10 جيجابت في الثانية)
- مجموعات Thunderbolt 4: 40 جيجابت في الثانية، استخدام المحور يقلل السرعات إلى 10 جيجابت في الثانية
- مجموعات Thunderbolt 5: 80 جيجابت في الثانية ثنائية الاتجاه بالكامل، وضع الاندفاع 120 جيجابت في الثانية
كيف يعمل تجميع Thunderbolt 5
تستخدم تقنية التجميع الوصول المباشر للذاكرة عن بُعد (RDMA)، مما يسمح لجهاز Mac بالوصول مباشرة إلى ذاكرة جهاز آخر دون عبء على وحدة المعالجة المركزية. عند توصيل أجهزة Mac متعددة عبر Thunderbolt 5:
- تجميع الذاكرة: تصبح الذاكرة الموحدة لكل جهاز Mac متاحة للمجموعة بأكملها
- تقسيم النموذج: يتم تقسيم نماذج الذكاء الاصطناعي الكبيرة عبر الأجهزة بشكل متناسب
- المعالجة المتوازية: يتم توزيع أعباء العمل بناءً على الموارد المتاحة
- اتصال منخفض الكمون: يزيل الوصول المباشر للذاكرة اختناقات الشبكة
مثال على تكوين تجمع الذاكرة:
| التكوين | إجمالي الذاكرة | حالة الاستخدام |
|---|---|---|
| 2x Mac Studio (512 جيجابايت) | 1 تيرابايت مشترك | Kimi K2 Thinking (594 جيجابايت) |
| 4x Mac Studio (512 جيجابايت) | 2 تيرابايت مشترك | نماذج متعددة بتريليون معلمة |
| 4x Mac mini M4 Pro (64 جيجابايت) | 256 جيجابايت مشترك | نماذج 70B-200B معلمة |
ميزة الذاكرة الموحدة لـ Apple Silicon
يكمن أحد الأسباب الرئيسية لفعالية تجميع Mac في بنية الذاكرة الموحدة لـ Apple Silicon. على عكس أجهزة الكمبيوتر التقليدية حيث تمتلك وحدة معالجة الرسومات ووحدة المعالجة المركزية مجموعات ذاكرة منفصلة، تشارك Apple Silicon الذاكرة بين جميع وحدات المعالجة.
فوائد الذاكرة الموحدة للتجميع:
| الجانب | البنية التقليدية | Apple Silicon |
|---|---|---|
| الوصول للذاكرة | تنسخ وحدة معالجة الرسومات البيانات من ذاكرة الوصول العشوائي | وصول مشترك مباشر |
| النطاق الترددي | محدود بواسطة PCIe (64 جيجابايت/ثانية) | يصل إلى 800 جيجابايت/ثانية (M3 Ultra) |
| الكفاءة | تكرار البيانات مطلوب | عمليات النسخ الصفري |
| قابلية التوسع | تحد VRAM من حجم النموذج | يتوسع التجمع الموحد خطيًا |
عندما تقوم بتجميع أجهزة Mac متعددة، فأنت تنشئ فعليًا تجمع ذاكرة موحدة أكبر. يمكن تقسيم النموذج الذي يكون كبيرًا جدًا بالنسبة لذاكرة جهاز Mac واحد عبر العقد، حيث يحتفظ كل جهاز Mac بجزء ويشارك الوصول عبر Thunderbolt 5.
مثال عملي:
- جهاز Mac Studio واحد (512 جيجابايت): يمكنه تشغيل نماذج تصل إلى ~450 جيجابايت (مع ترك مساحة)
- 2x Mac Studio (1 تيرابايت مجمعة): يمكنه تشغيل نماذج تصل إلى ~900 جيجابايت
- 4x Mac Studio (2 تيرابايت مجمعة): يمكنه تشغيل نماذج تصل إلى ~1.8 تيرابايت
هذا التوسع الخطي هو ما يجعل نماذج التريليون معلمة مثل Kimi K2 Thinking ممكنة على أجهزة Mac.
متطلبات الأجهزة والتوافق
طرازات Mac المتوافقة
دعم Thunderbolt 5 الأصلي (80 جيجابت في الثانية بالكامل):
| الجهاز | منافذ Thunderbolt 5 | الحد الأقصى للذاكرة | ملاحظات |
|---|---|---|---|
| Mac Studio (M3 Ultra) | 6 | 512 جيجابايت | الأفضل للمجموعات الكبيرة |
| Mac mini (M4 Pro) | 3 أمامية | 64 جيجابايت | عقد فعالة من حيث التكلفة |
| MacBook Pro 14" (M4 Pro) | 3 | 48 جيجابايت | تجميع محمول |
| MacBook Pro 16" (M4 Max) | 3 | 128 جيجابايت | محمول بذاكرة عالية |
مواصفات مهمة:
- سرعة Thunderbolt 5: 80 جيجابت في الثانية ثنائية الاتجاه (120 جيجابت في الثانية وضع الاندفاع للفيديو)
- نطاق ذاكرة الترددي: يوفر M4 Pro 273 جيجابايت/ثانية، و M4 Max يوفر 546 جيجابايت/ثانية
- طول الكابل: حافظ على أقل من 2 متر للحصول على الأداء الأمثل
- نوع الكابل: كابلات Thunderbolt 5 القياسية (متوافقة مع USB4 v2)
تكوينات المجموعة الموصى بها
مجموعة الميزانية (تجارب تعلم الآلة):
4x Mac mini M4 Pro (24 جيجابايت لكل منها)
إجمالي الذاكرة: 96 جيجابايت مشتركة
التكلفة: ~7,200 دولار
الأفضل لـ: نماذج تصل إلى 70B معلمة
استهلاك الطاقة: ~60 واط خمول، ~200 واط ذروة
مستوى الضوضاء: صامت تقريبًا
هذا التكوين مثالي للمطورين الذين يتعلمون ML الموزع، أو الفرق الصغيرة التي تجرب نماذج مفتوحة المصدر، أو تشغيل نماذج أصغر مثل Llama 3.1 8B و Mistral 7B بأداء ممتاز.
مجموعة احترافية (أعباء عمل الذكاء الاصطناعي الإنتاجية):
4x Mac mini M4 Pro (64 جيجابايت لكل منها)
إجمالي الذاكرة: 256 جيجابايت مشتركة
التكلفة: ~13,200 دولار
الأفضل لـ: نماذج تصل إلى 200B معلمة
استهلاك الطاقة: ~80 واط خمول، ~300 واط ذروة
مستوى الضوضاء: صامت تقريبًا
يفتح المستوى الاحترافي نماذج متوسطة وكبيرة مثل Llama 3.1 70B ويمكنه تشغيل الاستدلال على نماذج من فئة المؤسسات. هذه هي النقطة المثالية لمعظم الشركات التي تنشر الذكاء الاصطناعي المحلي.
مجموعة المؤسسات (نماذج التريليون معلمة):
4x Mac Studio M3 Ultra (512 جيجابايت لكل منها)
إجمالي الذاكرة: 2 تيرابايت مشتركة
التكلفة: ~47,000 دولار (47,000 يورو)
الأفضل لـ: Kimi K2 Thinking، DeepSeek V3، النماذج الحدودية
استهلاك الطاقة: ~100 واط خمول، ~500 واط ذروة
مستوى الضوضاء: متوسط تحت الحمل
يطابق هذا التكوين من الدرجة الأولى أو يتجاوز مجموعات GPU لمراكز البيانات لأعباء عمل الاستدلال بينما يستهلك جزءًا صغيرًا من الطاقة ولا يتطلب بنية تحتية متخصصة.
دليل اختيار كابل Thunderbolt 5
يعد اختيار الكابلات المناسبة أمرًا بالغ الأهمية لأداء المجموعة. لا تدعم جميع الكابلات سرعات Thunderbolt 5 الكاملة.
الكابلات الموصى بها:
| الكابل | الطول | السرعة القصوى | نطاق السعر |
|---|---|---|---|
| Apple Thunderbolt 5 Pro | 1 متر | 120 جيجابت في الثانية | 69-79 دولار |
| OWC Thunderbolt 5 | 0.8 متر | 80 جيجابت في الثانية | 50-60 دولار |
| CalDigit TB5 Cable | 1 متر | 80 جيجابت في الثانية | 45-55 دولار |
| Belkin Connect Pro | 1 متر | 80 جيجابت في الثانية | 40-50 دولار |
نصائح اختيار الكابل:
- التزم بأقل من 1 متر: تتطلب 80 جيجابت في الثانية الكاملة كابلات قصيرة وعالية الجودة
- ابحث عن شهادة USB4 v2: تضمن التوافق مع Thunderbolt 5
- تجنب المحولات: اتصالات مباشرة TB5 إلى TB5 فقط
- اشترِ من علامات تجارية مرموقة: قد لا تحقق الكابلات المقلدة السرعات المقدرة
- اختبر الكابلات قبل النشر: استخدم
system_profiler SPThunderboltDataTypeللتحقق من سرعة الرابط
تحذير: العديد من الكابلات المباعة عبر الإنترنت على أنها "متوافقة مع Thunderbolt 5" تحقق فقط سرعات Thunderbolt 4. تحقق دائمًا من المواصفات قبل الشراء.
مجموعة البرامج: أطر عمل MLX و EXO
فهم الحوسبة الموزعة MLX
MLX هو إطار عمل مصفوفة مفتوح المصدر من Apple مصمم خصيصًا لتعلم الآلة على Apple Silicon. يوفر دعمًا أصليًا للحوسبة الموزعة عبر أجهزة Mac متعددة.
الميزات الرئيسية لـ MLX:
- الوصول الموحد للذاكرة: يستفيد من بنية الذاكرة الموحدة لـ Apple Silicon
- التقييم الكسول: لا يتم تنفيذ الحسابات إلا عند الحاجة إلى النتائج
- التجميع الديناميكي: تجميع في الوقت المناسب للحصول على الأداء الأمثل
- البدائيات الموزعة: دعم مدمج للعمليات متعددة الأجهزة
الخلفيات الاتصالية لـ MLX
يدعم MLX ثلاث خلفيات اتصال لحالات استخدام مختلفة:
| الخلفية | السرعة | الأفضل لـ | تعقيد الإعداد |
|---|---|---|---|
| Ring | الأسرع | اتصالات Thunderbolt | متوسط |
| MPI | سريع | شبكات Ethernet | أعلى |
| NCCL | غير متاح | بيئات CUDA | غير متاح على Mac |
يوصى بخلفية Ring لمجموعات Thunderbolt 5 لأنها محسّنة للاتصالات المباشرة من نظير إلى نظير.
فهم التدريب الموزع مقابل الاستدلال
قبل الغوص في الإعداد، من المهم فهم حالتي الاستخدام الأساسيتين لتجميع Mac:
الاستدلال الموزع (تشغيل النماذج): هذه هي حالة الاستخدام الأساسية لمعظم المستخدمين. عند تشغيل الاستدلال:
- يتم تقسيم النموذج عبر أجهزة Mac متعددة بناءً على الذاكرة المتاحة
- يحتفظ كل جهاز Mac بجزء من أوزان النموذج
- أثناء التوليد، تتدفق البيانات بين العقد حسب الحاجة
- لا يحدث تدريب - أنت تستخدم نموذجًا مدربًا مسبقًا
التدريب الموزع (إنشاء النماذج): للباحثين والمستخدمين المتقدمين:
- يتم تقسيم بيانات التدريب عبر العقد (توازي البيانات)
- يتم حساب متوسط التدرجات عبر جميع العقد بعد كل دفعة
- تتم مزامنة أوزان النموذج بشكل دوري
- يتطلب المزيد من الاتصال بين العقد
| حالة الاستخدام | متطلبات النطاق الترددي | التعقيد | المستخدمون النموذجيون |
|---|---|---|---|
| الاستدلال | متوسط (تحميل النموذج) | منخفض | معظم المستخدمين |
| الضبط الدقيق | مرتفع (مزامنة التدرج) | متوسط | مهندسو تعلم الآلة |
| التدريب الكامل | مرتفع جدًا (مزامنة مستمرة) | مرتفع | الباحثون |
بالنسبة لمعظم مستخدمي مجموعات Mac، فإن الاستدلال هو الهدف الأساسي - تشغيل نماذج كبيرة لا تتناسب مع جهاز واحد.
EXO: إدارة مبسطة للمجموعة
يوفر EXO (من Exo Labs) تجريدًا عالي المستوى لبناء مجموعات الذكاء الاصطناعي. قامت Apple بدمج بروتوكول EXO في macOS Tahoe 26.2.
الميزات الرئيسية لـ EXO:
- الاكتشاف التلقائي: يكتشف تلقائيًا الأجهزة الأخرى على الشبكة
- بنية نظير إلى نظير: لا يوجد تسلسل هرمي رئيسي-عامل
- التقسيم الذكي: يقسم النماذج بشكل مثالي بناءً على قدرات الجهاز
- API متوافق مع ChatGPT: نقطة نهاية متوافقة مع OpenAI في
localhost:52415
دليل إعداد المجموعة خطوة بخطوة
المتطلبات الأساسية
قبل البدء، تأكد من أن لديك:
- macOS Tahoe 26.2 أو أحدث مثبتًا على جميع أجهزة Mac
- كابلات Thunderbolt 5 (أقل من 2 متر)
- Python 3.12+ مثبت
- SSH بدون كلمة مرور تم تكوينه بين الأجهزة
- نفس الشبكة لجميع الأجهزة (للاكتشاف الأولي)
الطريقة 1: الإعداد الأصلي لـ MLX (موصى به)
الخطوة 1: تثبيت MLX
# تثبيت MLX عبر pip
pip install mlx

# التحقق من التثبيت
python -c "import mlx.core as mx; print(mx.__version__)"
الخطوة 2: تكوين شبكة Thunderbolt
قم بتوصيل أجهزة Mac الخاصة بك في طوبولوجيا حلقية باستخدام كابلات Thunderbolt 5:
Mac 1 ←→ Mac 2 ←→ Mac 3 ←→ Mac 4 ←→ Mac 1استخدم أداة التكوين الموزع لـ MLX:
# اكتشاف حلقة Thunderbolt وإنشاء التكوين
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4

# التكوين التلقائي لجميع العقد (يتطلب sudo بدون كلمة مرور)
mlx.distributed_config --verbose --hosts mac1,mac2,mac3,mac4 --auto-setup
الخطوة 3: إنشاء تكوين ملف المضيف
أنشئ ملف ring-4.json:
[
    {"ssh": "mac1.local", "ips": ["192.168.100.1"]},
    {"ssh": "mac2.local", "ips": ["192.168.100.2"]},
    {"ssh": "mac3.local", "ips": ["192.168.100.3"]},
    {"ssh": "mac4.local", "ips": ["192.168.100.4"]}
]
الخطوة 4: اختبار الاتصال الموزع
أنشئ نص اختبار test_distributed.py:
import mlx.core as mx

# تهيئة المجموعة الموزعة
world = mx.distributed.init()

# تنشئ كل عملية مصفوفة برتبتها
x = mx.ones(10) * world.rank()

# جمع المصفوفات عبر جميع العمليات
result = mx.distributed.all_sum(x)

print(f"Rank {world.rank()}: sum = {result}")
ابدأ الاختبار:
mlx.launch --hostfile ring-4.json test_distributed.pyالإخراج المتوقع (4 عقد):
Rank 0: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 1: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 2: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
Rank 3: sum = array([6., 6., 6., 6., 6., 6., 6., 6., 6., 6.])
الطريقة 2: إعداد EXO (سهل الاستخدام)
الخطوة 1: استنساخ وتثبيت EXO
# استنساخ المستودع
git clone https://github.com/exo-explore/exo.git
cd exo

# تثبيت التبعيات
pip install -e .

# أو استخدم نص التثبيت
source install.sh
الخطوة 2: تكوين MLX لـ Apple Silicon
# تشغيل نص تكوين MLX
./configure_mlx.sh
هذا يحسن تخصيص ذاكرة وحدة معالجة الرسومات على أجهزة Mac المزودة بـ Apple Silicon.
الخطوة 3: بدء المجموعة
على كل عقدة، قم بتشغيل نفس الأمر:
exoسوف يقوم EXO بما يلي:
- اكتشاف العقد الأخرى تلقائيًا عبر اتصال نظير إلى نظير
- تطبيق تقسيم الذاكرة الحلقية الموزونة
- بدء واجهة الويب في
http://localhost:52415 - بدء نقطة نهاية API في
http://localhost:52415/v1/chat/completions
الخطوة 4: الوصول إلى الواجهة
افتح متصفحك على http://localhost:52415 للحصول على واجهة تشبه ChatGPT للتفاعل مع مجموعتك.
تشغيل نماذج اللغة الكبيرة
تنزيل النماذج
يدعم EXO مصادر نماذج مختلفة:
# التنزيل من Hugging Face
exo download moonshotai/Kimi-K2-Instruct

# تنزيل نماذج Llama
exo download meta-llama/Llama-3.1-70B-Instruct
متطلبات الذاكرة حسب النموذج
| النموذج | المعلمات | الذاكرة المطلوبة | المجموعة الموصى بها |
|---|---|---|---|
| Llama 3.1 8B | 8B | 16 جيجابايت | جهاز Mac واحد |
| Llama 3.1 70B | 70B | 140 جيجابايت | 3x Mac mini (64 جيجابايت) |
| Llama 3.1 405B | 405B | 810 جيجابايت | 4x Mac Studio (512 جيجابايت) |
| Kimi K2 | 1T (32B نشط) | 594 جيجابايت | 2x Mac Studio (512 جيجابايت) |
| Kimi K2 Thinking | 1T (32B نشط) | 594 جيجابايت | 2x Mac Studio (512 جيجابايت) |
تشغيل Kimi K2 Thinking
يُظهر نموذج Kimi K2 Thinking قوة تجميع Thunderbolt 5. إنه نموذج خليط من الخبراء (MoE) بتريليون معلمة مع 32 مليار معلمة نشطة. تم تطويره بواسطة Moonshot AI، وهو يمثل أحدث ما توصلت إليه نماذج الاستدلال مفتوحة المصدر.
ما الذي يجعل Kimi K2 مميزًا:
- البنية: خليط من الخبراء (MoE) بإجمالي 1T معلمة
- المعلمات النشطة: فقط 32B معلمة نشطة لكل استدلال
- نافذة السياق: 256K رمز
- التكميم: INT4 الأصلي للكفاءة
- الحجم على القرص: ~594 جيجابايت (مقابل 1 تيرابايت+ للدقة الكاملة)
import mlx.core as mx
from mlx_lm import load, generate

# تهيئة البيئة الموزعة
world = mx.distributed.init()

# تحميل النموذج (يتم توزيعه تلقائيًا عبر العقد)
model, tokenizer = load("moonshotai/Kimi-K2-Instruct")

# توليد النص
prompt = "Explain quantum computing in simple terms:"
response = generate(model, tokenizer, prompt=prompt, max_tokens=500)
print(response)
نتائج الأداء (4x Mac Studio M3 Ultra):
- إجمالي الذاكرة: 2 تيرابايت موحدة
- استهلاك الطاقة: أقل من 500 واط (مقابل 5,000 واط+ لمجموعة GPU)
- توليد الرموز: تنافسي مع الاستدلال السحابي
- كفاءة التكلفة: طاقة أقل بـ 10 مرات من مجموعة NVIDIA RTX 5090
تحسين الأداء
أفضل الممارسات لطوبولوجيا الشبكة
طوبولوجيا الحلقة (موصى بها لـ 4+ عقد):
┌─────────────────────────────────────┐
│                                     │
│    Mac 1 ←──TB5──→ Mac 2           │
│      ↑                ↓             │
│     TB5              TB5            │
│      ↓                ↑             │
│    Mac 4 ←──TB5──→ Mac 3           │
│                                     │
└─────────────────────────────────────┘
طوبولوجيا النجمة (عقدتان إلى 3 عقد بسيطة):
Mac 2 ←──TB5──→ Mac 1 ←──TB5──→ Mac 3إرشادات الكابلات والاتصال
| العامل | التوصية | التأثير |
|---|---|---|
| طول الكابل | أقل من 2 متر | يحافظ على 80 جيجابت في الثانية كاملة |
| جودة الكابل | معتمد TB5/USB4 v2 | يمنع أخطاء البيانات |
| تجنب المحاور | اتصالات مباشرة | المحاور تقلل السرعة إلى 10 جيجابت في الثانية |
| اختيار المنفذ | استخدم كل المتاح | يزيد النطاق الترددي |
توازن الذاكرة والحساب
عند بناء مجموعة غير متجانسة (أجهزة مختلطة):
# يقوم MLX تلقائيًا بالتوازن بناءً على قدرات الجهاز
# ولكن يمكنك تخصيص التقسيم:

import mlx.core as mx

# الحصول على معلومات العالم الموزع
world = mx.distributed.init()

# تخصيص الوزن المخصص
weights = {
    0: 2.0,  # Mac Studio يحصل على 2x حصة
    1: 1.0,  # Mac mini يحصل على 1x حصة
    2: 1.0,
    3: 1.0
}
استكشاف المشكلات الشائعة وإصلاحها
مشاكل الاتصال
المشكلة: العقد لا تكتشف بعضها البعض
# التحقق من حالة اتصال Thunderbolt
system_profiler SPThunderboltDataType

# التحقق من واجهات الشبكة
networksetup -listallhardwareports

# اختبار الاتصال المباشر
ping mac2.local
المشكلة: سرعات نقل بطيئة
# اختبار عرض نطاق Thunderbolt
iperf3 -c mac2.local -p 5201

# المتوقع: ~9-10 جيجابايت/ثانية لـ TB5
# إذا كان أقل: تحقق من طول/جودة الكابل
أخطاء MLX
المشكلة: "No distributed backend available"
# التأكد من تثبيت MLX بشكل صحيح
pip install --upgrade mlx

# التحقق من إصدار Python (يتطلب 3.12+)
python --version
المشكلة: "Out of memory" في الاستدلال الموزع
# تمكين وضع كفاءة الذاكرة
import mlx.core as mx
mx.metal.set_memory_limit(0.95)  # استخدام 95% من الذاكرة المتاحة

# أو تقليل حجم الدفعة
generate(model, tokenizer, prompt=prompt, max_tokens=100)
تكوين SSH
تأكد من وجود SSH بدون كلمة مرور بين جميع العقد:
# إنشاء مفتاح SSH إذا لزم الأمر
ssh-keygen -t ed25519

# النسخ إلى جميع العقد
ssh-copy-id [email protected]
ssh-copy-id [email protected]
ssh-copy-id [email protected]

# اختبار
ssh mac2.local "hostname"
كفاءة الطاقة وتحليل التكلفة
مقارنة استهلاك الطاقة
| التكوين | استهلاك الطاقة | الأداء | $/الأداء |
|---|---|---|---|
| 4x Mac Studio (512 جيجابايت) | ~500 واط | قادر على التريليون معلمة | الأفضل |
| مجموعة NVIDIA H100 (4x) | ~2,800 واط | قدرة مماثلة | طاقة أكثر بـ 5.6x |
| مجموعة NVIDIA RTX 5090 | ~2,300 واط | VRAM محدودة | طاقة أكثر بـ 4.6x |
التكلفة الإجمالية للملكية (TCO)
مجموعة Mac Studio (تكوين 2 تيرابايت):
- الأجهزة: 47,000 دولار
- الطاقة السنوية (24/7): ~500 دولار
- الصيانة: الحد الأدنى
- TCO لمدة 5 سنوات: ~49,500 دولار
مجموعة GPU مكافئة:
- الأجهزة: 100,000 دولار+
- الطاقة السنوية (24/7): ~3,000 دولار
- البنية التحتية للتبريد: 10,000 دولار+
- الصيانة: كبيرة
- TCO لمدة 5 سنوات: ~130,000 دولار+
حالات الاستخدام والتطبيقات
أبحاث تعلم الآلة
تتميز مجموعة Thunderbolt 5 في أبحاث ML الأكاديمية والشركات:
تطبيقات البحث:
- تدريب النموذج: تدريب موزع عبر أجهزة Mac متعددة مع مزامنة التدرج
- الضبط الدقيق: ضبط دقيق محلي للنماذج الكبيرة على مجموعات بيانات خاصة
- الاستدلال: تشغيل نماذج تريليون معلمة محليًا للتجريب
- دراسات الاجتثاث: النماذج الأولية السريعة دون انتظار توفر GPU السحابي
مثال سير عمل البحث:
import mlx.core as mx
from mlx_lm import load, generate

# تحميل النموذج الذي تم ضبطه بدقة
model, tokenizer = load("./my-finetuned-model")

# تشغيل التجارب عبر المجموعة الموزعة
for prompt in research_prompts:
    response = generate(model, tokenizer, prompt=prompt)
    log_result(prompt, response)
الجامعات ومختبرات البحث تستفيد من:
- تكاليف الأجهزة الثابتة مقابل الفواتير السحابية غير المتوقعة
- خصوصية البيانات الكاملة للأبحاث الحساسة
- الموارد التعليمية لدورات الحوسبة الموزعة
- تجارب قابلة للتكرار وجاهزة للنشر
سير العمل الإبداعي الاحترافي
يوفر التكامل مع النظام البيئي الإبداعي لشركة Apple مزايا فريدة:
إنتاج الفيديو:
- العرض الموزع: مشاريع Final Cut Pro، DaVinci Resolve، Motion
- التحرير بمساعدة الذكاء الاصطناعي: نماذج الذكاء الاصطناعي المحلية للكشف عن المشهد، والنسخ
- تصحيح الألوان: معالجة الألوان المسرعة بواسطة GPU عبر العقد
- معالجة 8K RAW: ذاكرة كافية لملفات الفيديو الكبيرة
الإنتاج الصوتي:
- المعالجة الموزعة في Logic Pro: عرض المكونات الإضافية عبر العقد
- توليد موسيقى الذكاء الاصطناعي: تشغيل نماذج الذكاء الاصطناعي الموسيقية المحلية
- استعادة الصوت: تقليل الضوضاء القائم على ML محليًا
الرسومات ثلاثية الأبعاد والمتحركة:
- العرض الموزع في Blender: عرض Cycles عبر مجموعة Mac
- Cinema 4D: عرض CPU مع دعم المجموعة
- Houdini: توزيع المحاكاة (مع المكونات الإضافية المناسبة)
لمزيد من المعلومات حول سير العمل الإبداعي، راجع دليل ثورة سير العمل الاحترافي في macOS Tahoe.
التطوير والاختبار
يستفيد تطوير تطبيقات الذكاء الاصطناعي الحديثة بشكل كبير من المجموعات المحلية:
تطوير التطبيقات التي تعمل بالذكاء الاصطناعي:
# مثال: بناء روبوت محادثة بالذكاء الاصطناعي مع استدلال محلي
from flask import Flask, request, jsonify
import mlx.core as mx
from mlx_lm import load, generate

app = Flask(__name__)
model, tokenizer = load("llama-3.1-70b")

@app.route('/chat', methods=['POST'])
def chat():
    prompt = request.json['message']
    response = generate(model, tokenizer, prompt=prompt)
    return jsonify({'response': response})
مزايا المطور:
- تطوير LLM المحلي: الاختبار والتكرار دون حدود لمعدل API
- تسريع CI/CD: أنظمة البناء والاختبار الموزعة
- تطوير تطبيقات الذكاء الاصطناعي: بناء تطبيقات مع خلفيات الذكاء الاصطناعي المحلية
- تجارب بلا تكلفة: لا توجد رسوم لكل طلب أثناء التطوير
مزايا الاختبار:
- الاختبار ضد نماذج بحجم الإنتاج محليًا
- لا يوجد تأخير في الشبكة في بيئات الاختبار
- نتائج اختبار متسقة وقابلة للتكرار
- السيطرة الكاملة على إصدارات النموذج
تحقق من دليل إعداد مطور macOS Tahoe لتكوين بيئة التطوير.
سيناريوهات النشر المؤسسي
تقوم المؤسسات الكبيرة بنشر مجموعات Mac من أجل:
مساعدو الذكاء الاصطناعي الداخليون:
- واجهات خاصة بنمط ChatGPT
- تحليل المستندات والتلخيص
- مراجعة الكود وتوليده
- نسخ الاجتماعات وتحليلها
الصناعات الحساسة للامتثال:
- الرعاية الصحية: معالجة الذكاء الاصطناعي المتوافقة مع HIPAA
- التمويل: استدلال النموذج داخل المبنى
- القانون: تحليل المستندات السرية
- الحكومة: قدرات الذكاء الاصطناعي المعزولة (air-gapped)
تحليل التكلفة والفائدة للمؤسسات:
| السيناريو | تكلفة السحابة/السنة | تكلفة مجموعة Mac/السنة | التوفير |
|---|---|---|---|
| خفيف (1M رمز/يوم) | ~11,000 دولار | ~3,000 دولار (مستهلكة) | 73% |
| متوسط (10M رمز/يوم) | ~110,000 دولار | ~15,000 دولار (مستهلكة) | 86% |
| ثقيل (100M رمز/يوم) | ~1.1M دولار | ~60,000 دولار (مستهلكة) | 95% |
مستقبل تجميع Mac
M5 وما بعده
تقدم شريحة Apple M5 مسرعات عصبية في كل نواة GPU، مما يوفر تحسينًا في أداء الذكاء الاصطناعي بمقدار 4 أضعاف. عند دمجها مع تجميع Thunderbolt 5:
- دعم MLX المحسن: الوصول الكامل إلى مسرعات M5 العصبية
- نطاق ترددي للذاكرة المحسن: 153 جيجابايت/ثانية لكل شريحة
- كفاءة طاقة أفضل: المزيد من الأداء لكل واط
الآثار المترتبة على Mac Pro
وفقًا للتقارير، قامت Apple "بشطب Mac Pro إلى حد كبير" داخليًا. يوفر تجميع Thunderbolt 5 مسارًا بديلاً:
- أداء قابل للتطوير: أضف عقدًا حسب الحاجة
- تكلفة دخول أقل: ابدأ صغيرًا، وتوسع لاحقًا
- المرونة: امزج بين طرازات Mac المختلفة
- مستقبل مضمون: قم بترقية العقد الفردية بمرور الوقت
اعتبارات الأمن والخصوصية
لماذا المعالجة المحلية مهمة
واحدة من أهم مزايا تجميع Mac على الذكاء الاصطناعي القائم على السحابة هي خصوصية البيانات الكاملة. لا تغادر مطالباتك وبيانات التدريب والمخرجات المولدة شبكتك المحلية أبدًا.
مزايا الخصوصية:
- لا نقل للبيانات: تحدث جميع المعالجات داخل المبنى
- صديقة للامتثال: سهولة الامتثال لـ HIPAA و GDPR و SOC2
- حماية الملكية الفكرية: تظل البيانات الملكية خاصة
- لا مخاوف بشأن التسجيل: السيطرة الكاملة على سجلات الاستخدام
أفضل ممارسات الأمان لمجموعات Mac:
- عزل الشبكة: حافظ على مجموعتك في شبكة VLAN مخصصة
- تكوين جدار الحماية: حظر الوصول الخارجي إلى منافذ المجموعة
- إدارة مفاتيح SSH: استخدم مفاتيح ed25519، وقم بتدويرها بانتظام
- أمان macOS: قم بتمكين FileVault، وحافظ على تحديث الأنظمة
- الأمن المادي: تأمين الوصول إلى غرفة الخادم
لتكوين أمان macOS الشامل، راجع دليل الأمن والخصوصية في macOS Tahoe.
معايير الأداء الواقعية
مقارنة سرعة الاستدلال
بناءً على اختبارات المجتمع وعروض Apple:
| النموذج | التكوين | الرموز/الثانية | المقارنة |
|---|---|---|---|
| Llama 3.1 70B | 2x Mac mini M4 Pro (64 جيجابايت) | ~35 رمز/ثانية | قابلة للمقارنة بـ RTX 4090 |
| Llama 3.1 405B | 4x Mac Studio (512 جيجابايت) | ~15 رمز/ثانية | يتجاوز A100 السحابي |
| Kimi K2 | 2x Mac Studio (512 جيجابايت) | ~20 رمز/ثانية | أول تريليون معلمة محلي |
| DeepSeek V3 | 4x Mac Studio (512 جيجابايت) | ~12 رمز/ثانية | كان سحابيًا فقط سابقًا |
تحليل الكمون
| المقياس | مجموعة Mac | API السحابي | الفرق |
|---|---|---|---|
| أول رمز | 100-500ms | 500-2000ms | أسرع بـ 2-10 مرات |
| كمون متسق | نعم | متغير | أكثر قابلية للتنبؤ |
| البدء البارد | لا يوجد | 5-30 ثانية | لا انتظار |
| التوفر | 100% (محلي) | 99.9% | لا انقطاعات |
مقارنة التكلفة لكل رمز
بافتراض تشغيل 24/7 على مدار عام واحد:
| الحل | تكلفة الأجهزة | تكلفة التشغيل | إجمالي سنة واحدة | التكلفة/1M رمز |
|---|---|---|---|---|
| مجموعة 4x Mac Studio | 47,000 دولار | ~500 دولار | 47,500 دولار | ~0.02 دولار |
| OpenAI GPT-4 | 0 دولار | حسب الاستخدام | متغير | ~30.00 دولار |
| Claude API | 0 دولار | حسب الاستخدام | متغير | ~15.00 دولار |
| AWS Bedrock | 0 دولار | حسب الاستخدام | متغير | ~10.00 دولار |
بالنسبة للمستخدمين بكثافة (>100M رمز/سنة)، يصبح تجميع Mac المحلي أكثر اقتصادا بشكل ملحوظ.
الأسئلة الشائعة (FAQ)
كم عدد أجهزة Mac التي يمكنني توصيلها في مجموعة؟
الحد العملي يعتمد على الهيكل الخاص بك. مع اتصالات Thunderbolt المباشرة (تجنب المحاور)، يمكنك توصيل 4-6 أجهزة Mac بكفاءة. يسمح استخدام طوبولوجيا الحلقة بالتوسع إلى المزيد من العقد مع الحفاظ على النطاق الترددي الكامل. بعد 6 عقد، ستحتاج إلى تخطيط طوبولوجي دقيق لتجنب اختناقات النطاق الترددي.
هل أحتاج إلى أجهزة Mac متطابقة للتجميع؟
لا، يدعم MLX و EXO المجموعات غير المتجانسة. ومع ذلك، ستكون المجموعة محدودة بأبطأ مكون. للحصول على أفضل النتائج، استخدم أجهزة Mac من جيل مماثل مع إصدارات Thunderbolt متطابقة. سيتم ترجيح توزيع الذاكرة بواسطة ذاكرة الوصول العشوائي المتاحة لكل عقدة.
هل يمكنني استخدام أجهزة Mac Thunderbolt 4 في مجموعة؟
نعم، ولكن سيتم تحديد النطاق الترددي لتلك الاتصالات بـ 40 جيجابت في الثانية. Thunderbolt 5 و 4 متوافقان مع الإصدارات السابقة. سيعمل النظام بالسرعة المنخفضة عند خلط الأجيال. للحصول على أفضل أداء، احتفظ بعقد TB4 كعقد طرفية بدلاً من وضعها في منتصف الحلقة.
ما هو الحد الأدنى من الذاكرة المطلوبة للتجميع؟
يجب أن تتجاوز ذاكرة المجموعة الإجمالية متطلبات ذاكرة النموذج الخاص بك مع بعض المساحة للعمليات. بالنسبة لـ Llama 3.1 70B (نموذج 140 جيجابايت)، تحتاج إلى 3 أجهزة Mac على الأقل بسعة 48 جيجابايت لكل منها (إجمالي 144 جيجابايت). نوصي بمساحة 10-20% فوق حجم النموذج.
هل تجميع Mac مناسب للتدريب أم للاستدلال فقط؟
كلاهما! يدعم MLX التدريب الموزع مع متوسط التدرج عبر العقد. ومع ذلك، فإن الاستدلال هو حالة الاستخدام الأساسية بسبب فوائد تجميع الذاكرة للنماذج الكبيرة. يتطلب التدريب المزيد من الاتصال بين العقد ويكون أكثر حساسية لزمن انتقال الشبكة.
كيف يقارن هذا بحالات GPU السحابية؟
للاستخدام طويل الأجل (أكثر من 6 أشهر من الاستخدام المنتظم)، يعد تجميع Mac أكثر فعالية من حيث التكلفة. أنت تمتلك الأجهزة، وليس لديك رسوم بالساعة، وتحقق أداءً تنافسيًا. للاستخدام العرضي أو التجريب، قد تكون الحالات السحابية أكثر اقتصادا في البداية.
هل يمكنني تشغيل المجموعة 24/7؟
بالتأكيد. تم تصميم أجهزة Mac للتشغيل المستمر. تتمتع أجهزة Mac Studio بشكل خاص بإدارة حرارية ممتازة لأعباء العمل المستمرة. راقب درجات الحرارة باستخدام مراقب النشاط أو sudo powermetrics وتأكد من التهوية الكافية.
ماذا يحدث إذا فشلت عقدة واحدة؟
حاليًا، لا يدعم تجميع MLX التبديل السريع أو تجاوز الفشل التلقائي. إذا انفصلت عقدة، ستفشل المهمة وستحتاج إلى إعادة تشغيلها. لأعباء العمل الحرجة، قم بتنفيذ نقاط التحقق في التعليمات البرمجية الخاصة بك للاستئناف من آخر حالة محفوظة.
هل يمكنني استخدام المجموعة أثناء تشغيل أعباء عمل الذكاء الاصطناعي؟
نعم، ولكن قد يتأثر الأداء. تسمح واجهة EXO بالتشغيل في الخلفية أثناء استخدامك لأجهزة Mac لمهام أخرى. للحصول على أفضل أداء للاستدلال، قلل الأنشطة الأخرى أثناء أعباء عمل الذكاء الاصطناعي الثقيلة.
الخلاصة
يمثل تجميع Thunderbolt 5 في macOS Tahoe 26.2 نقلة نوعية في حوسبة الذكاء الاصطناعي المحلية. من خلال دمج أجهزة Mac متعددة في حاسوب فائق موحد، يمكن للمستخدمين تشغيل نماذج بتريليون معلمة بجزء بسيط من تكاليف مجموعات GPU التقليدية.
المزايا الرئيسية:
- استهلاك طاقة أقل بـ 10 مرات من بدائل GPU
- لا توجد أجهزة متخصصة مطلوبة
- إعداد بسيط مع MLX و EXO
- قابل للتطوير من 2 إلى 6+ عقد
- معالجة ذكاء اصطناعي محلية وخاصة
بالنسبة للمستخدمين المستثمرين في نظام Apple البيئي، قد تبرر هذه الميزة وحدها الترقية إلى macOS Tahoe 26.2. تحقق من دليل تحديث macOS Tahoe 26.2 للحصول على تعليمات التحديث الكاملة.
هل أنت مستعد لتحسين جهاز Mac الخاص بك لأعباء عمل الذكاء الاصطناعي؟ ابدأ بـ دليل إدارة تخزين macOS Tahoe للتأكد من أن لديك مساحة كافية للنماذج الكبيرة.
المصادر
- التعلم الآلي في macOS Tahoe يحصل على تعزيز GPU وتجميع Thunderbolt 5 - Apple Insider، نوفمبر 2025
- يمكنك تحويل مجموعة من أجهزة Mac إلى حاسوب فائق للذكاء الاصطناعي في macOS Tahoe 26.2 - Engadget، نوفمبر 2025
- مجموعة من أجهزة Mac Studio هي مجرد سبب واحد لعدم حاجتنا لـ Mac Pro بعد الآن - 9to5Mac، نوفمبر 2025
- مجموعة الذكاء الاصطناعي: أربعة أجهزة Mac بسعة 2 تيرابايت يمكنها تشغيل النموذج العملاق Kimi K2 Thinking - Heise Online، نوفمبر 2025
- وثائق الاتصال الموزع MLX - مستندات Apple MLX الرسمية
- EXO: شغل مجموعة الذكاء الاصطناعي الخاصة بك في المنزل - GitHub لـ EXO Labs
- استكشف نماذج اللغة الكبيرة على Apple silicon مع MLX - WWDC25 - Apple Developer
- Kimi K2 - Moonshot AI - الموقع الرسمي لـ Moonshot AI